小米发布会亮点全解析:玄戒O3芯片与18 Fold折叠屏(附方案下载)
 广告
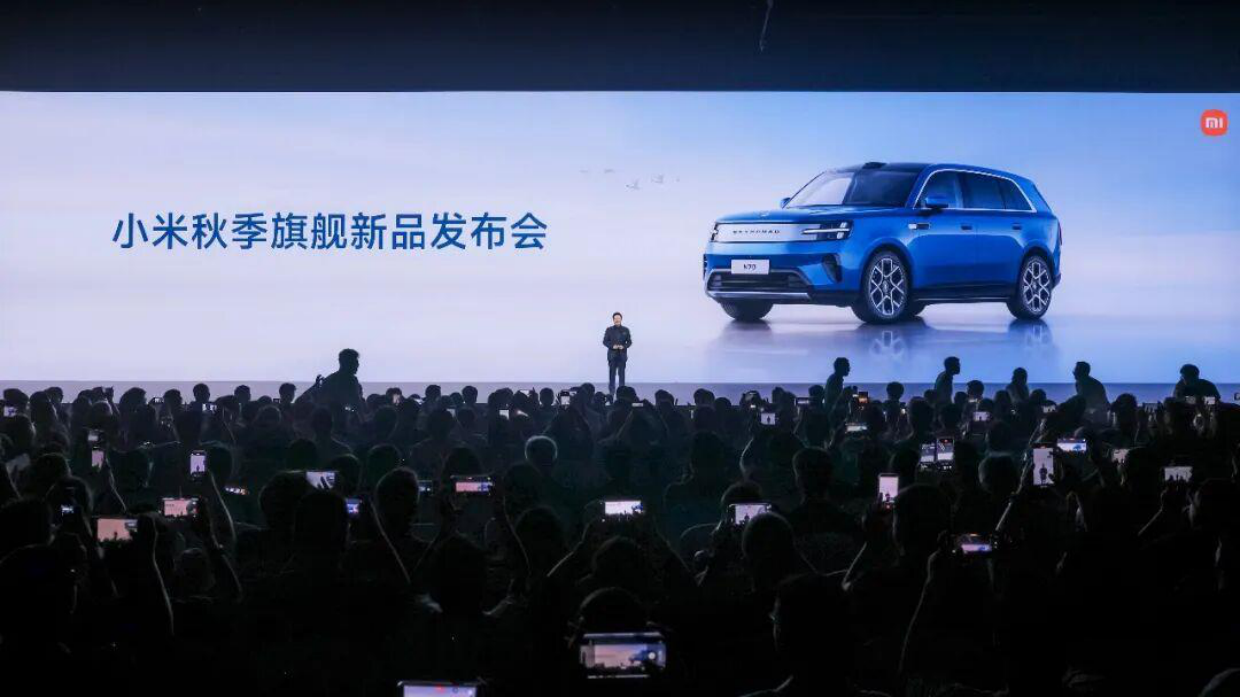
小米这场秋季发布会的信息密度很高:一颗AI旗舰SoC、两条芯片新战线、一款折叠屏,外加一句"十年预计研发投入500亿"。
其中最先被讨论的是玄戒O3(XRING 03)——小米的AI旗舰SoC,用240亿晶体管做出10核全大核CPU与16核G2-Ultra GPU,官方给的数据是CPU多核性能较上代提升60%、中低负载功耗降低25%,GPU性能提升85%、功耗降低64%,NPU张量算力200TOPS。
下面按三条线拆:芯片本身的能力升级、芯片家族的第二条战线、以及终端产品怎么承接。
玄戒O3:240亿晶体管怎么分配
方案对玄戒O3的定位是"小米AI旗舰SoC",三个关键组成是10核全大核CPU、16核G2-Ultra NX GPU、原生大模型NPU架构,整个平台被称为"AI inside全模块加速"。
"全大核"这个架构选择值得注意。手机SoC通常用"超大核+大核+小核"的三丛集设计,为的是在性能和功耗之间找平衡;而全大核意味着放弃了小核兜底的省电路线,改用调度策略和制程优势去控制功耗。方案给出的结果数据是"中低负载功耗降低25%"——这正是在回应全大核架构最大的质疑:日常轻度使用时会不会更费电。
GPU这边是16核的G2-Ultra NX,性能提升85%、功耗降低64%,两个数字同时出现,说明这一代的能效比改善幅度比绝对性能更大。对用户来说,能效提升比跑分提升更有感知——它直接对应发热和续航。
NPU与大模型:200TOPS算力往哪用
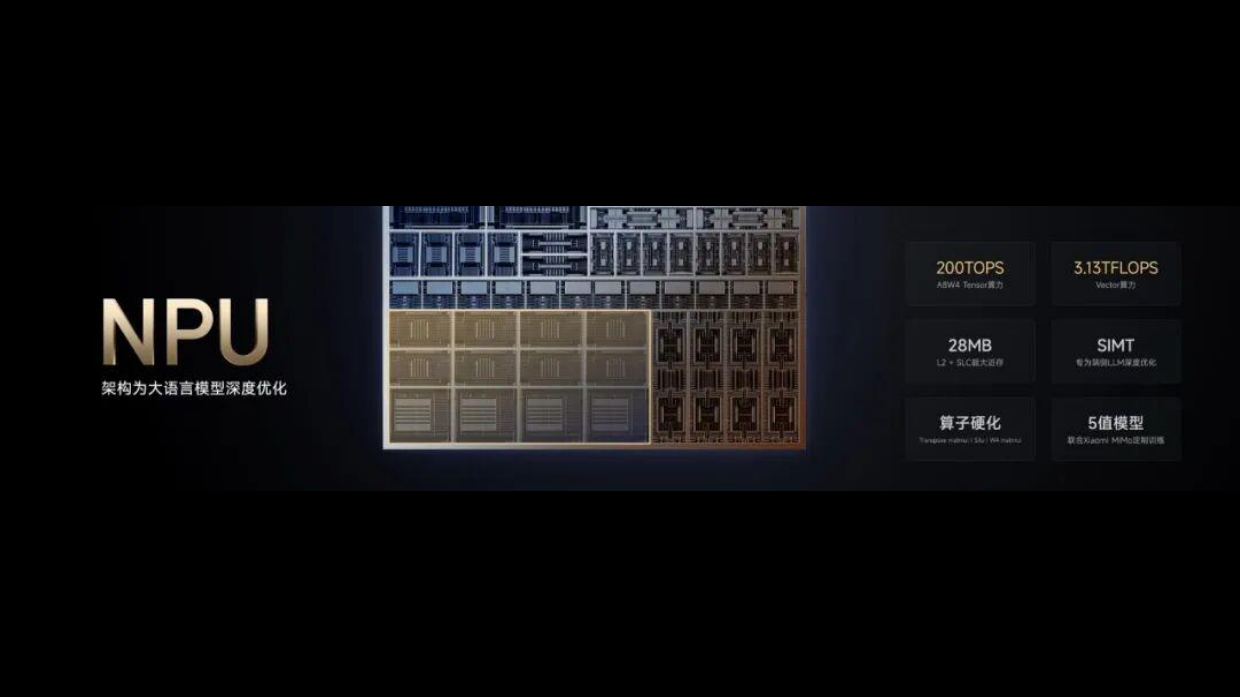
方案里NPU部分的信息量最大:张量算力200TOPS、向量算力3.13TFLOPS、28MB SLC缓存,采用SIMT架构,明确写着"为大语言模型深度优化"和"算子硬化"。
"算子硬化"是理解这一代NPU的关键。大模型推理要跑大量重复的算子,如果全靠通用算力软执行,效率低还费电;把高频算子做成硬件电路,就是用面积换能效。方案里单独列出的28MB SLC(系统级缓存)也是同一个思路——模型权重和中间结果尽量不出片外内存,减少搬运就减少了功耗。
顺着这个思路往下推,《抖音教育开学季大促策略拆解:中正价打法如何撬动秋季增长》给了一套可以直接抄的框架。
再往下一层是芯片与模型协同的优化。方案提到玄戒与Xiaomi MiMo的配合,做法包括5值模型、硬件雷夫曼无损压缩、INT4到16值的定制训练模型,最终推理效果等效于4bit量化模型,而平均位宽只有2.6bit,对应的收益是三项数据:提升40%、提升45%、降低30%。把"用更少的位宽达到同样的效果"讲清楚,比单纯堆算力更能说明端侧AI的真实水平——毕竟手机的内存带宽和电池都有限。
方案还提到一个细节:玄戒O100原型机内置Xiaomi MiMo、采用风冷主动散热,具备超强散热能力。这条信息说明端侧跑大模型对散热的要求已经高到需要主动风冷的程度——端侧AI的瓶颈从来不只是算力,还有散热和功耗。
玄戒O100与D100:芯片家族的第二条战线
除了手机SoC,这场发布会还放出了两款芯片,方向各不相同。
玄戒O100的关键词是"全球首款6nm 3D晶圆级堆叠"(Wafer On Wafer),目标是实现数据的垂直高速传输。工艺细节方案给了两条:混合键合工艺和微凸点工艺,并且提到"间距逼近物理极限"。堆叠这条路的意义在于,当平面微缩越来越难、成本越来越高时,向垂直方向要密度就成了另一条路。
玄戒D100则被定位为"国内首款3nm高算力智驾芯片",规格是高达20核高性能CPU、16核高算力NPU、最高160GB统一内存,支持200B模型本地运行。这几个数字放在一起,指向的是车端算力平台的定位——200B模型本地运行意味着智驾和座舱的大模型可以放在车上跑,不必依赖云端,这对延迟和隐私都是实质改善。
方案明确写了"玄戒O3、玄戒O100、玄戒D100已完成研发和测试验证",把三款芯片放在同一页并列,本身就是一次能力证明:手机、通用算力、车规三条线同时推进,说明这不是一次单点突破。
关于投入,方案给了一句直接的表述:"小米造芯,做好长期坚持的准备,十年预计研发投入500亿",并配上"只要开始追赶,我们就走在赢的路上"。500亿和十年这两个数字放在一起,是把预期管理提前做了——造芯是个长周期生意,讲清楚时间尺度比讲参数更重要。同一类打法,我们在《疯狂的麦咭招商方案拆解:AI密室如何让老牌综艺焕新招商》里拆得更细,可以对照着看。
如果你希望获取更多各行业方案与拆解参考,也可以前往运营动脉(www.yydm.cn),平台内置精品方案库、报告库、课件库、模板库,7W+精选资料并且每月更新1000+份,非常适合运营人查找专业素材。
小米18 Fold:折叠屏的厚度与显示升级
发布会的终端落点是小米18 Fold,方案给的规格是:外屏5.38英寸、内屏7.58英寸,展开厚度5.02毫米、闭合厚度10.68毫米、整机重量219克,展开高度163.8毫米、展开宽度117.8毫米。
显示参数上:外屏1712×1168,采用LIPO极窄四等边;内屏2364×1672,采用Pol-less去偏光片技术、超级像素全RGB像素排列,支持LTPO 1-120Hz刷新率、4000nits超级阳光屏,以及专业原色屏和小米多屏同色;影音认证包括Dolby Vision和HDR Vivid。Pol-less去偏光片和全RGB排列这两个点,都是为了让折叠屏在透光率和清晰度上向直板机看齐。
形态价值上,方案用两组占比数据做了对比:看3:2照片时,屏幕内容占比93.3%,传统大折叠是74.1%;看16:9长视频时,内容占比78.8%,传统大折叠是62.5%。这种"接近方形"的内屏比例,本质是在解决大折叠"屏幕大但黑边也大"的老问题。
交互部分,方案提到键盘比6.9英寸直板机宽8%,打字更舒展不易误触;支持三窗口应用分屏(2:1、2:1比例),方案的原话是"相当于三台直板并排使用",最多支持6个应用并排运行;还有"超级小爱灵感球",支持一句话指哪问哪、导航、修图。把"多窗口"和"宽键盘"单独拿出来讲,说明这一代折叠屏把生产力场景当成了核心卖点。
可靠性怎么解决:转轴、玻璃与折痕
折叠屏绕不开的三个问题是折痕、耐摔、耐用。方案在这三块都给了具体数据。
转轴是小米龙骨转轴,采用专利三级连杆结构,方案形容为"自然水滴形态,转轴周全保护"。中框用高强度7系铝合金,双面为小米龙晶玻璃3.0,外屏做了离子注入强化。
屏幕结构用双层UTG超薄玻璃:表层50微米UTG玻璃做加厚设计,可靠性较上代提升178%;内层30微米UTG玻璃提供硬性支撑,抗冲击性再提升29%。配合内屏、转轴、主板、结构件的设计优化,整机跌落高度做到1.2米,尖锐物品抗冲击性较上代提升258%,钢球重物跌落高度较上代提升214%。
折痕方面的数据是平均折痕深度小于等于30微米。这一组数字比"用了多先进的材料"更有说服力——折叠屏用户最真实的顾虑就是"摔了会不会坏""用久了会不会有印子",直接给测试数据是回应顾虑最有效的方式。
另外还有两处供应链信息:小米与长鑫存储率先量产国产LPDDR6,以及小米金沙江电池6000mAh,采用双叠片电池、20%高含硅量、能量密度920Wh/L。前者是国产存储的进展,后者直接决定折叠屏的续航表现。
常见问题解答
全大核CPU会不会更费电?
这正是方案要回答的质疑。它给的答案是"中低负载功耗较上代降低25%",也就是在日常轻度使用场景下反而更省电。原理上,全大核通过让所有核心都跑在高能效区间、配合更精细的调度来省电,而不是靠小核牺牲性能换续航。当然实际表现还要看整机调度策略,但至少从官方数据看,这一代是在试图消解"全大核等于费电"的印象。
端侧大模型的算力是不是已经够用了?
算力只是其中一环。这份材料的价值在于它同时讲了另外两个瓶颈:一是带宽,所以要有28MB SLC缓存和LPDDR6;二是散热,所以原型机用上风冷主动散热。再加上5值模型、平均位宽2.6bit这类压缩手段,本质都是在"算力有限的前提下把模型塞进手机"。判断端侧AI好不好用,不只看TOPS数字,还要看压缩后的推理效果和发热控制。
3D晶圆级堆叠和传统的芯片堆叠有什么区别?
关键在"键合"方式。方案提到玄戒O100用混合键合与微凸点工艺,并强调"间距逼近物理极限"。传统封装靠焊球或凸点连接,间距做不小、信号传输距离长;晶圆级堆叠把两片晶圆直接键合,能把连接密度做高、传输路径缩短,从而实现数据垂直高速传输。这也是为什么它被列为"全球首款6nm 3D晶圆级堆叠"的原因——难点不在堆叠这个动作,而在工艺精度。
折叠屏的折痕问题真的解决了吗?
从数据看是显著改善,但不是消失。方案给的是"平均折痕深度小于等于30微米",同时配合双层UTG玻璃和三级连杆转轴来分散弯折应力。30微米大约是头发丝直径的三分之一,肉眼在特定角度仍可能看到痕迹。更值得关注的是配套的可靠性数据——抗冲击提升258%、钢球跌落高度提升214%,这些说明厂商把重心放在了"用久了会不会坏"上,因为对折叠屏来说,寿命和耐摔比折痕的视觉完美度更影响购买决策。
延伸阅读
这几篇方案拆解和本文互为补充,看完能拼出更完整的一张图。
《拆解理想汽车2025传播方案:智驾+座舱+AI三线怎么打的》——一份242页的理想汽车2025年度传播策略方案,从智能驾驶、智能座舱到理想同学AI助手,三条并行战线全链路覆盖。
《拆解白鹤湖玩水节方案》——一份白鹤湖文旅景区的五一玩水节活动方案,主题
《全民AI养成季拆解:数字员工体验活动怎么设计》——同一个大话题下的另一条支线
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。