AI基础设施自建还是上云:248张B200卡的五年账
 广告
AI 基础设施到底该自己买还是租,这份报告给了一个可以算的数字:同样 248 张 B200 显卡,自建三年花 2605 万美元,上云最便宜的方案要 7153 万美元。
差距不是百分之几十,是 3.5 倍以上。报告的作者是长期研究 HPC 基础设施经济学的分析师,测算由 Penguin Solutions 出资,硬件报价也由 Penguin 提供,云端用的则是三家云厂商公开的定价工具。
五年口径下,自建全系统 2921 万美元,云上落在 1.19 亿到 1.67 亿美元之间。
这笔账的答案偏向自建,但前提是你真的能把这批卡用满。
下面按假设、配置、四个方案、结论和决策边界,逐层拆开。
图源:《2026AI基础设施真实成本》(第1页) · 原文
一、先算清这笔账到底比的是什么
报告的问题意识很单纯:很多企业已经把 AI 从实验推到了生产,钱花得越来越大,这时候基础设施放在哪就成了真问题。
作者先给了市场规模做背景。按 IDC 数据,2025 年全球 AI 基础设施市场(只算 AI 硬件,不含机房租)达到 3180 亿美元,是 2024 年 1530 亿美元的两倍多,而且预计短期内不会减速。
但市场大不等于决策容易。作者说,企业现在纠结的不是「要不要上 AI」,而是「用什么方式把算力装进来」:往现有数据中心加服务器和 GPU,还是去公有云租。
对比之所以难做,是因为云端价格完全公开,本地的完整企业级报价却很难拿到。没有真实报价,所谓对等比较基本靠猜。这份报告要解决的正是这个信息不对称。
作者用了一个很生活化的比喻:去一个城市待一周就订酒店,住一年就租公寓,长住就买房。

图源:《2026AI基础设施真实成本》(第2页) · 原文
二、这个比喻不严谨,所以必须把假设写死
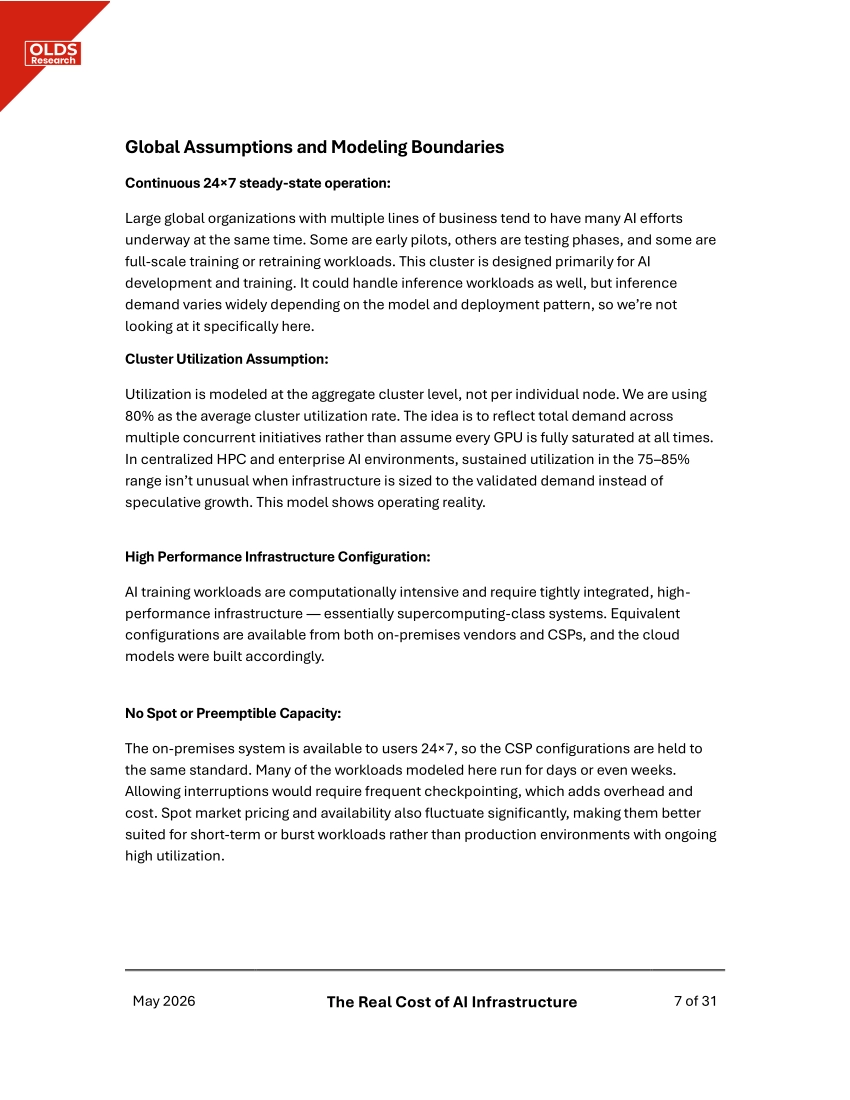
报告特别声明,比喻不是分析。所以它把所有假设逐条列了出来,方便读者自己代入。第一个假设是稳态运行。集群按 7×24 小时不间断运转设计,主要服务 AI 开发与训练,也能承担推理,但推理需求随模型和部署方式变化太大,不单独测算。
第二个是利用率。模型按集群整体 80% 的平均利用率计算,理由是成熟企业在多个业务单元同时推进 AI 项目,总需求撑得起这个水平。报告说,在按验证过的需求而不是投机增长来规划的环境里,75% 到 85% 的持续利用率并不罕见。
第三个是不用抢占式实例。本地系统 24 小时对用户开放,云上就必须对齐同样的标准。很多训练任务一跑就是几天甚至几周,允许中断就得频繁做检查点,反而增加开销。
第四个是三年承诺价。承诺期定价能提高可预测性、降低成本,部分紧俏的 GPU 实例甚至只以预留方式提供。

图源:《2026AI基础设施真实成本》(第3页) · 原文
三、这份模型刻意不算什么
报告用一整页列了边界,这部分比很多咨询报告写得诚实。不算软件和应用许可,只算基础的系统管理软件;不算托管服务,因为可变性太大,但本地方案包含五年故障维修服务,云端的硬件支持本来就在服务里。
不算财务处理差异。资本支出和运营支出的折旧节奏、税务处理都没有纳入,这也是很多 CFO 拿到报告后会自己再算一遍的地方。
不算未来的价格变化。所有价格都取自 2026 年一季度的公开数据,也不假设重新议价、降价或硬件换代。
为什么要算五年而不是三年?报告的解释是,主流云厂商自己已经把服务器折旧年限延长到五年,本地方案也包含五年保修,两边对齐才公平。
把不算的东西写清楚,比把结论喊得响更有说服力。
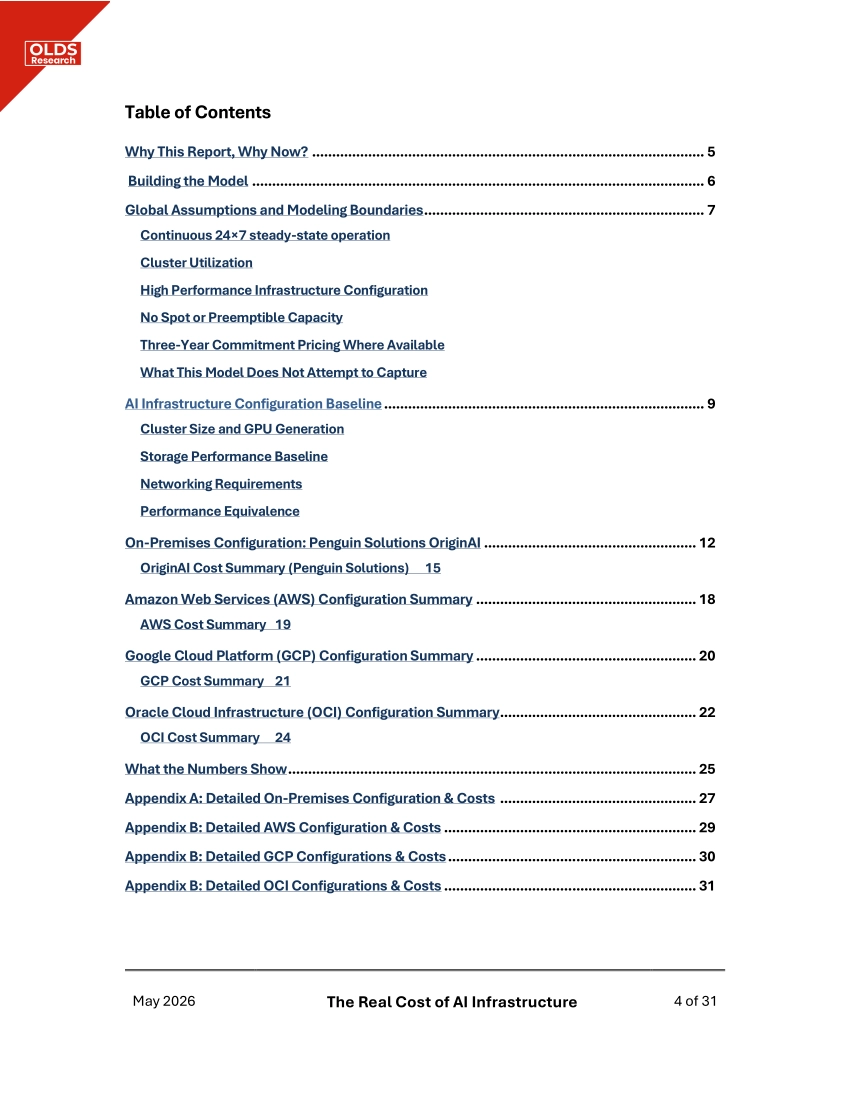
图源:《2026AI基础设施真实成本》(第4页) · 原文
四、四个方案,硬件配置要对齐
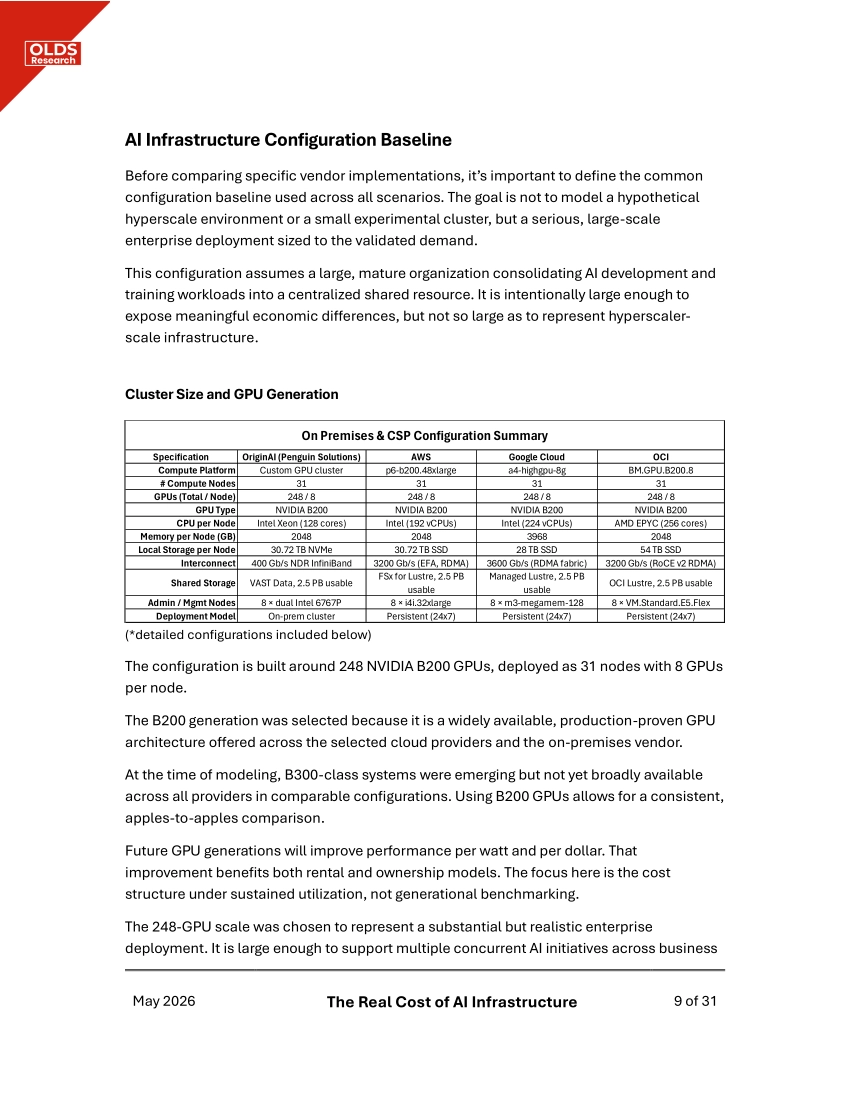
基线是 248 张 NVIDIA B200,部署成 31 个节点,每节点 8 张卡。选 B200 的理由是这一代产品在三家云和本地供应商都能拿到,适合做苹果对苹果的比较,不至于因为代际差异让结论失真。
本地方案由 Penguin Solutions 提供,型号 OriginAI。31 个 GPU 节点,每节点双路 Intel Xeon、2 TB 内存、30.73 TB NVMe,节点间用 400 Gb/s 的 NDR InfiniBand 互联,采用无阻塞全冗余拓扑。AWS 用 31 台 p6-b200.48xlarge,Google Cloud 用 31 台 A4-highgpu-8g,Oracle 用 31 台 BM.GPU.B200.8。三家都用 x86 CPU 搭配 B200,节点数、GPU 数、存储容量和互联带宽全部对齐。
存储统一按 2.5 PB 可用容量、约 250 MB/s per TiB 的性能档位配置。本地是 VAST Data 横向扩展存储,读 600 GB/s、写 384 GB/s,云上分别用 FSx for Lustre、Managed Lustre 和 OCI Lustre,架构不同但都按同一性能包络划定。
微软 Azure 没进清单,原因是调研期间没有提供 x86 加 B200 的对应实例,不能强行比较。小而专的 AI 云厂商也没算,理由是体量小、进入市场时间短,价格代表性不足。
图源:《2026AI基础设施真实成本》(第5页) · 原文
五、本地这台机器,钱花在哪
本地方案的硬件资本投入是 2130.8 万美元,其中 GPU 节点 1883.3 万美元,管理节点 33.7 万美元,存储硬件 213.8 万美元。报价里已经包含机架、布线、集成交付和五年延长保修。
运营成本每年 157.96 万美元,四项构成很清晰:电费 58.76 万美元,VAST 存储软件订阅 35.4 万美元,集群管理软件 12.8 万美元,三名运维人员 51 万美元。
电费这笔账报告算得很细。实测满载 IT 负载 538 千瓦,按 80% 利用率折成 430 千瓦,乘上空冷场景 1.3 的边际 PUE 得到 559 千瓦,一年 876 小时基准下用电 489.7 万千瓦时,按每度 0.12 美元算出 58.76 万美元。
人员配置是一名资深集群与 AI 架构师,年薪 26 万美元,加两名运维工程师各 12.5 万美元,合计每年 51 万美元。合计三年 TCO 2604.7 万美元,五年 TCO 2920.6 万美元。第一年因为把硬件全额计入,数字是 2288.8 万美元,之后每年只增加 157.96 万美元的运营支出。
自建的钱几乎全压在开头的硬件上,后面的运营费用反而是小头。

图源:《2026AI基础设施真实成本》(第6页) · 原文
六、三家云,三套价格逻辑
AWS 是唯一提供专用实例(Dedicated Instances)的云厂商,硬件隔离、性能更可预测,这是它的优势,但报告也承认这个优势很难量化。AWS 没有公布 B200 的三年预留价,报告按上一代 GPU 实例的按需价与三年预留价差额,推算出 26.55% 的折扣,这个数是估算,真实企业协议会浮动。
Google Cloud 提供不了专用主机,只能走共享实例,但它的三年承诺使用折扣是官方公布的真实价格,不是估算。配置上每个 GPU 节点内存接近 4 TB,比本地和 AWS 高一倍左右。
Oracle 也不提供专用主机,同样不公布多年度承诺价,报告按企业谈判惯例给了 15% 的估算折扣,存储则按公开标价计算,不做任何折扣。
三家都默认配置三名云运维人员,年成本同样 51 万美元。报告的观点是,上云并不消灭运维责任,只是把运维换了一种形式,架构、成本管理和监控一样都不能少。
图源:《2026AI基础设施真实成本》(第7页) · 原文
七、五年总账:差在哪一栏
把四个方案放在一张表里,量级差别立刻就能看出来。三年口径,本地 2604.7 万美元,Google Cloud 7153.1 万美元,AWS 9420.7 万美元,Oracle 1.0011 亿美元,云上平均比本地贵 3.5 倍以上。
五年口径,本地 2920.6 万美元,Google 1.1922 亿美元,AWS 1.5701 亿美元,Oracle 1.6685 亿美元,差距最大的是 Oracle,接近 5.7 倍,最便宜的 Google 也是四倍出头。拆开看更明显。AWS 五年总成本里,GPU 实例一项就是 1.2045 亿美元,占了七成多。Oracle 的 GPU 实例五年 1.2926 亿美元,比本地整台机器的 2920 万美元高出一个量级。
存储反而是个被忽略的项。AWS 的 FSx for Lustre 五年 3230 万美元,和一张 GPU 节点订单同一量级,这一项在很多自建方案里根本不会出现。
差距不在运维,在 GPU 那一栏:租金是按小时计的,硬件是按次买的。

图源:《2026AI基础设施真实成本》(第8页) · 原文
八、电费不是关键变量
报告专门提醒了一个常见误区:新闻里天天讲 AI 数据中心耗电,但在这份 TCO 里,电和冷却只占本地总成本的 7% 到 10%。按三年直线折旧,硬件占 82%,电费占 7%;按五年直线折旧,硬件占 73%,电费占 10%。
所以报告给了一个很硬的说法:就算电价上涨 50%,对这份研究的结论也几乎没有影响。这条判断对做预算的人有直接用处。与其纠结 PUE 是 1.25 还是 1.4,不如先把 GPU 的采购价格和利用率谈明白,那才是量级差所在。
报告还顺带提到一个实操技巧:大型数据中心里往往有大量还在通电、占着面积却几乎没人用的「幽灵系统」。先做一次资产盘点把它们下掉,腾出电力和空间,往往比直接去找托管机房划算。
在 AI 集群的成本表里,电费是小数点后的事,硬件和利用率才是小数点前的事。
图源:《2026AI基础设施真实成本》(第9页) · 原文
九、什么时候该买,什么时候该租
报告没有一边倒,它明确说如果需求假设变了,数字会变,决策也可能跟着变。第一个判断条件是需求形态:稳定、持续、可预测的需求会把经济账推向自建,波动大、有峰谷的需求更适合租。
第二个是利用率门槛。报告给出的经验值是:利用率超过 60%,成本天平明显偏向自建;如果需求每年增长 50%,就会滑向云端,除非本地还有余量可以吸收。
第三个是时间维度。云上的三年合同期内配置是冻结的,除非合同里另有条款,GPU 不会被升级。想换新卡,得重新付钱。
第四是隐性成本。云厂商可以谈判,本地供应商也可以谈判,报告说这种价差一直存在,也一直会存在,比较时要把两边的议价空间放在同等位置上。
这类报告的原文件,运营动脉(www.yydm.cn)收得比较全,按行业分好了类,翻起来不费劲。
想核一个具体数字,或者补一张原图,直接搜报告名就能定位到相应的那一页。
报告最后一句把话说得很直:这些决策本质上不是技术问题,而是买还是租的经济学问题。
决定这笔账的从来不是云好不好,而是你的卡能不能一直跑在路上。
十、这份报告能拿来做什么
它最实用的不是结论,而是那套可以照搬的测算框架:先定工作负载,再定利用率,再把存储、网络、人员和电力逐项补齐,最后做三到五年累计。
需要提醒的是利益关系。分析师本人写的报告,测算由 Penguin Solutions 出资,本地硬件价格也由 Penguin 提供,云端价格则来自公开工具。方法透明,但结论方向与出资方一致,读的时候要把这一点放在心里。
另外,报告明确不算折旧、税务和融资成本。如果用自有资金、看重现金流,这些年化后的差异还要再算一遍。真正的决策变量仍然是那两个:需求有多稳,利用率有多高。报告已经把标尺递过来了。
完整版含四家方案的逐项明细表和附录配置清单,都放在运营动脉(www.yydm.cn)上,搜报告名就能翻到原表核对。
别急着抄结论,先把自己的利用率和三年需求曲线画出来,答案自然浮现。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。