WorkBuddy进阶怎么用?先懂原理,再省Token
 广告
WorkBuddy 进阶到底该怎么走?先把一个认知摆正。
大多数人卡住的地方不是不会操作,而是把大模型当成了"能理解你意思的助手"。
实际上它是一个基于概率的下一个 Token 预测器。不懂这一点,指令写得再长也没用。
这份《WorkBuddy 进阶手册》共 4 篇 16 章,从底层原理讲到方法教程、实战应用和资源生态。

来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
它给了两条读法:想系统学,按"导读、底层原理、方法教程、实战应用、资源生态"顺序读。
想马上解决问题,就直接翻对应章节——遇到什么翻什么。
一、WorkBuddy 进阶的分水岭:它在预测下一个词
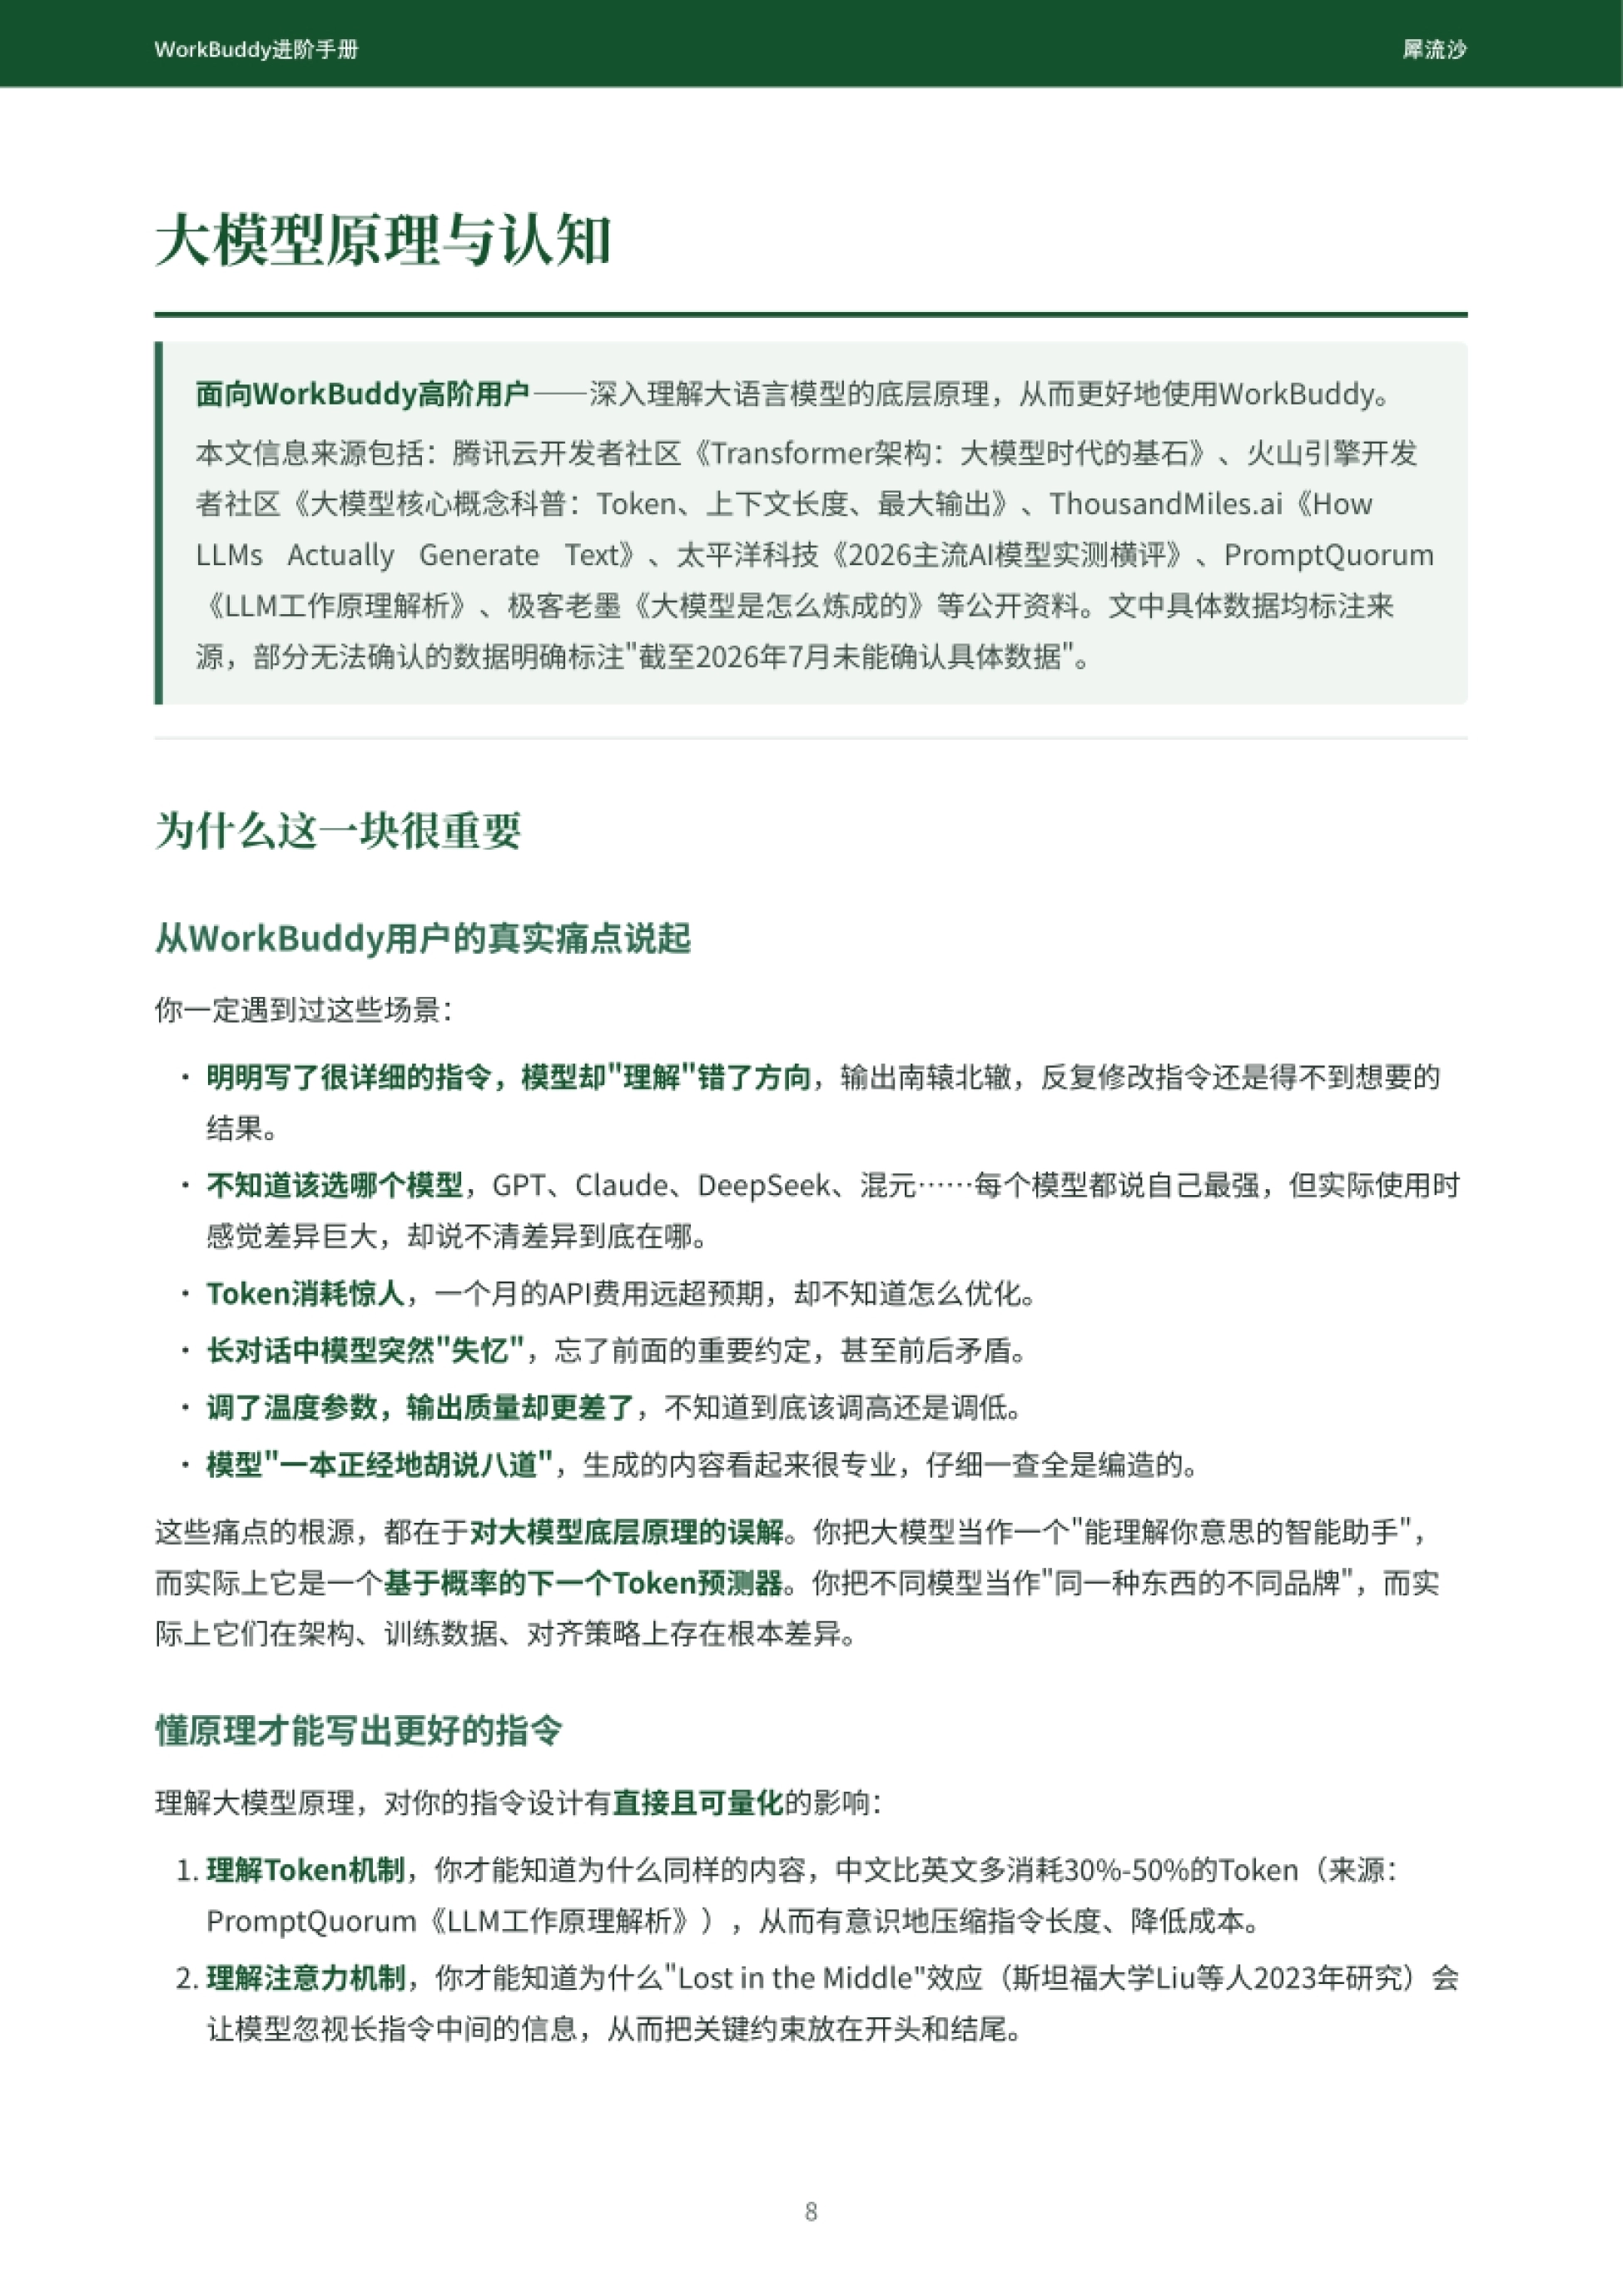
手册开篇就列了用户的真实痛点,几乎每条都撞在同一个根源上。
指令写得很详细,模型却理解错方向;不同模型的差评理由五花八门,却说不清差在哪。
Token 消耗远超预期;长对话里模型突然"失忆";调了温度,输出反而更差。
还有那个最典型的:模型一本正经地胡说八道,看着挺专业,一查全是编的。
来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
根源在于模型处理的是 Token 序列的概率分布,不是语义理解。
它是逐 Token 生成的,没有全局规划——不知道自己接下来要说什么,只知道下一个词最可能是什么。
所以让它写长结构化内容,后半段特别容易跑偏。
对策很直接:在指令里提前给出结构框架,相当于给每一步的局部预测补上全局线索。
理解了这一点,"为什么我写得这么清楚它还错"这个问题就解开了大半。
二、Token 是钱:中文比英文多烧三到五成
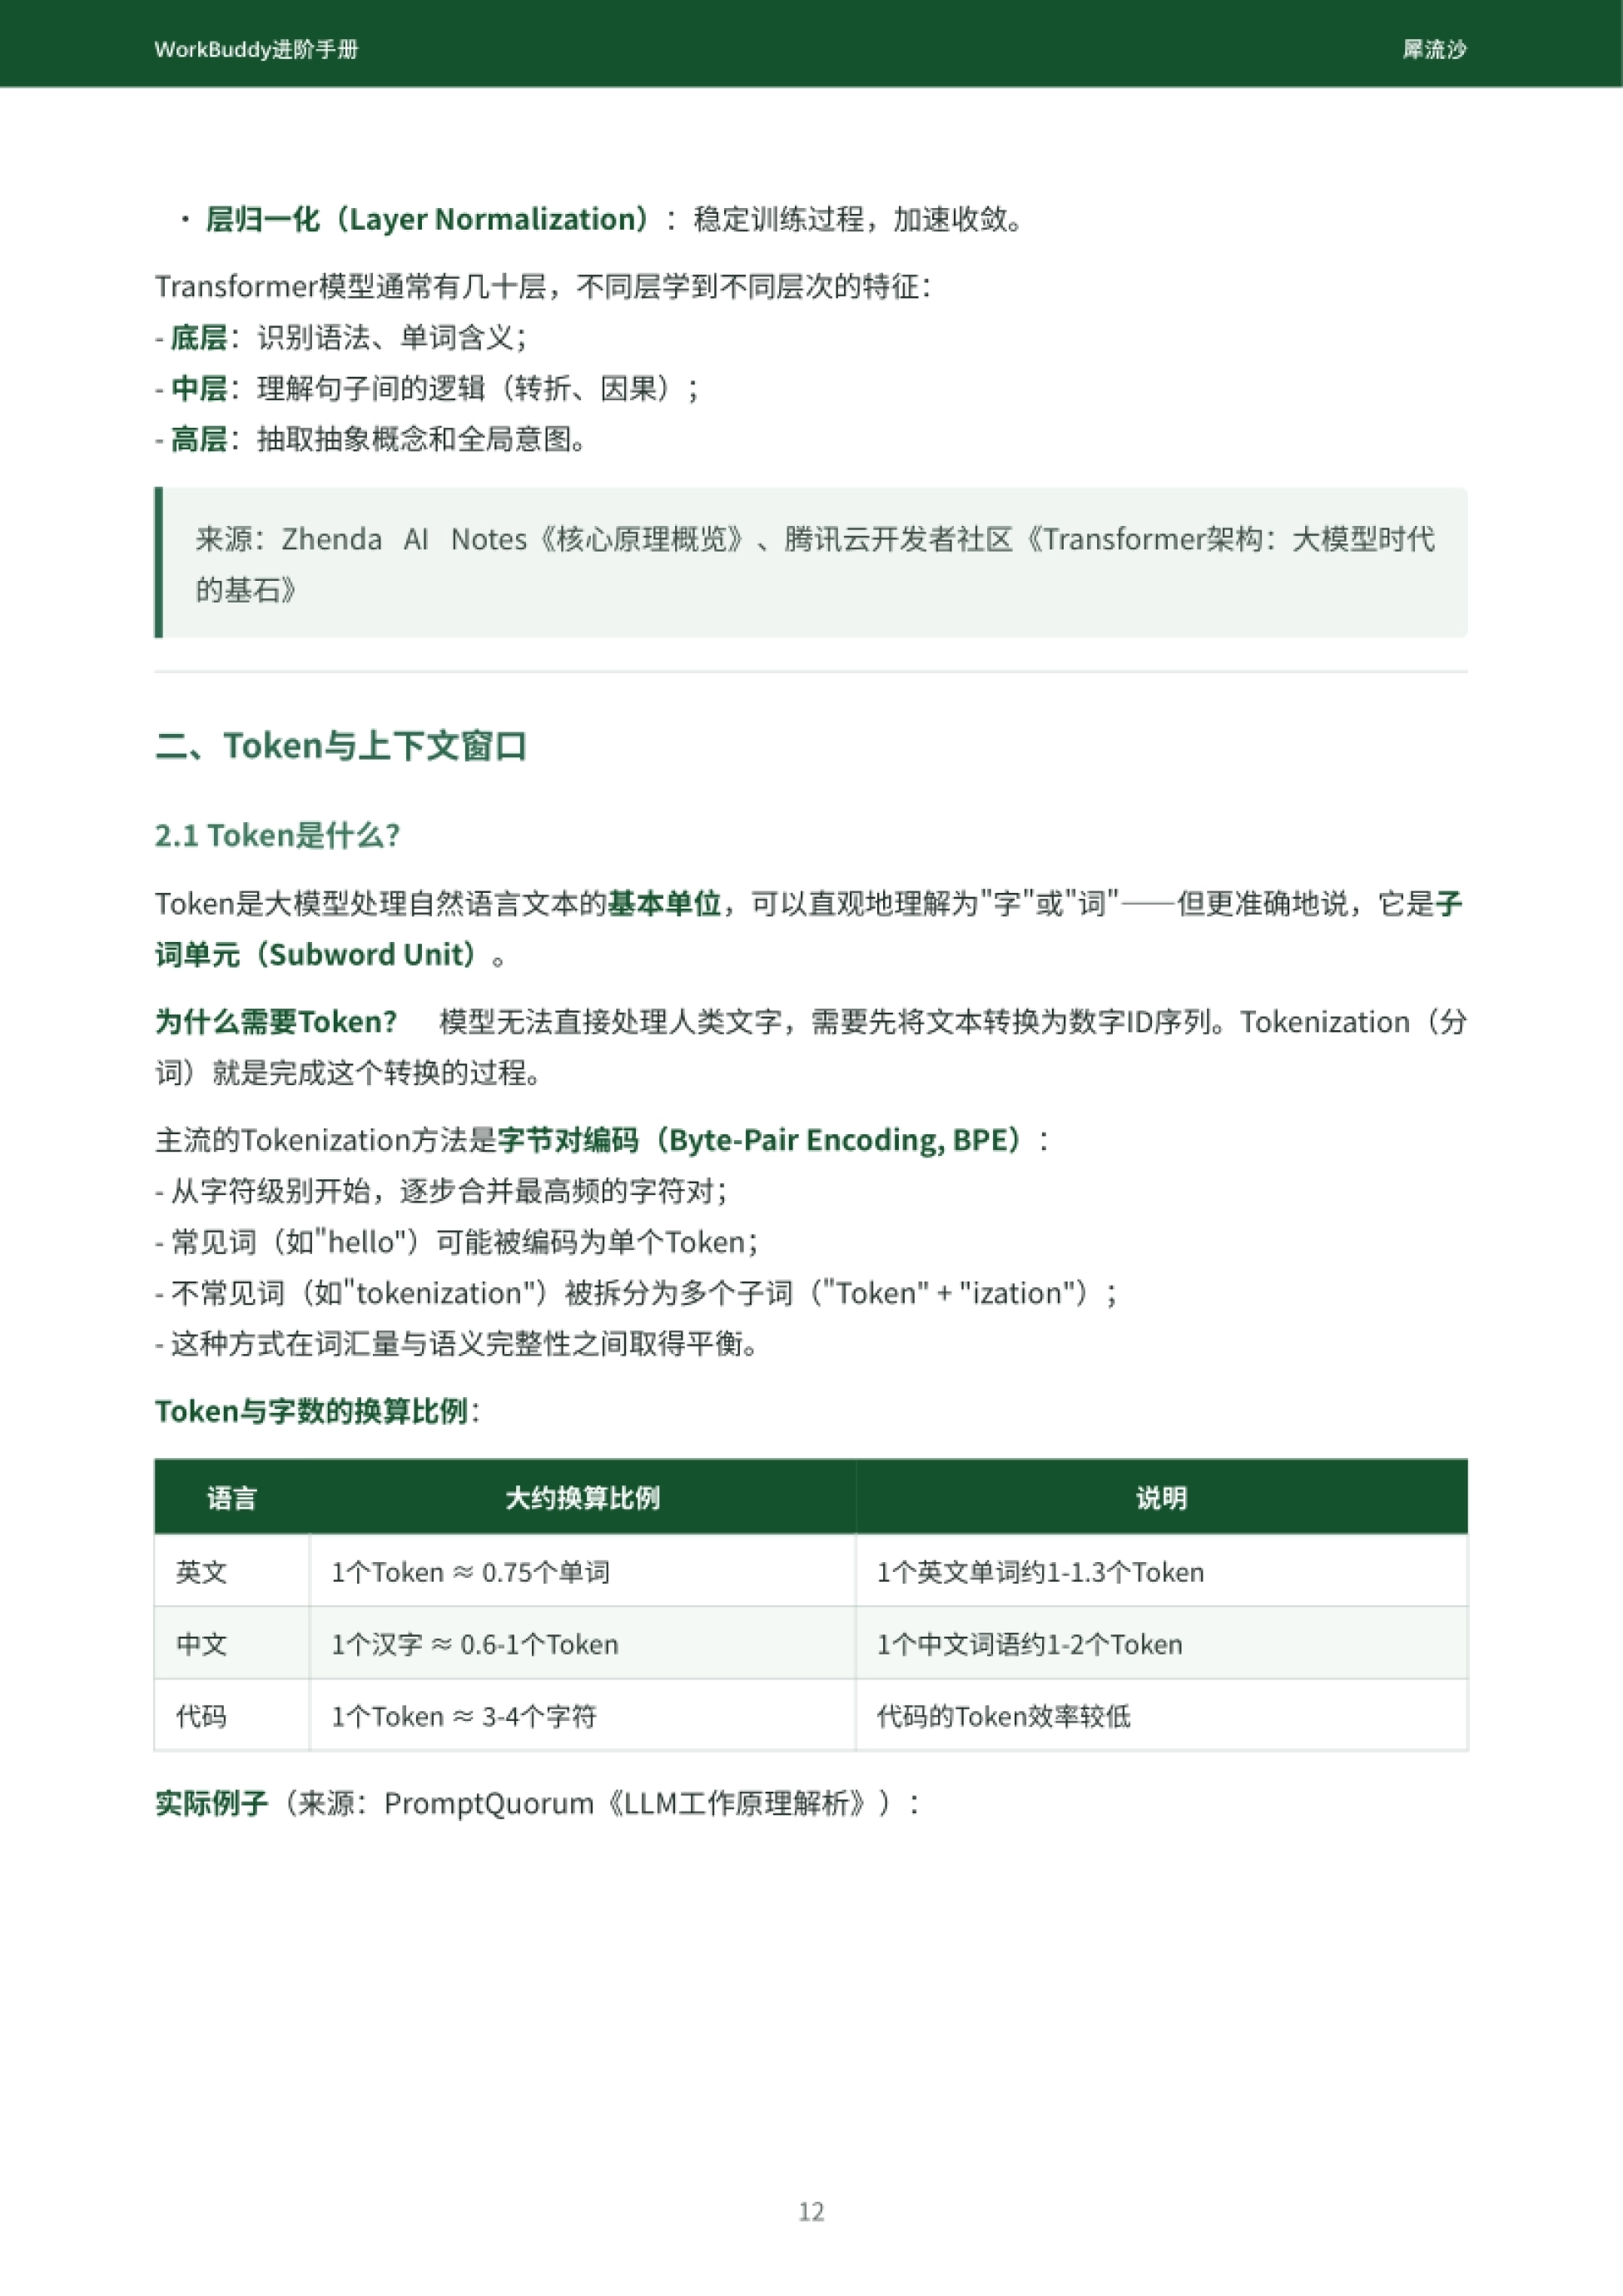
Token 是模型的计费单位,也是上下文窗口的计量单位。它的换算关系得先记住。
英文大约 1 个 Token 对应 0.75 个单词;中文 1 个汉字约 0.6 到 1 个 Token。
代码效率更低,1 个 Token 只对应 3 到 4 个字符。
落到实际:1000 个汉字大约等于 1000 到 2000 个 Token,具体看模型。
来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
成本公式不复杂:单次成本等于(输入 Token 数乘输入单价,加上输出 Token 数乘输出单价)再除以一百万。
手册举了个例子:用输入 5 美元、输出 15 美元每百万 Token 的模型,输入 2000、输出 1000,一次成本约 0.025 美元。
更值得注意的是:同样的内容,中文比英文多消耗 30% 到 50% 的 Token(来源:PromptQuorum)。
这也解释了为什么有的模型便宜——Qwen3 的中日韩 Token 效率比 GPT 高约 40%,中文 API 成本能低四成。
三、温度怎么设:一张表照抄就行
温度是在 Softmax 之前把 logits 除以 T,只改一步,效果巨大。
它的作用是控制随机性,不是控制智商。温度高不会让模型更聪明,只会让输出更多样、也更不可靠。
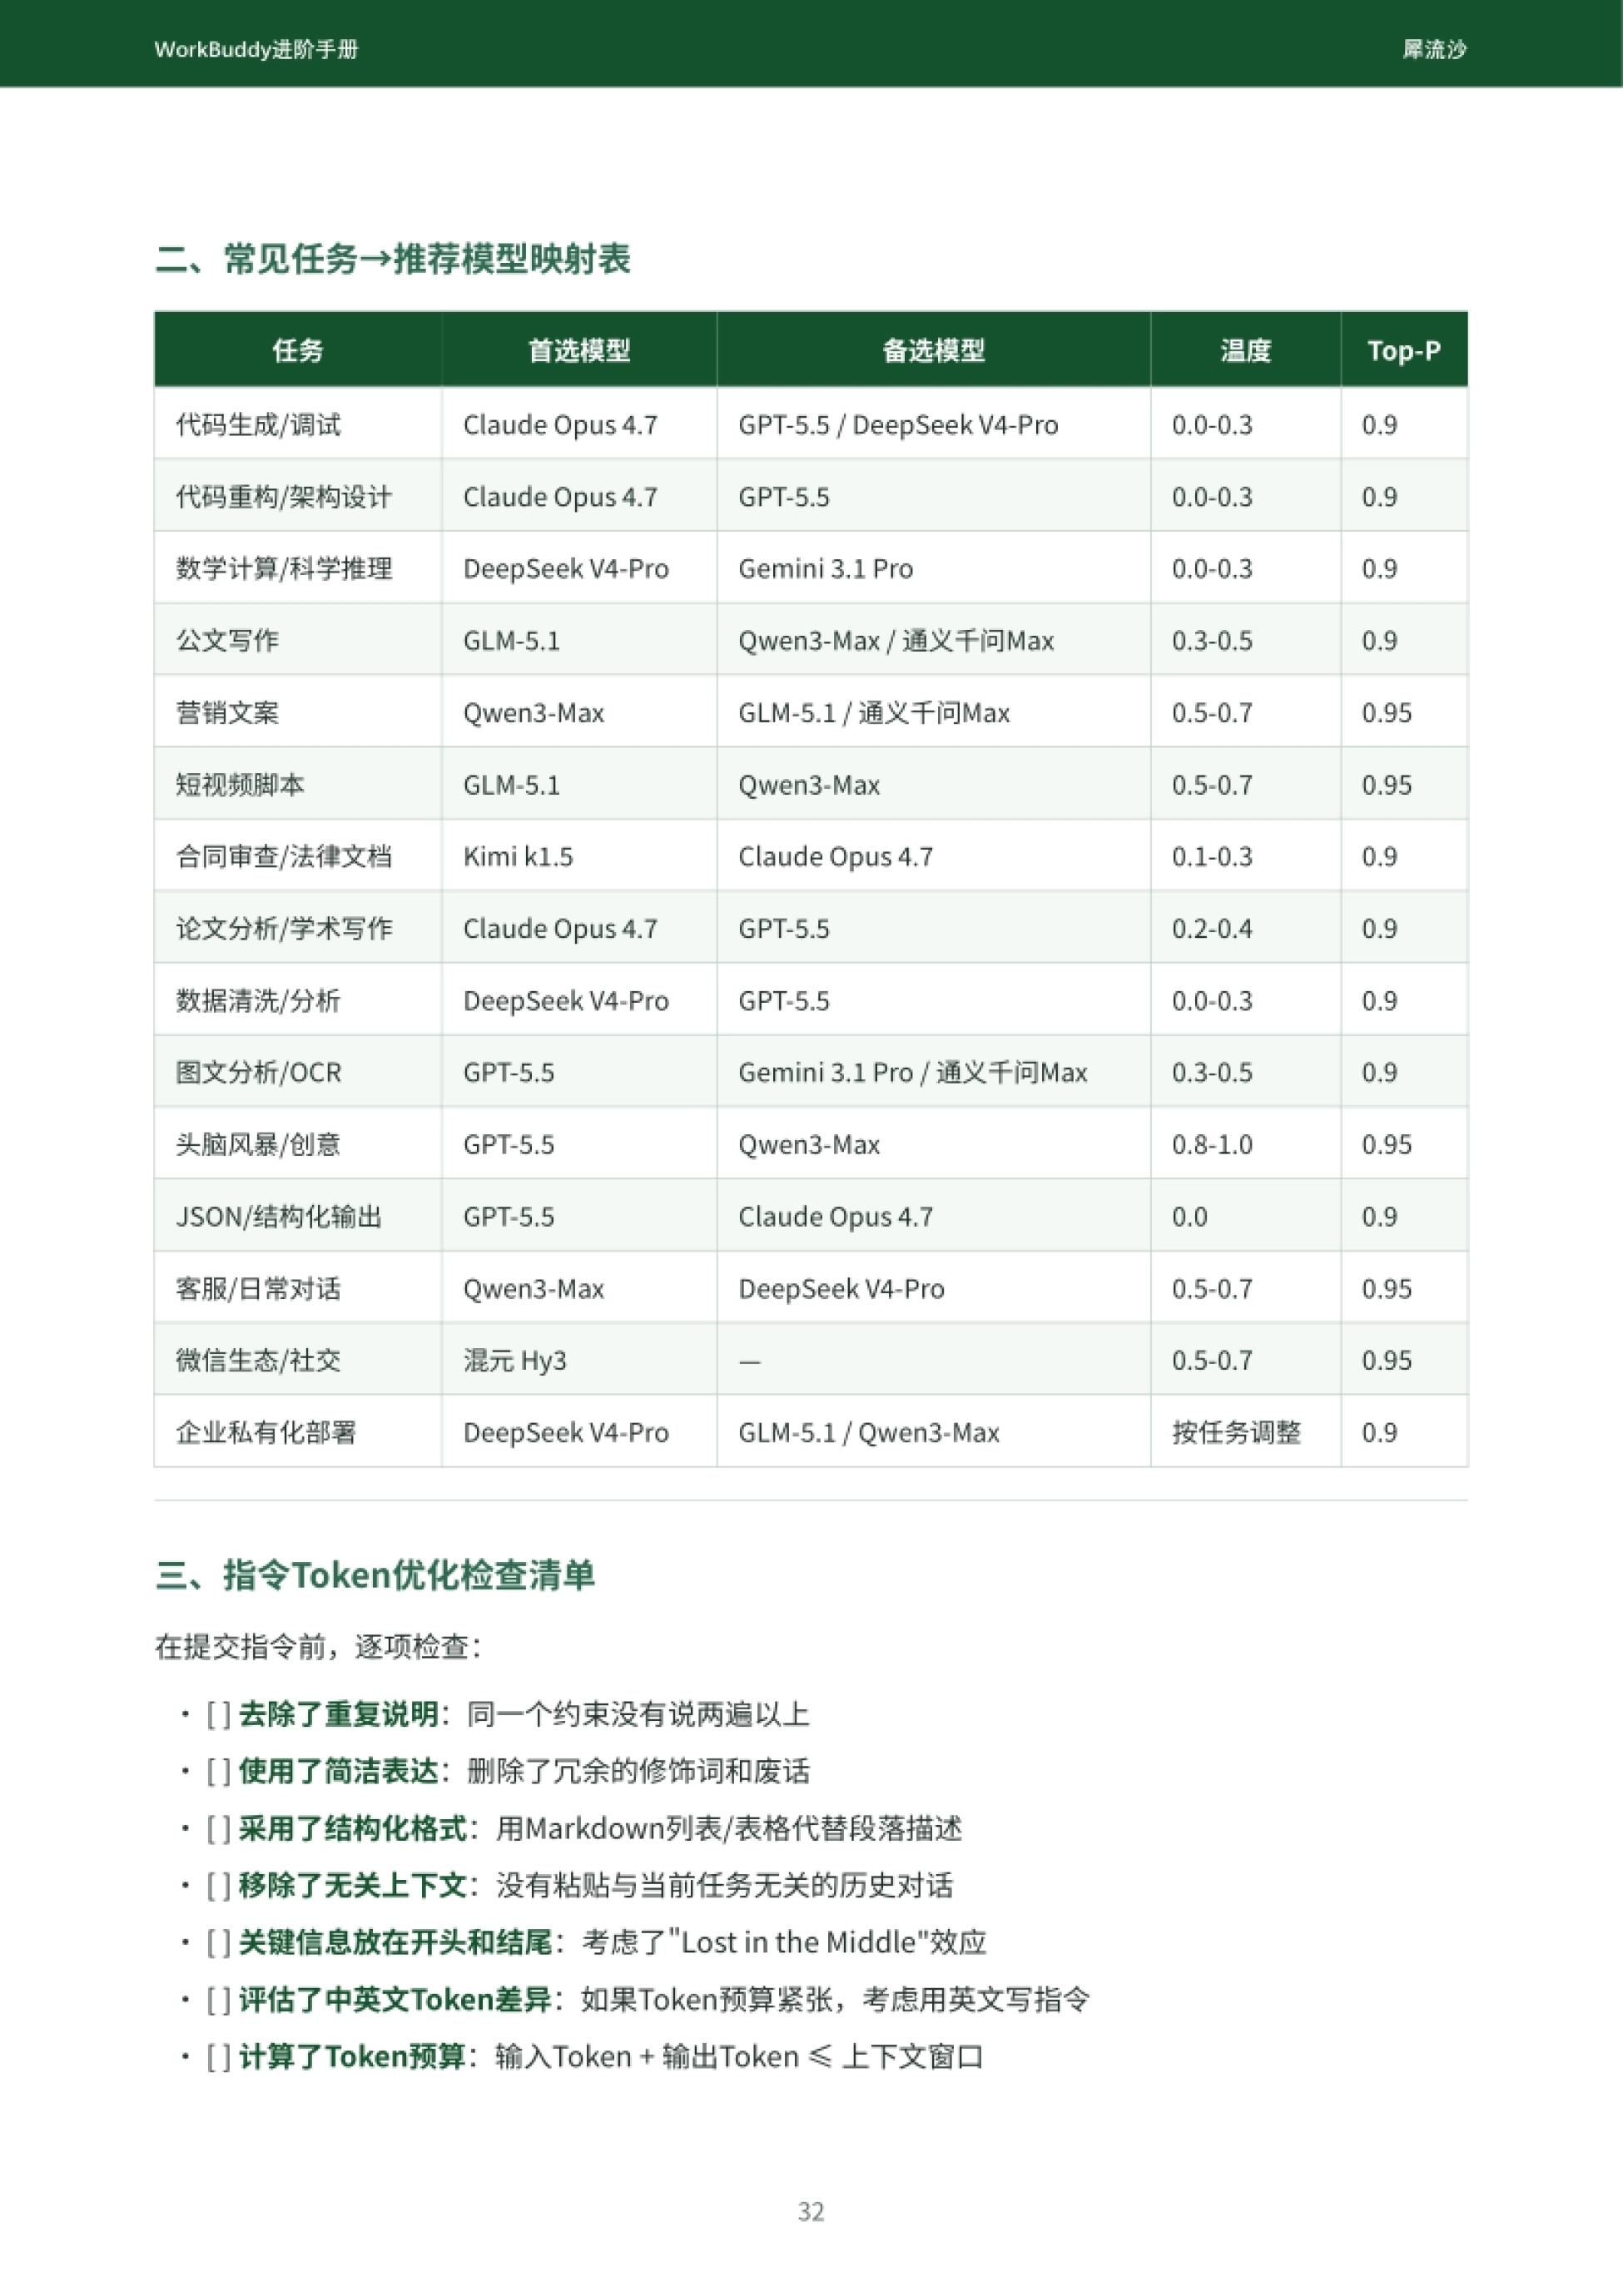
具体怎么填,手册给了一张表,几乎可以照抄。
代码生成、JSON 提取、结构化任务,温度设 0 到 0.3,稳定可复现。
事实性问答、数据分析,0.3 到 0.5,分布变尖峰,输出更保守可预测。
聊天、内容创作,0.7 到 0.9,多样但连贯。
头脑风暴,1.0 上下;超过 1.5,幻觉风险极高,手册直接标注"极少使用"。

来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
Top-P 配合着用,多数任务设 0.9 到 0.95。它保留累计概率超过阈值的最小 Token 集合,会随模型自信度自动收紧或放宽。
比 Top-K 灵活得多。Top-K 的数量是固定的,模型很自信时它会塞进一堆噪声。
还有一个容易踩的坑:别同时设 Top-K 和 Top-P,两者可能互相覆盖。优先用 Top-P。
调参顺序也有讲究——从低温开始往上试,别一上来就高温。
先设 0 看输出是否够用,太单调再往 0.3、0.5、0.7 走。每次调整后测 5 到 10 次。
一旦出现幻觉或不稳定,退回上一个值。
还有模型差异:Claude 对温度最不敏感,Gemini 最敏感,温度 0.9 时输出平均比温度 0 长 34%。
所以在 Claude 上调温度的体感,会明显弱于 Gemini。
四、为什么模型会跑偏:八成锅在指令
手册给了一个判断,值得记住:80% 以上的输出问题是指令问题,不是模型不行。
最常见的三种:指令有歧义、关键信息放在长上下文中间被忽视、代码任务用了高温。
歧义怎么消?不要说"帮我处理一下",要说"帮我把下面这段 JSON 转成 CSV"。
再补两条:给出 1 到 2 个输入输出示例;把所有隐含约束显式写出来。
位置怎么摆?这背后是"Lost in the Middle"效应——模型对长文本中间的信息系统性低估。
标准摆法是三层:最重要的系统提示和核心约束放开头,背景资料放中间,关键约束在结尾再重复一遍。
多轮对话也一样。每 10 到 15 轮做一次摘要,用摘要替代历史,别让旧对话占着窗口。
手册里还有一份 Token 优化清单,照着勾一遍,通常能砍掉三到五成消耗。
去除重复说明省 30% 到 50%,用 Markdown 列表代替段落描述省 20% 到 30%。
删掉冗余修饰词省 10% 到 20%,去掉和当前任务无关的历史对话再省 30% 到 50%。
五、上下文窗口不是越大越好
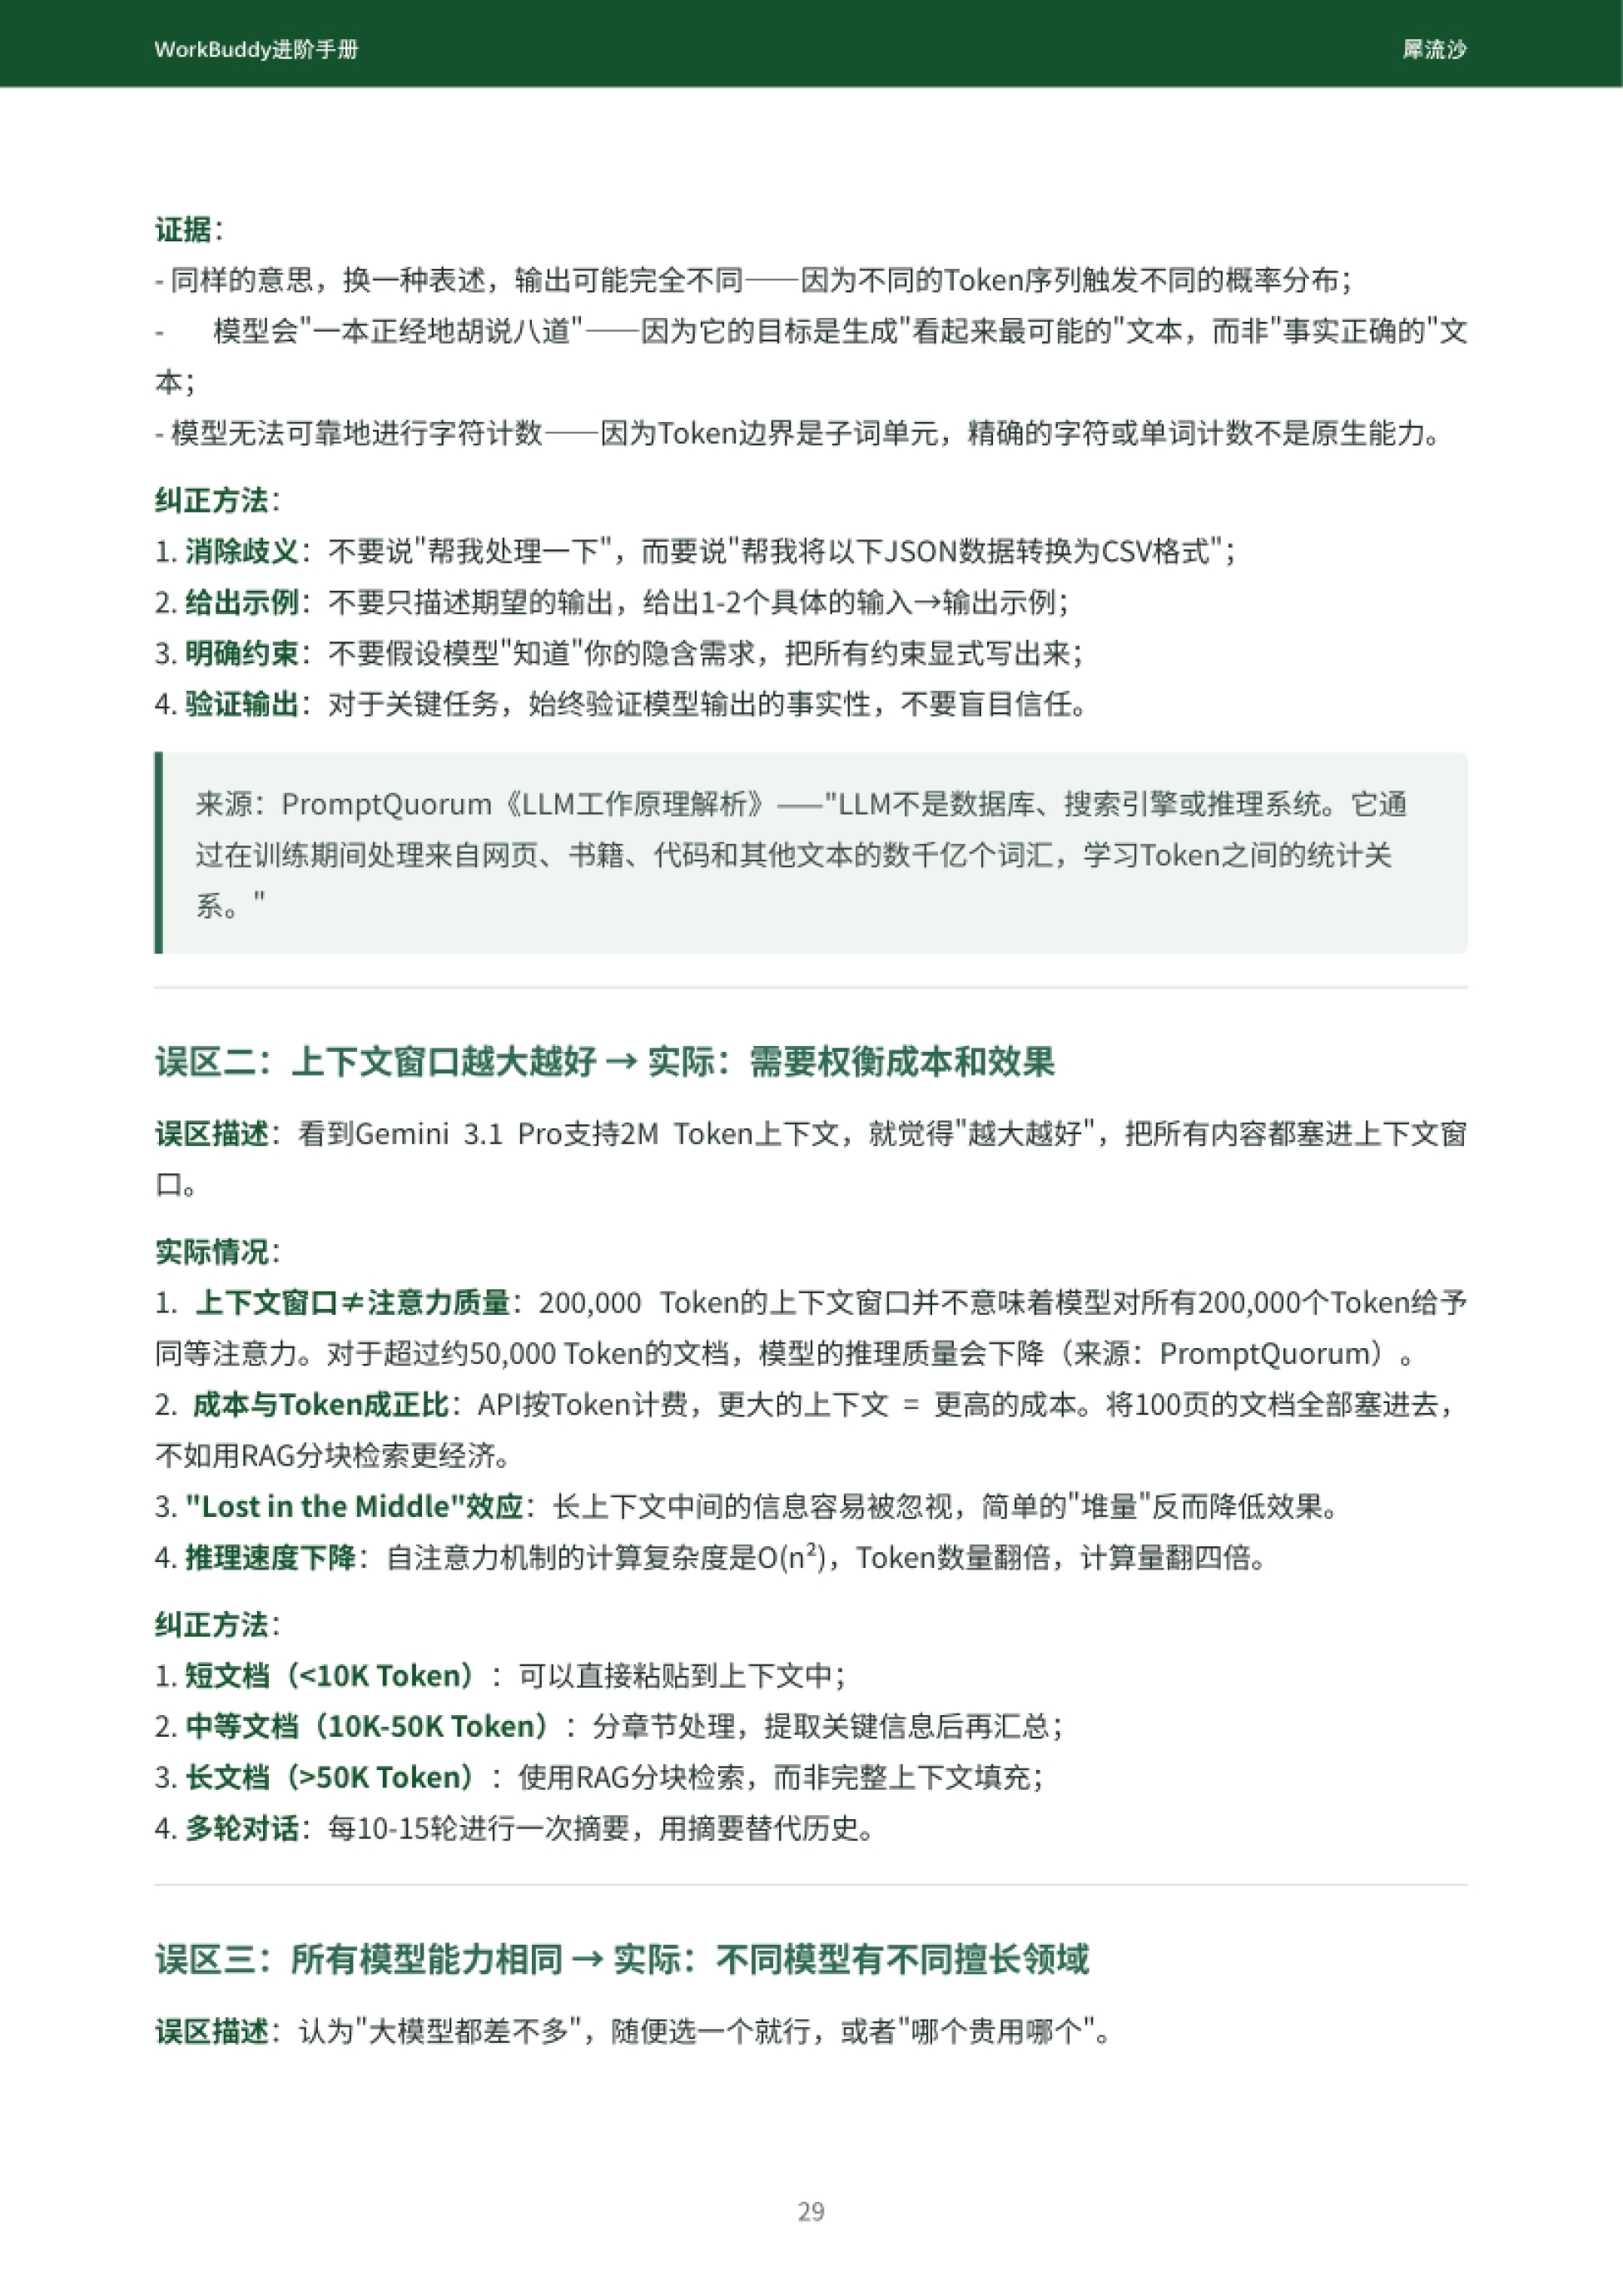
看到某模型支持 200 万 Token,很多人的第一反应是"能塞就塞"。手册明确反对这个做法。
三个原因。第一,窗口大不等于注意力均匀,超过约 5 万 Token 的文档,模型推理质量会下降。
第二,成本跟 Token 成正比,把 100 页文档全塞进去,不如用 RAG 分块检索。
第三,自注意力的计算复杂度是 O(n²),Token 翻倍,计算量翻四倍,速度也会掉。
来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
所以做法要按长度分档:1 万 Token 以内直接贴;1 万到 5 万分章节处理,提取要点再汇总;5 万以上用 RAG。
再补一条最容易被忽略的:每次调用都是无状态的,模型不记得上一轮对话。
它不会"记住"你上次定过的规矩。关键约束写进系统提示,别指望它自己想起来。
想找更多 AI 工作流、提示词模板和效率工具的实操资料,可以上运营动脉(www.yydm.cn)翻翻,站内有 7 万+ 份方案、报告和课件,每月更新超 1000 份。
六、模型怎么选:2026 年没有全能王者
手册对 2026 年的格局给了个判断:海外三强守擂,国产全面突围,开源颠覆成本。
第一梯队是全能旗舰:GPT-5.5、Claude Opus 4.7、Gemini 3.1 Pro。
第二梯队是场景强者:通义千问 Max 88.5 分、Kimi K1.5 87.8 分、DeepSeek V4-Pro 87.5 分。
第三梯队是轻量化和垂直优选:文心一言 4.5、Grok 4.0 等。

来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
差距有多大?Claude Opus 4.7 在 SWE-bench 编程评测上 64.3%,Gemini 3.1 Pro 只有 48.2%,差了 16 个百分点。
而 DeepSeek V4-Pro 在 MATH-500 数学推理上能到 96.8%,编程却只有 54.9%。
同一个模型,不同能力可以差这么多。所以"哪个最强"这个问题本身就是错的。
手册给了一句总结:编程 Agent 首选 Claude,数学和科学推理找 DeepSeek 或 Gemini。
中文办公和内容创作选 GLM-5.1、Qwen3-Max;长文档处理看 Kimi 和 Claude。
要性价比和私有化部署,DeepSeek V4-Pro;微信生态场景,混元 Hy3。
选型四步:先定任务类型,再评估约束(数据合规、预算、延迟、上下文长度),然后匹配模型,最后用真实任务验证。
验证别偷懒,同一任务测 5 到 10 次取均值,看准确性、一致性、成本和响应速度四项。
七、成本怎么降:把 Token 一刀一刀砍下去
手册把省钱拆成可执行的动作,不靠玄学。
第一步,算清楚。用 Token 计数器估一下指令和预期输出各占多少,先有数。
第二步,压缩指令。前面那四条压缩策略走一遍,通常能省一半。
第三步,管好上下文。短输入长输出时,把最大输出设成窗口减输入再留余量。
长输入短输出时反过来,输出压到 4K 就够,不够就先压缩输入。
第四步,选对模型。同样的中文创作任务,换个 Token 效率高的模型,成本直接降一截。
还有一个隐形开支:系统提示太长。它挤占的是你自己的输入和输出空间。
来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
手册最后给了一张检查清单,提交前逐项过一遍,基本不会超预算。
八、AI工作流怎么搭:先按场景找入口
进阶的终点不是会用某个功能,而是能设计解决方案。
手册第 7 页有一张场景导航表,把"你想做什么"直接映射到该读哪一章。
想理解模型为什么这样回答,去底层原理里的大模型原理与认知。
想理解 Agent 为什么有时犯错,去 Agent 原理与架构;想搭自动化,去自动化工作流设计。
想省钱省 Token,去性能优化与成本控制;想接 API、做多 Agent 系统,去进阶开发实践。

来源:运营动脉文库《WorkBuddy进阶手册1.1-犀 流 沙》
它还按人群给了路线。新手从产品架构、提示词工程、日常办公应用、指令模板四步走。
被"指令输出差"困住的,走大模型原理、提示词工程、疑难排解这条线。
想搭 AI工作流的,先学工作流设计,再补 MCP 协议,然后参考会议纪要、周报这类完整 SOP。
手册对 MCP 的定位说得很清楚:它解决的是连接器和能力边界的问题,不是替代工作流本身。
顺序别搞反。先把一条流程跑通,再考虑扩能力,不然容易搭一堆连不上的零件。
最后一句来自手册前言:理解只是起点,能用才是进阶。

 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。