工业AI一年从9.6%冲到47.5%,瓶颈换成了数据和人
 广告
本文解读:《2026年中国工业AI行业发展研究报告-36氪》 · 共 54 页 · 原文
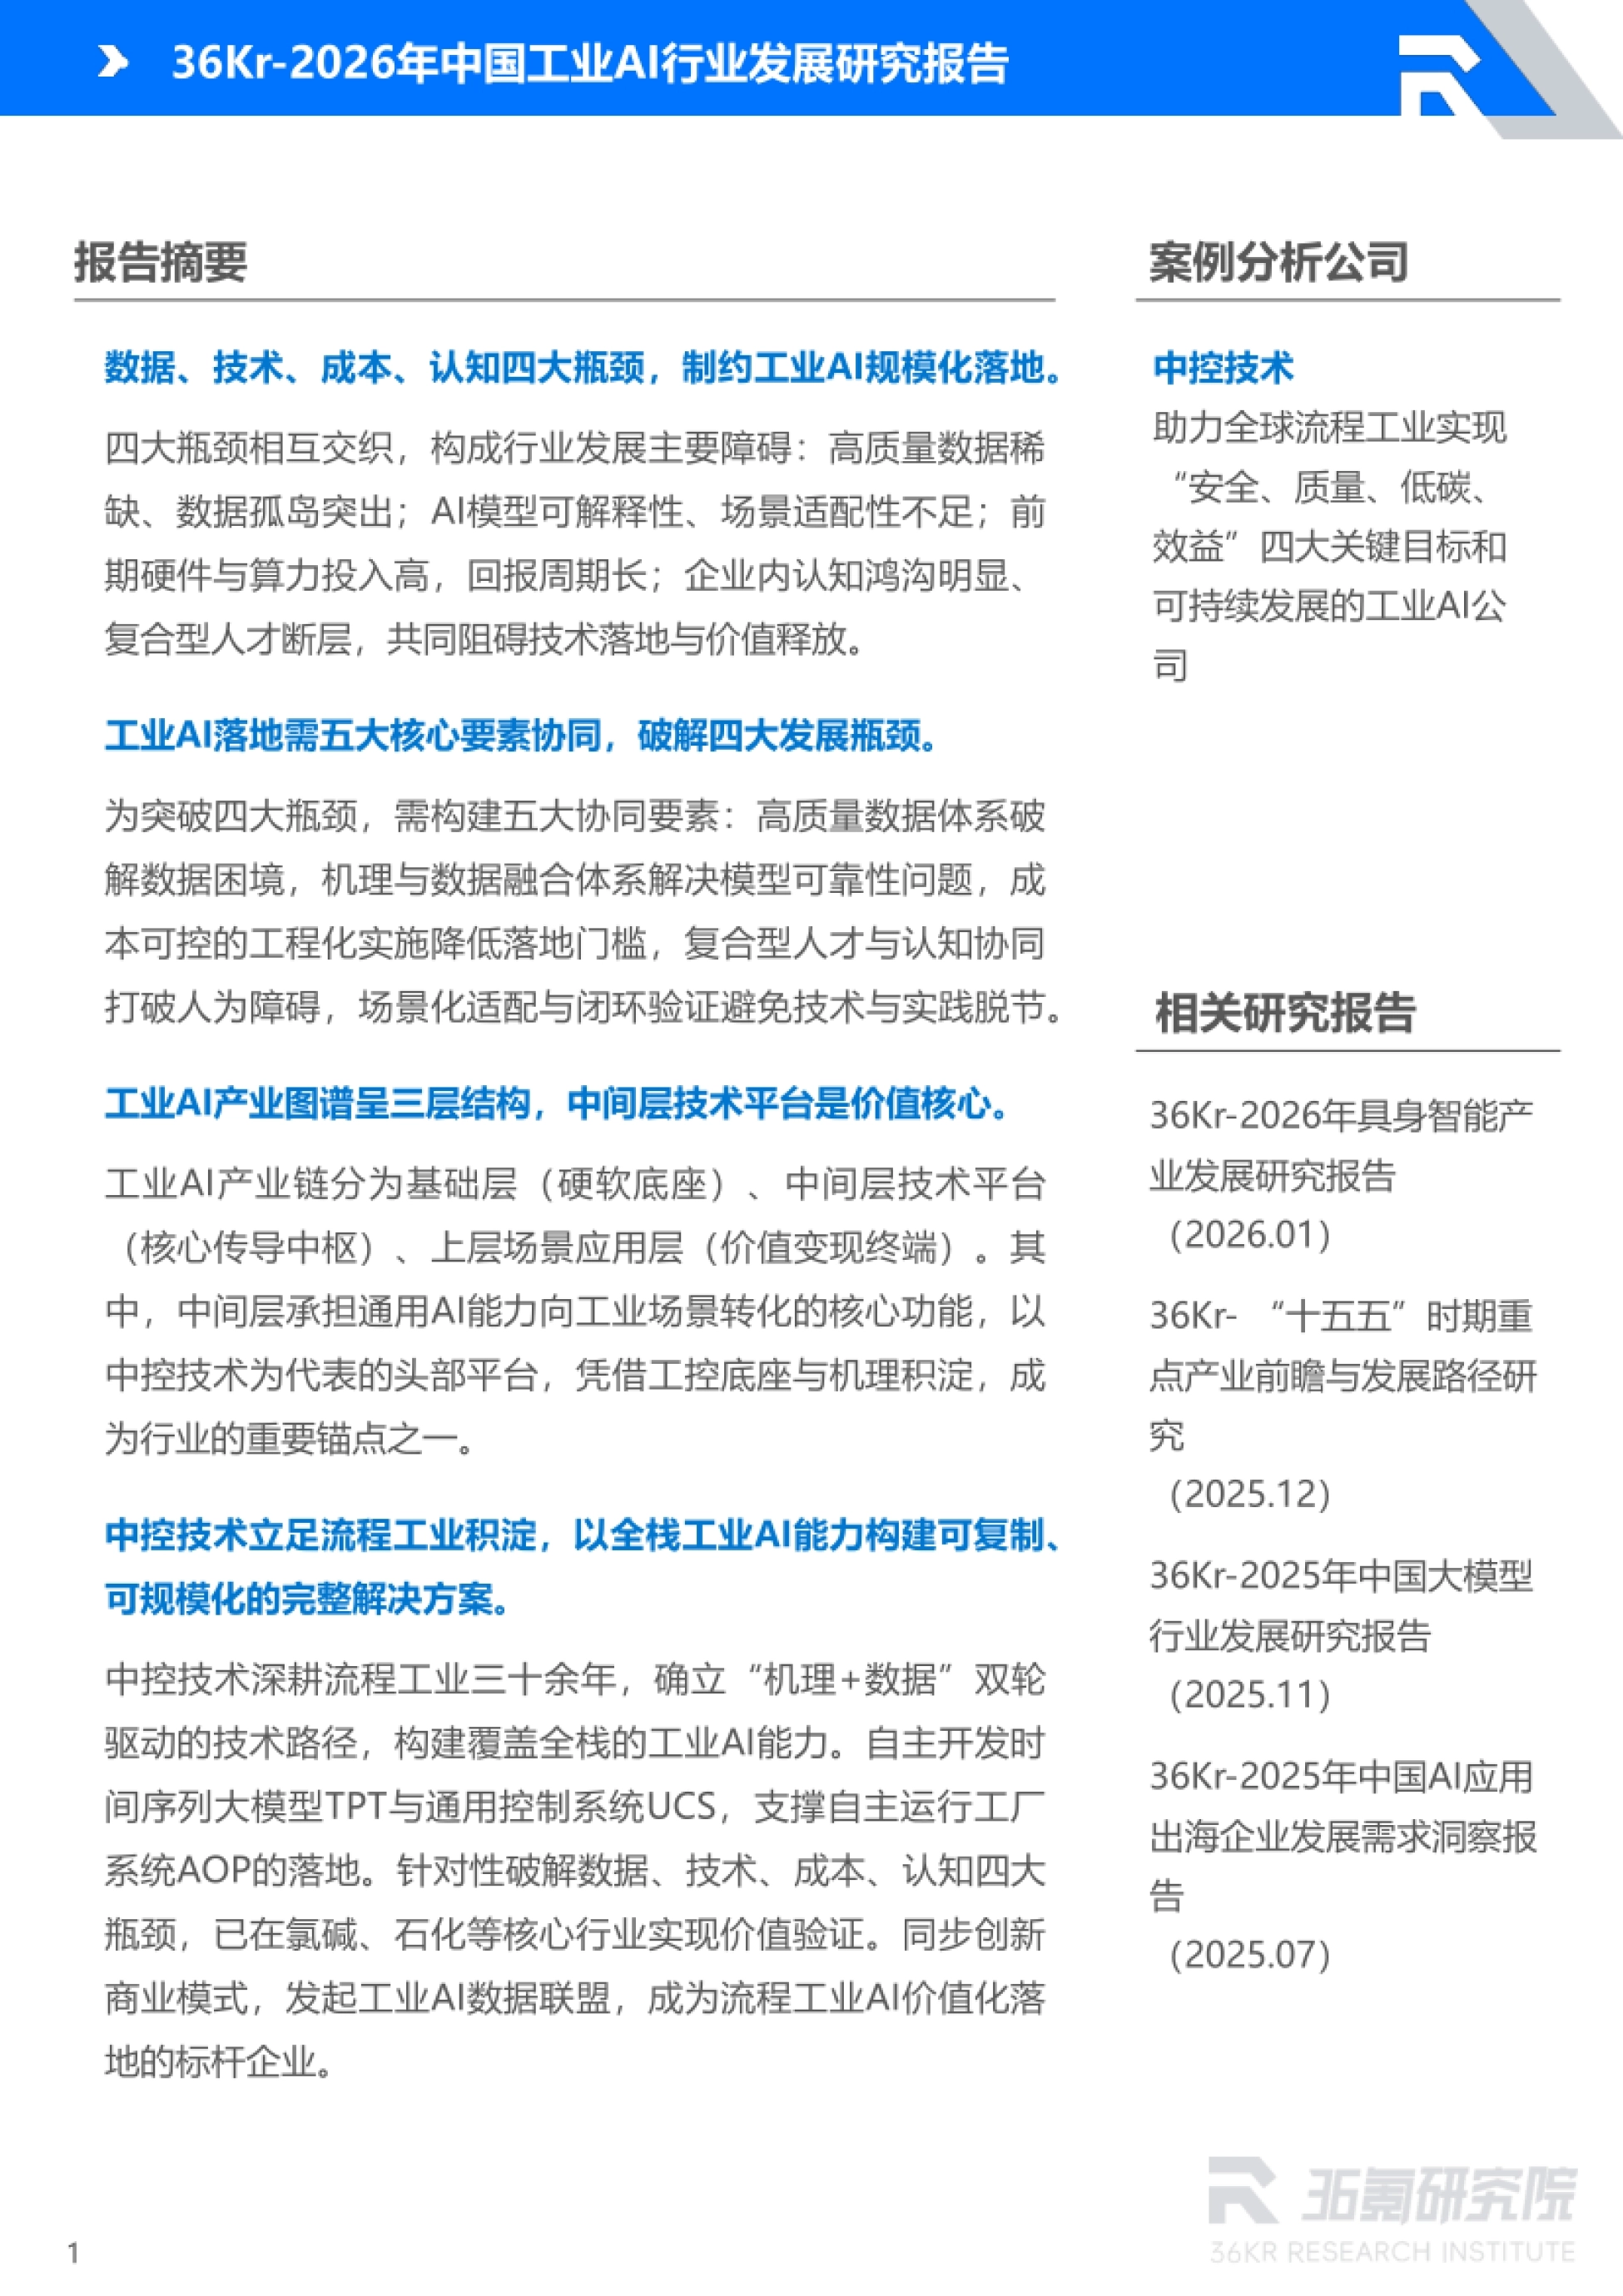
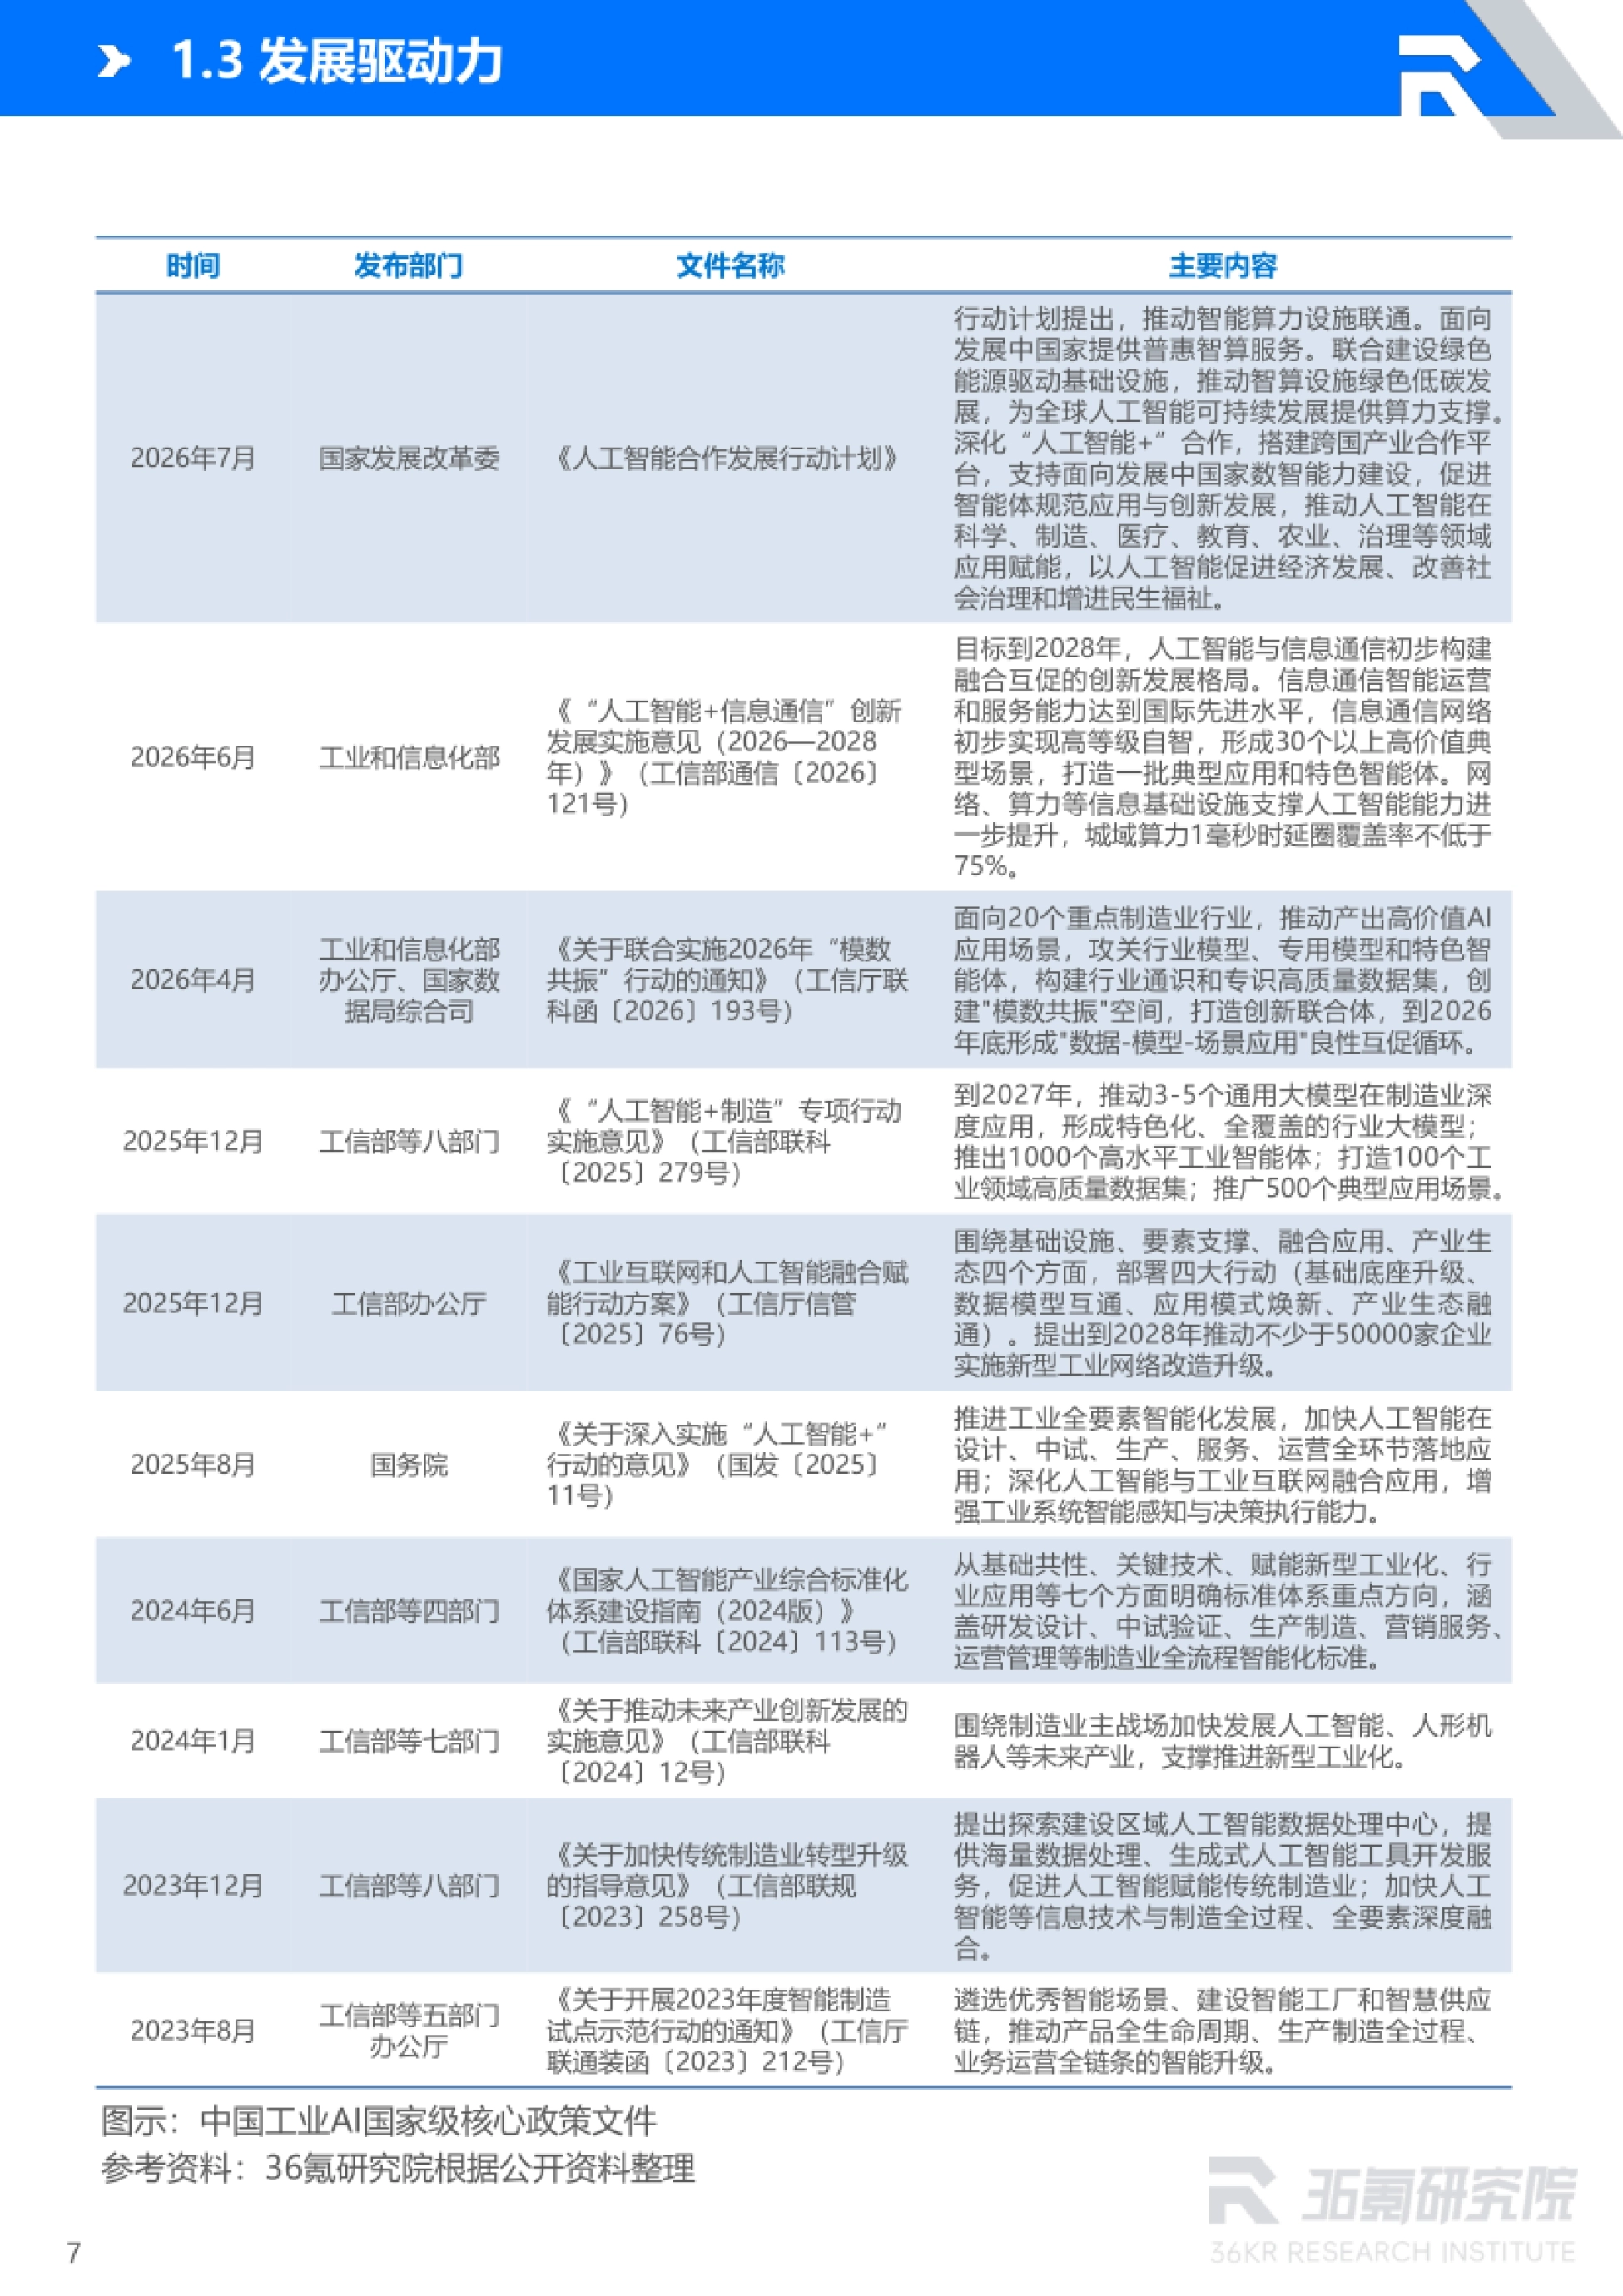
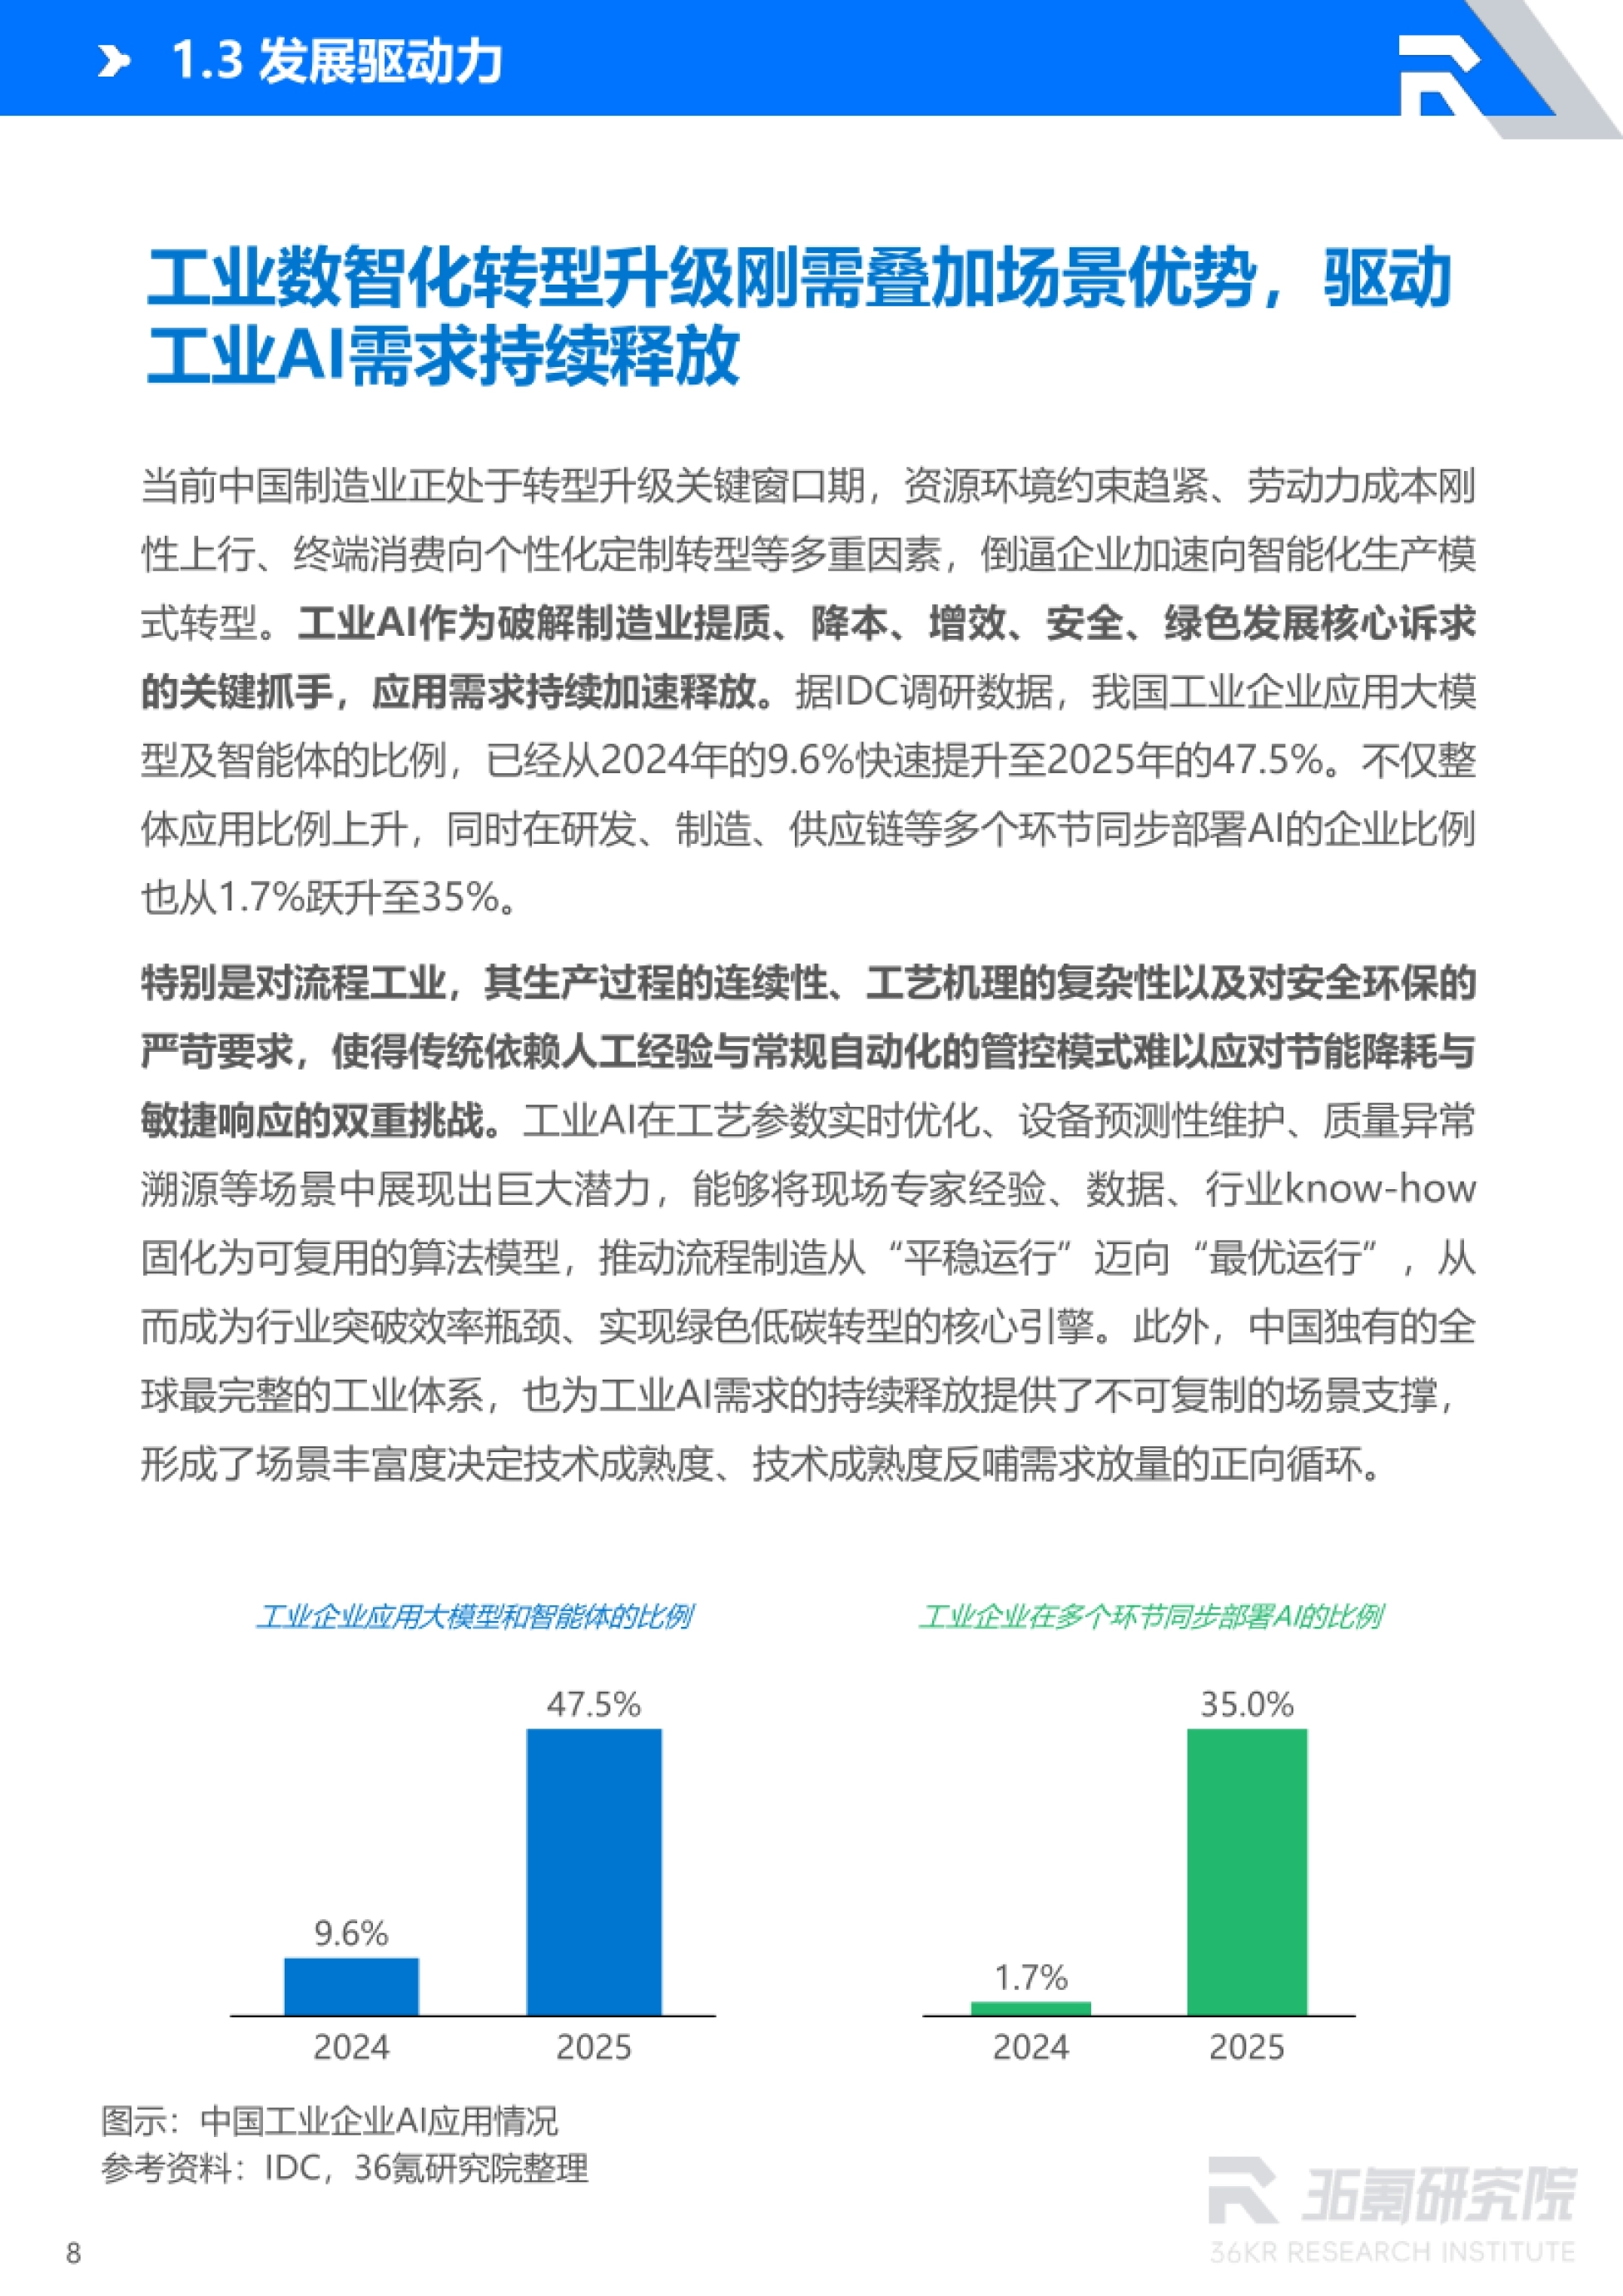
工业AI这一年最猛的数字是渗透率:据 IDC 调研,我国工业企业应用大模型及智能体的比例,从 2024 年的 9.6% 跳到 2025 年的 47.5%,多环节同步部署的比例从 1.7% 涨到 35%。
但 36氪这份 54 页的报告没有顺着势头往下夸,它把下一步的障碍摆得很明白:数据、技术、成本、认知四大瓶颈互相放大。
最刺眼的是数据:某流程工业工厂全年正常运行数据有 10TB,故障数据只占 0.03%,还多是碎片化记录,模型没法在这种样本上练出鲁棒性。
技术侧的落差也很直接,流程工业里基于大模型的智能系统使用率只有 29.3%,绝大多数企业还停在 L2 人机协同自动化。报告给出的出路不是换模型,而是把机理和数据一起做,再按 L0 到 L5 逐级往上走。
渗透率已经跑在能力前面,这才是这份报告最该被记住的判断。

图源:《2026年中国工业AI行业发展》(第1页) · 原文
一、为什么拿流程工业当试金石
报告把工业AI定义为人工智能在制造、能源、采矿等垂直领域的深度应用,但重点观察的对象锁死在流程工业。
理由有三个:连续生产带来实时闭环需求,物理化学反应过程要求机理与数据融合,安全低碳效益的约束让 AI 的价值更容易量化。
离散工业的痛点在别处,设备利用率低、排程复杂、交付周期长,落地难点是场景碎片化、非标程度高、数据标准化难。流程工业的难点则完全不同,机理复杂度高、安全冗余要求严、模型必须深度融合工艺知识。
报告还列出工业AI的三个特性:物理闭环、安全可靠、机理融合,每一项都直接对应通用AI的短板。最典型的一条是通用AI缺乏物理因果与空间约束,模型容易算出「数字合理但现场无法执行」的结论。
流程工业不是最容易做的场景,是最骗不了人的场景。
图源:《2026年中国工业AI行业发展》(第2页) · 原文
二、中国71%的应用比例全球第一,但短板在底层
基于 MHP 对全球约 1200 家制造业企业的调研,各经济体工业AI应用比例分化明显。中国以 71% 领跑,印度 61%、美国 57% 紧随其后,墨西哥 51%、英国 48%,德语区工业强国只有 37%。
报告对这个数留了一句注解:这反映的是企业部署意向,与实际生产环节的深度渗透率可能存在差异。三条路径的差异也很清楚:美国走技术原生与生态垄断,聚焦高端制造回流;欧盟合规优先,围绕工业5.0推进人机协作与绿色制造。
中国走的是政策引导加市场落地,依托连续 16 年世界第一的制造业规模,推全行业、全链条的规模化普及。但制约同样明确:底层芯片、基础工业软件和高端模型工具链仍是短板,工业数据质量与协同水平有待提升。
应用广度领先不等于技术自主,这两件事在报告里被分开评价。
图源:《2026年中国工业AI行业发展》(第3页) · 原文
三、市场规模怎么算出来的:75 万元乘以 51.7 万家
报告把「可变现市场规模」和「潜在经济效益」拆开算,只取能落地、能营收的那部分。需求侧的算法很直白:规上制造业企业 51.7 万家,按单家年均 AI 投入 75 万元测算,理论空间约 3,878 亿元。
75 万元的来源是分层加权:头部企业占 4%、单家 1000 万元,腰部占 30%、单家 100 万元,尾部占 66%、单家 7.5 万元。再乘上约 30% 的实际转化率,得到 2026 年潜在可落地空间 1,163 亿元。
转化率也分层算过,头部 65%、腰部 40%、尾部 21%,整体加权 28.5%,考虑 2026 年加速渗透向上取整为 30%。增长按历史增速锚定、渗透率爬坡、商业化兑现率三维拟合,年均复合增速 25.4%,2030 年市场规模到 3,034 亿元。
同期人工智能核心产业 2025 年规模已突破 1.2 万亿元,国家发改委明确「十五五」末相关产业规模将超 10 万亿元。
这一千多亿不是需求总盘子,是扣掉付费意愿和交付周期之后能收上来的钱。
图源:《2026年中国工业AI行业发展》(第4页) · 原文
四、三层产业图谱,钱和壁垒都在中间那层
报告把产业链分成基础层、技术平台层、场景应用层,形成「基础层筑基、技术平台层赋能、场景应用层变现」的链条。基础层是 AI 芯片、传感器、控制器、实时操作系统、时序数据库,属于底座,国产替代正在加速。
技术平台层承担把通用AI能力转成工业场景能力的核心功能,也是报告认定的价值核心与竞争阵地。场景应用层分流程工业与离散工业,其中流程工业成熟度更高,是规模化落地的主赛道。
平台层内部又分成两派:科技大厂主导的通用型平台主打全行业适配与生态开放,行业型平台深耕机理与工控底层,做端到端闭环。
报告的判断是通用平台在低代码、知识管理、跨行业工具层仍有价值,高价值闭环控制场景则归行业型平台。
工业大模型在四个维度上重塑平台:架构从外挂插件变模型原生内核,开发从人工定义规则变预训练加轻量化微调,交付从项目制定制变标准化产品,价值从单点优化变全链路释放。
谁能把通用能力翻译成工艺语言,谁就卡在价值链最贵的那一段。
图源:《2026年中国工业AI行业发展》(第5页) · 原文
五、五类玩家同台,暂时没有绝对龙头
报告把参与者分成五类,每一类的优势都来自不同的基因,短期谁也没法通吃。传统自动化企业以霍尼韦尔、艾默生、横河电机为代表,握有 DCS、PLC、SCADA 的底层控制权,可靠性做到「5 个 9」。
互联网大厂以华为、阿里云、百度智能云为代表,比的是算力、资金和非结构化数据处理能力,主打视觉质检与预测性维护。
大型工业用户如中石油、巴斯夫,手里有最真实的极端工况场景和失效样本,既是需求方也是验证方。平台与软件厂商如 AspenTech、中控技术、全应科技,核心是把行业 Know-how 和 AI 技术焊在一起。
AI 原生初创如 C3.ai、创新奇智、阿丘科技,走轻量敏捷路线,未来的归宿多半是被并购或者转型做代运营。报告还搭了一套「六维一体」发展指数,行业纵深能力 25%、技术创新 20%,市场、财务、生态各 15%,成长潜力 10%,并明确说明这是研究参考框架而非权威评级。
五类玩家拼的不是同一个东西,所以短期内谁也吃不掉谁。

图源:《2026年中国工业AI行业发展》(第6页) · 原文

图源:《2026年中国工业AI行业发展》(第7页) · 原文
六、L3 是分水岭,多数企业还卡在 L2
报告借鉴自动驾驶分级,把工业AI落地划成 L0 到 L5,围绕人工干预率、闭环控制覆盖率、异常处置率、安全验证通过率、工况覆盖率五个维度。
L0 是全人工,人工干预率 100%;L1 只有单点自动化和阈值告警;L2 能做到单装置局部闭环,人工干预率降到 46%。L3 是关键分水岭,人工干预率 24%,闭环控制覆盖率 95%,异常处置率 70%,能覆盖简单调度和部分小幅波动工况。
但 L3 仍要求人工主控决策与兜底,工况异动识别和大幅负荷调整还得靠人的经验。L4 才进入场景全自主,人工干预率降到 2%,异常处置率 90%,可以远程监督;L5 是全域自主,人工干预率归零。
报告没给各等级的分布数据,但从 29.3% 的大模型智能系统使用率看,多数企业离 L3 的门槛还有距离。
L3 之前拼的是自动化改造,L3 之后拼的才是模型能力。

图源:《2026年中国工业AI行业发展》(第8页) · 原文
图源:《2026年中国工业AI行业发展》(第9页) · 原文
七、四大瓶颈:数据最缺故障样本,人最缺复合能力
数据瓶颈有三层:高质量过程数据稀缺、数据孤岛普遍、缺乏统一标准。最直观的还是那组样本:全年正常运行数据 10TB,故障数据只占 0.03%,还多是碎片化的,训练不出鲁棒性。
技术瓶颈里最要命的是可解释性与工业安全要求的矛盾,黑箱模型一旦偏差,可能引发生产事故,责任还界定不清楚。
流程工业调研里,64.1% 的企业被多变量强耦合困住,这类工况的优化高度依赖多模态数据协同分析。成本瓶颈有具体账目:以中型化工企业单条主要生产线为基准,硬件 20 到 50 万元、软件 30 到 50 万元每年、算力 80 到 160 万元每年、实施 120 到 260 万元每项目。
综合下来 250 到 620 万元一个项目,ROI 周期 6 到 18 个月,对中小企业是一道不低的门槛。认知瓶颈的两组数字最能说明问题:88% 的高管认为 AI 能显著提升效率,只有 21% 的一线员工认同;麦肯锡测算到 2030 年中国 AI 高技能人才需求 600 万、供给 200 万,缺口 400 万。
技术难题能靠迭代解决,认知鸿沟只能靠一遍遍的场景验证来填。
图源:《2026年中国工业AI行业发展》(第10页) · 原文
八、案例里的成效,都是把闭环做出来的
报告挑了三个落地案例,共同点是不谈模型参数,只谈闭环改变了什么。兴发集团湖北兴瑞的氯碱项目,用时间序列大模型 TPT 加通用控制系统 UCS 搭自主运行工厂系统 AOP。
结果是全厂岗位配置从 260 人优化到 80 人,机柜空间减少 90%、电缆成本降低 80%、建设周期缩短 50%,线缆与施工成本省下超 4,000 万元。烧碱主产品浓度稳定控制在 32% 到 32.1%,整体生产效益提升 1% 到 3%,调节阀智能诊断准确率超 95%。
万华化学宁波 65 万吨烧碱装置部署 TPT 后,中和时长从 5 小时缩到 25 分钟,吨碱电耗降 10 千瓦时,自控投用率 ≥98%。该项目年节省碳酸钠约 1000 吨,降低分析频次 2400 次每年、节约分析成本 103 万元,直接经济效益超 1,000 万元每年。
上面引用的数据都能在原文里找到出处,报告放在运营动脉(www.yydm.cn),搜标题即可。
遇到统计口径不一致的地方,回原文核一眼,比对两三篇二手解读要快得多。
第三个是沙特阿美 Hawiyah NGL 油气厂站,用防爆巡检机器人做 7×24 小时无人巡检,把事后补救改成事前预警。
案例里没有一个数字来自模型本身,全部来自闭环把哪一段流程改了。
九、下一步看标准、模数共振和物理AI
工业AI的下一程,报告给了三条线索:标准补齐、模数共振、物理AI。标准侧已经落地三项国标:GB/Z 204-2026 定工业大模型体系架构,GB/Z 203-2026 定技术要求,GB/Z 195-2026 定工业智能体参考架构。
其中智能体标准的对象从「模型」延伸到「行动」,也把安全、权限、实时性、可解释性和故障降级的重要性抬了上来。模数共振讲的是双向循环:以模引数,倒逼 DCS、PLC 里的碎片数据做标准化治理;用数赋模,让现场实时数据反哺模型微调。
物理AI则把智能装进硬件,覆盖防爆巡检机器人、智能控制阀、工业母机、在线监测终端,核心是全域物理感知、工况自适应、端侧低时延决策和风险自主处置。
报告也提醒风险仍在:模型与复杂工况的适配、数据孤岛与标准不统一、前期投入偏高、复合型人才不足,这几项都会伴随整个普及过程。
54 页原文、市场规模测算公式和案例指标表都在运营动脉(www.yydm.cn),搜报告名就能打开。
工业AI的终局不是模型更强,是工厂自己会转。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。