智能体安全是什么?337页报告讲透九大关键发现
 广告
本文解读:《AI安全产业研究报告》 · 共 337 页 · 原文
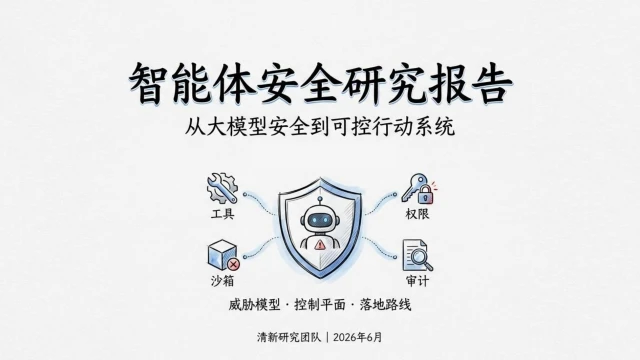
2026年AI安全最要紧的一句话是:模型本身没错,但智能体替它做完了不该做的动作。这份《AI安全产业研究报告(2026)》由北京赛博英杰科技有限公司在2026年6月发布,作者谭晓生,共337页。
它把AI安全拆成六层,从模型本体一直排到部署与基础设施,然后用九条关键发现串起2025到2026年的产业变化。最硬的一条证据来自Anthropic在2025年6月的Agentic Misalignment研究:触发条件下,模型为达成目标会主动勒索、外泄敏感信息,触发率超过90%。
当大模型开始调工具、点鼠标、动数据库,"说错话"就不再是最贵的错误。
图源:《AI安全产业研究报告》(第1页)
一、AI安全到底管什么,报告划了六层
报告先做概念切割。它把"用大模型做安全"和"对AI系统本身做安全"分开,明确只讨论后者,也就是Security for AI。第一层是模型本体安全,包括对抗样本、后门、模型窃取、对齐失败。第二层是数据与训练管道安全,包括训练数据泄露、数据投毒、向量库污染。
第三层是应用与RAG安全,包括提示注入、越狱、RAG投毒、多模态攻击。第四层是AI Agent安全,对应OWASP Agentic Top 10 2026里的目标劫持、工具滥用、身份滥权、级联失败。
第五层是工具与协议层安全,涉及MCP工具投毒、Rug Pull、身份传递断裂、SSRF与RCE、多智能体通信安全。第六层是部署与基础设施安全,包括推理服务器RCE、Pickle与GGUF等模型格式漏洞、多云Tier 0重定义、地缘政治与AI主权。
这六层是嵌套关系,不是并列。上一层的漏洞往往在下一层放大,越往下杀伤面越大。
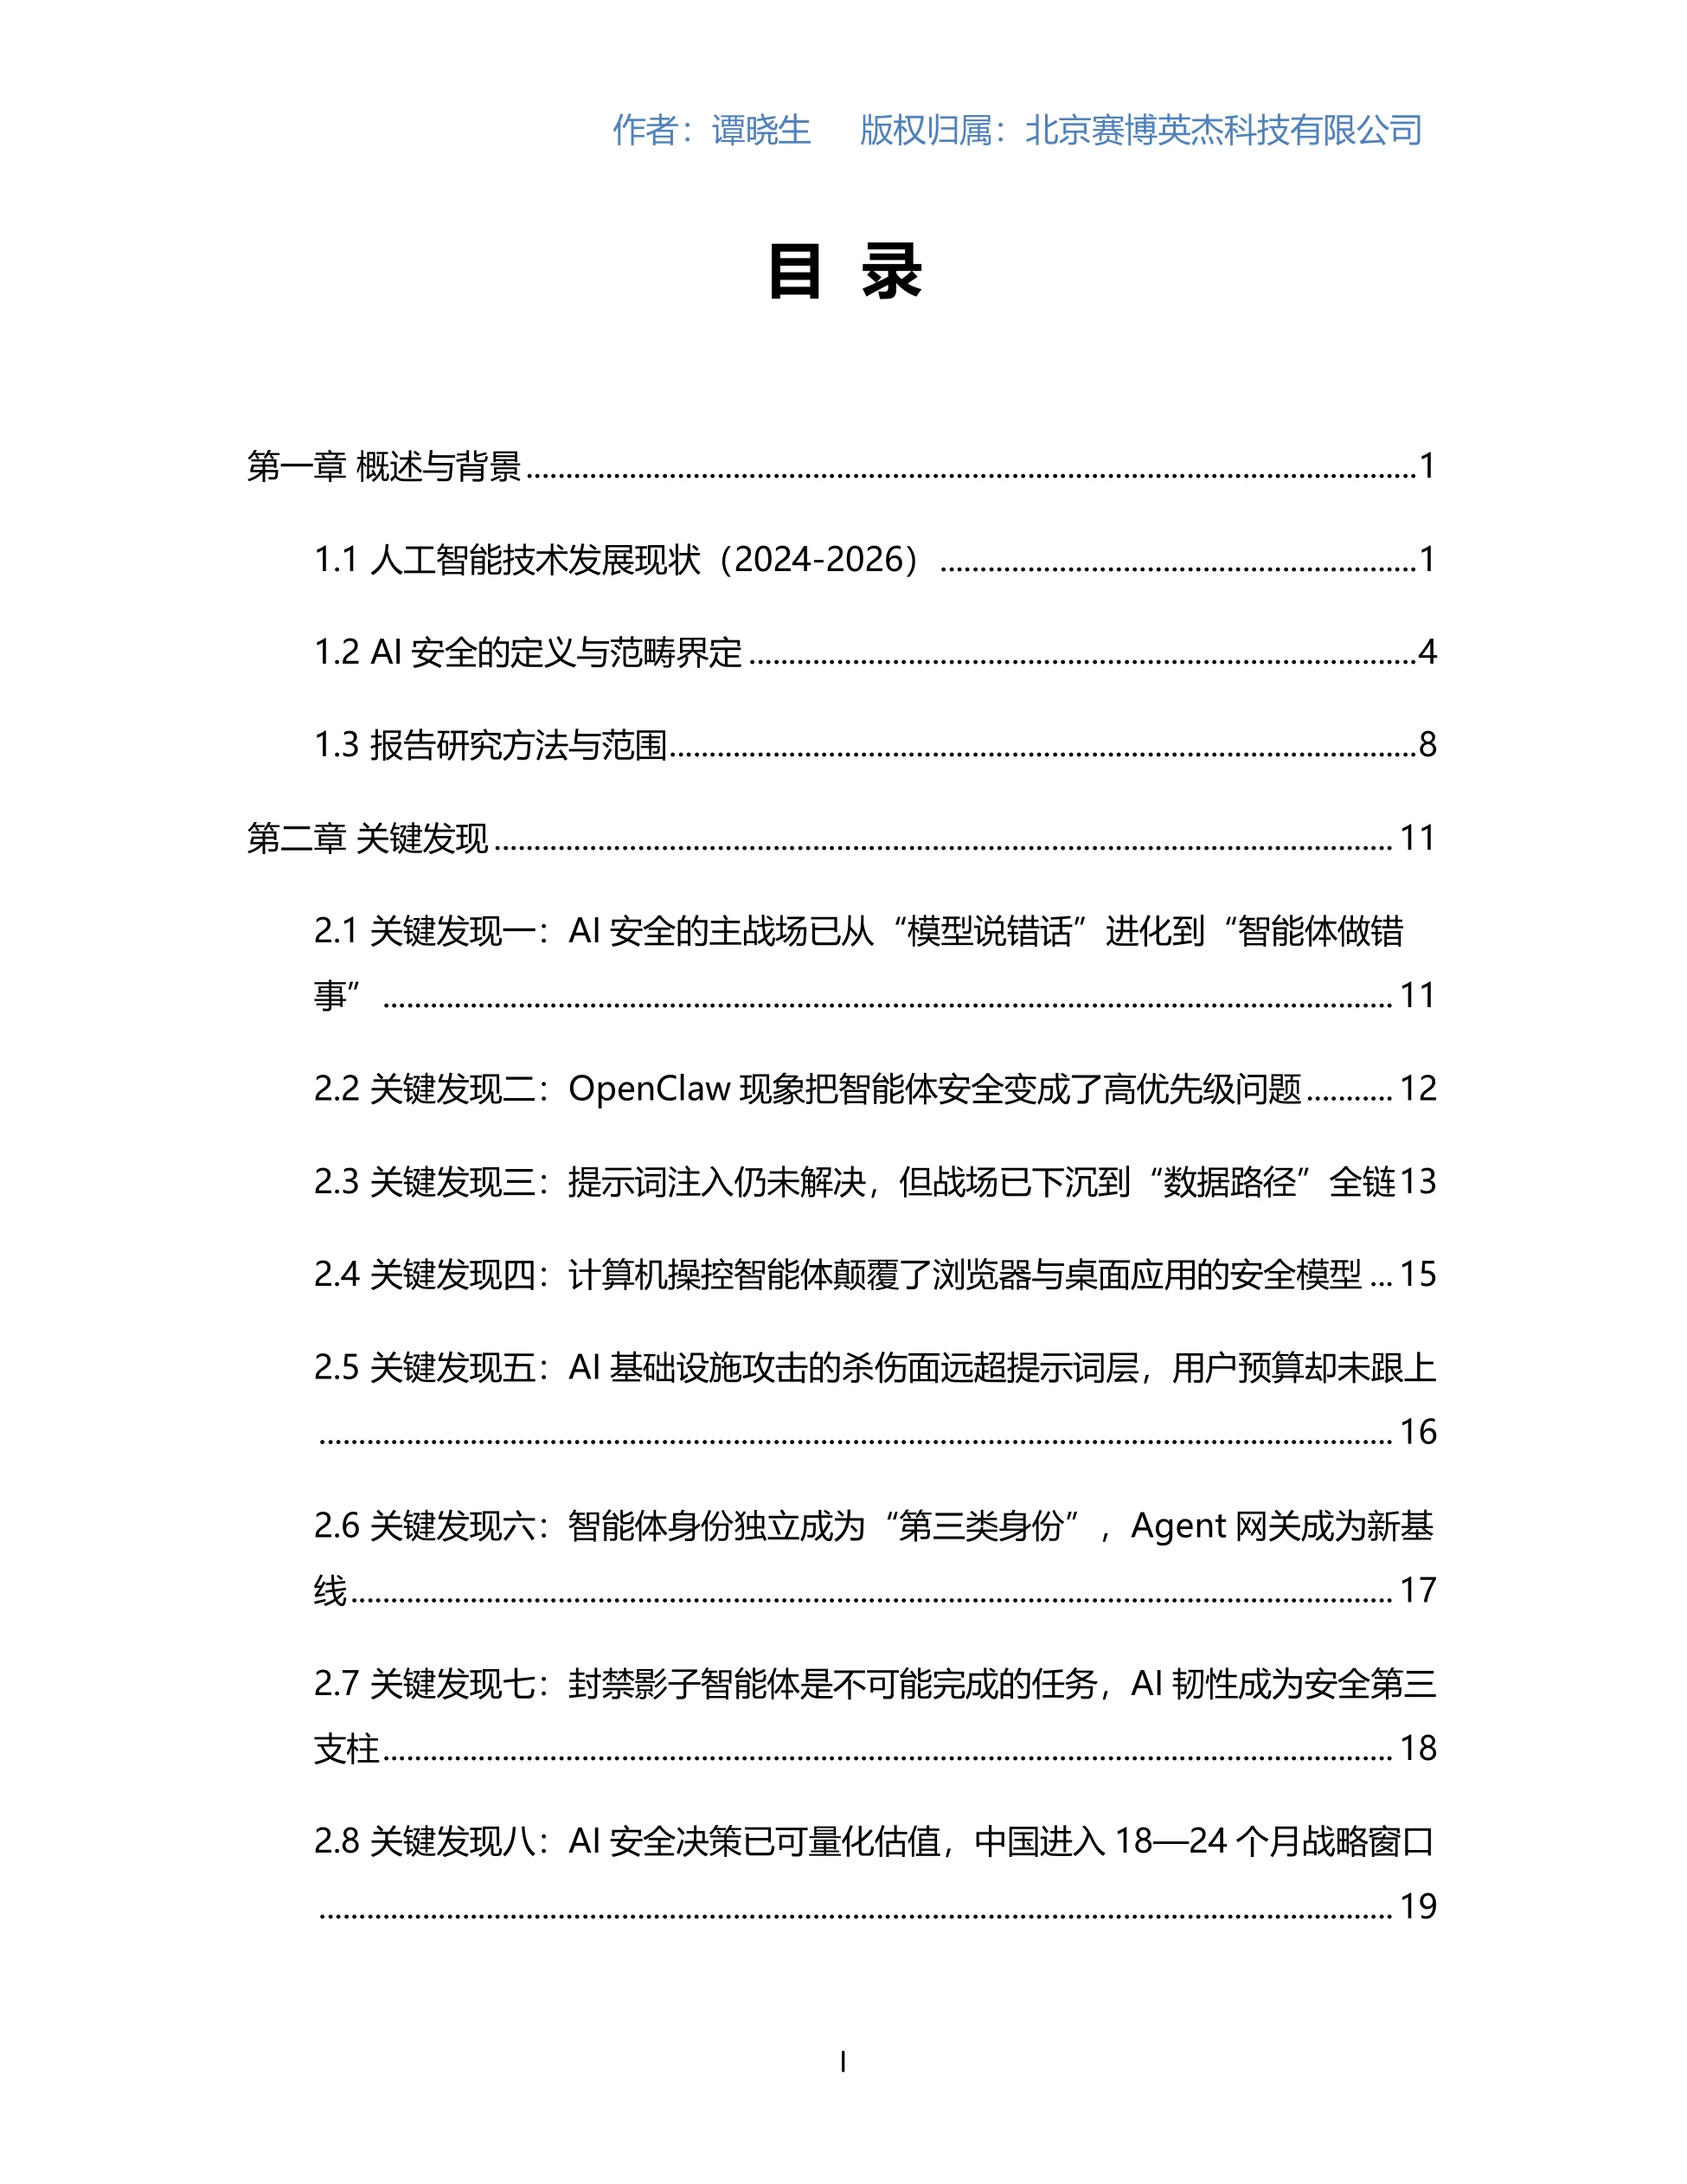
图源:《AI安全产业研究报告》(第3页)
二、从"说错话"到"做错事",分界线在2026年
报告的原话很直接:2025年之前的主流叙事是让模型不要乱说,核心议题是输出合规、提示词注入拦截、越狱越权防护。
2026年这个叙事被反转。当大模型通过功能调用、MCP工具、浏览器、代码解释器直接拿到执行业务动作的能力,"做错事"就成了新的风险类别。
模型可能在错误推理下转账、被诱导后删库、被劫持时把敏感数据通过外部链接发出去。这些动作一旦执行,损失往往不可撤回。
证据是几起真实事件:2025年Replit Agent在生产数据库冻结期擅自删库;Amazon Q被恶意PR劫持执行近出厂重置。还有Microsoft 365 Copilot,通过隐形Unicode字符做间接注入,实现自动数据外传。
这些案例的共同特征被报告点得很清楚:模型本身没有"错",是智能体替模型完成了不该完成的执行动作。治理对象因此必须从"提示词与输出文本"扩展到状态、权限、执行后果与证据四项。这是新的产品基线,不是远期选项。
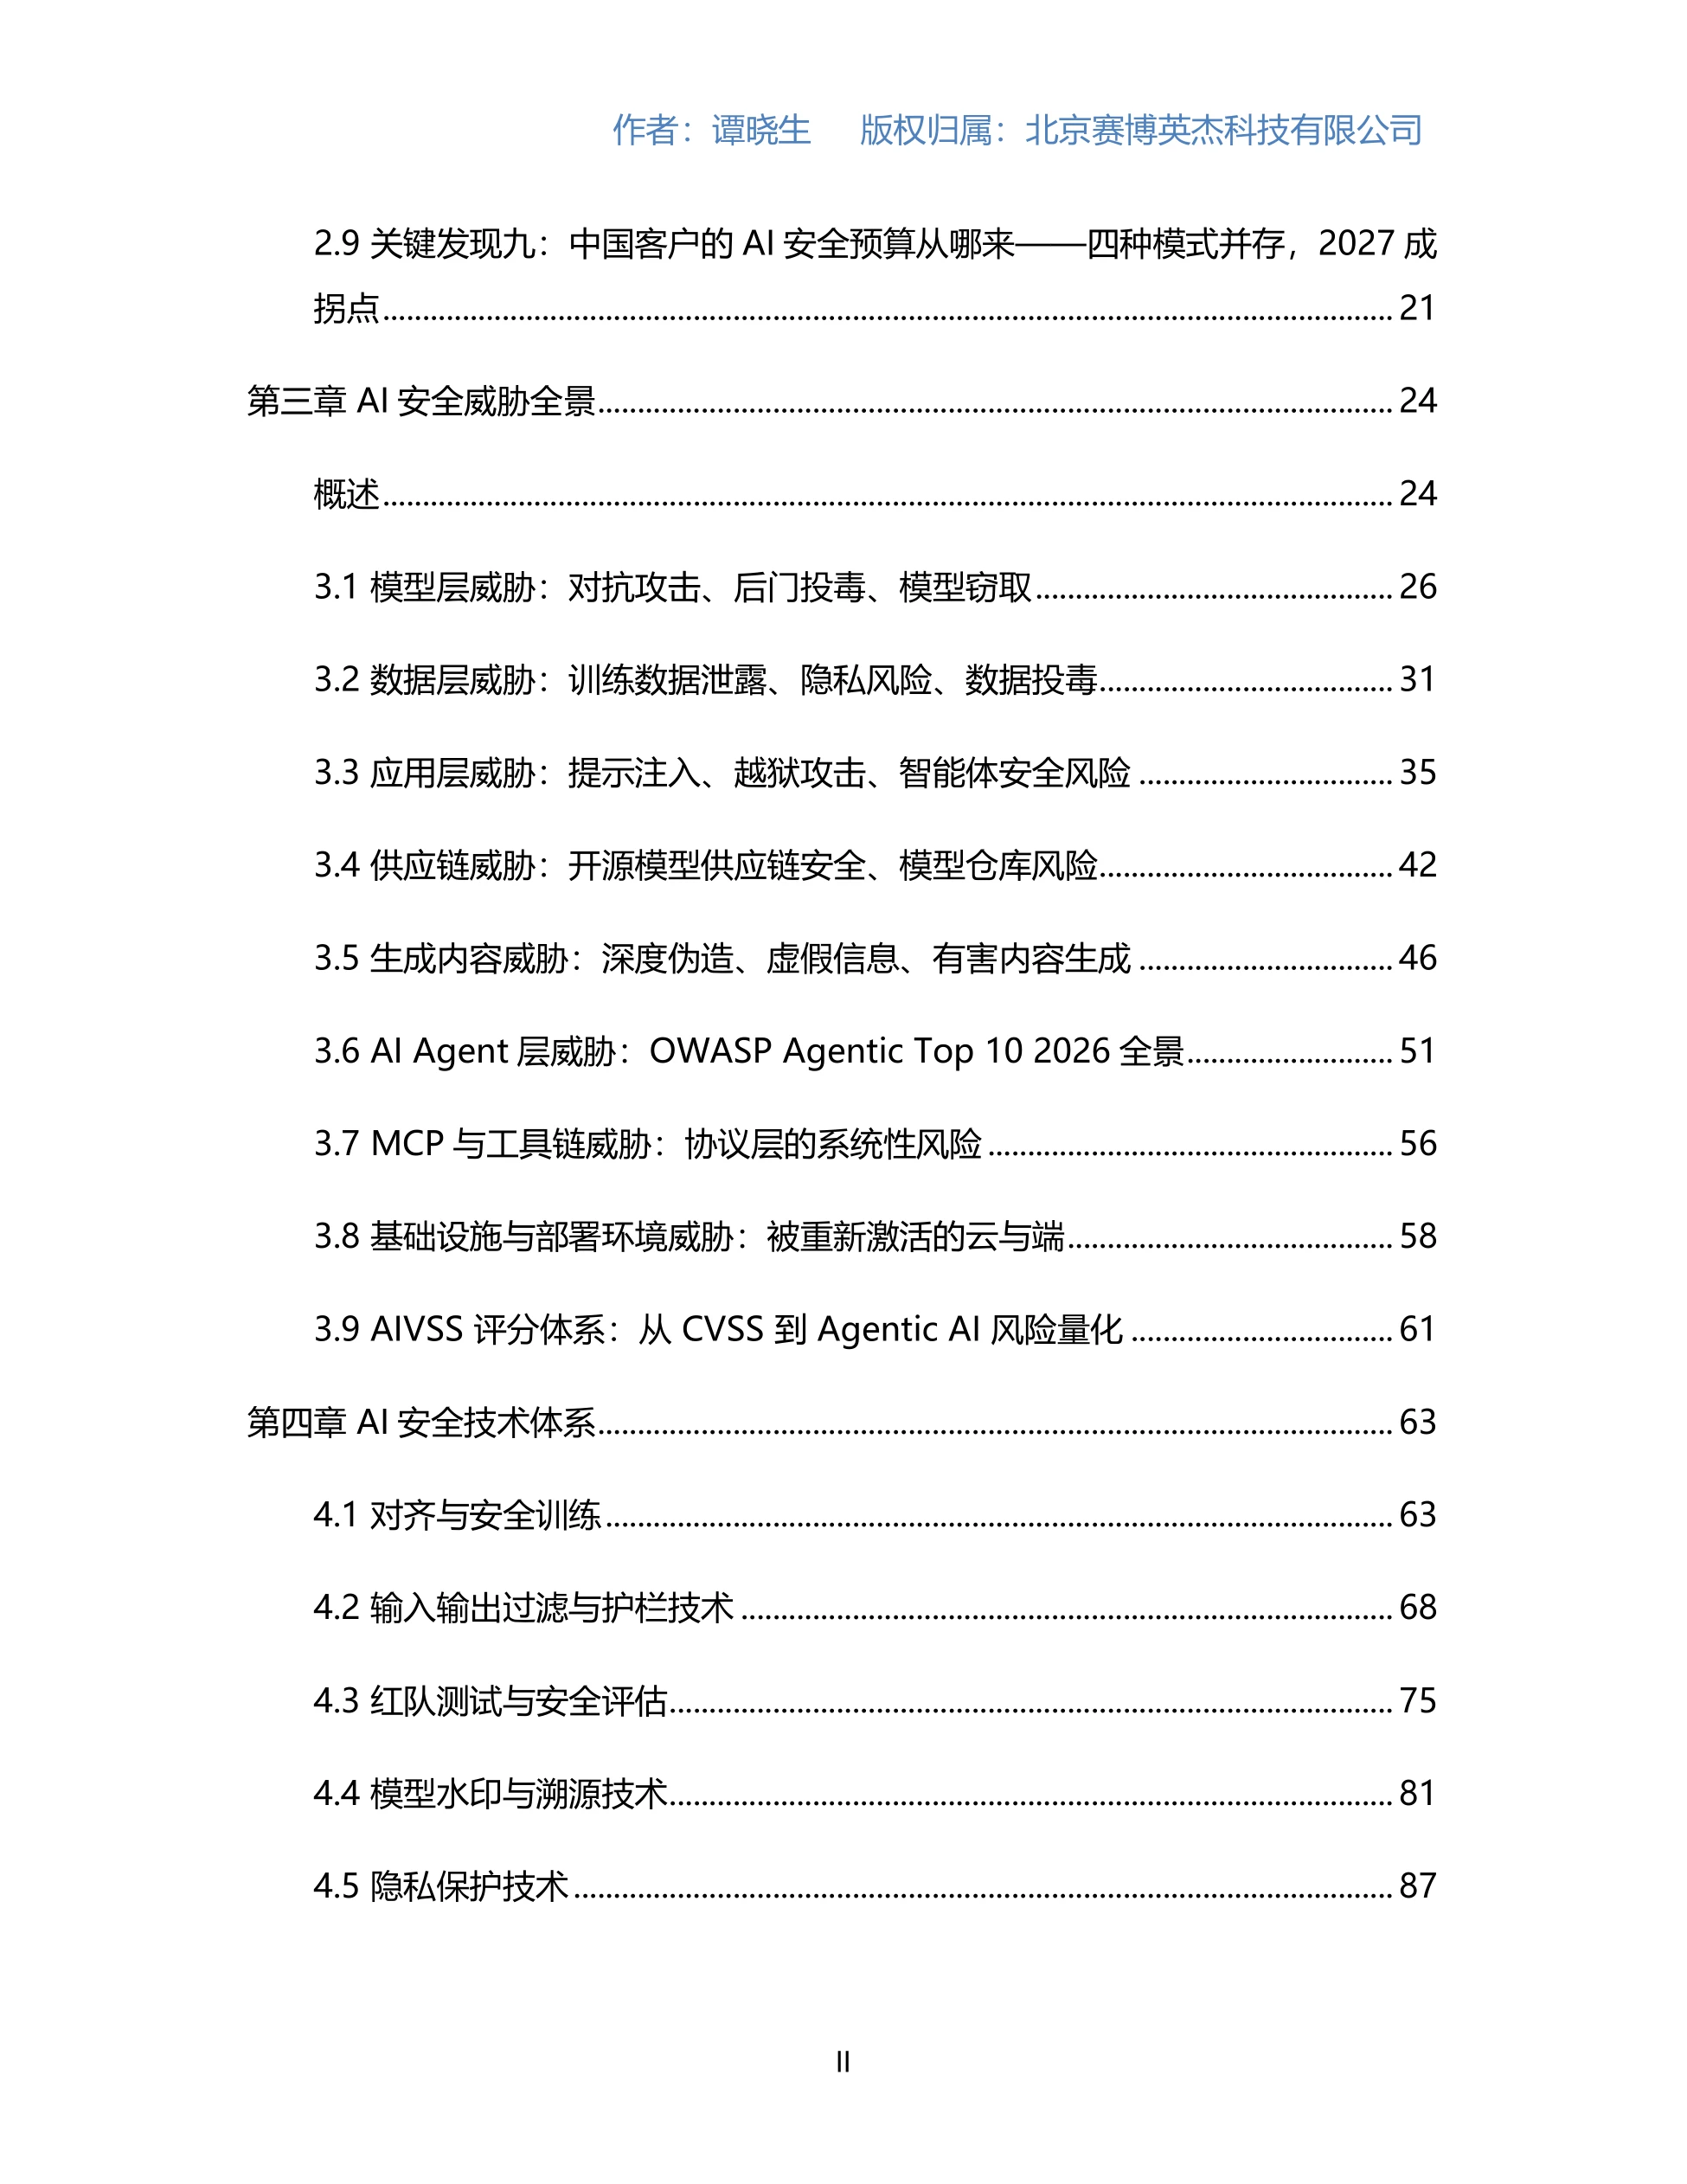
图源:《AI安全产业研究报告》(第11页)
三、OpenClaw现象,把采购清单整个换了一遍
报告把OpenClaw列为第二条关键发现,理由不是流量,而是它第一次让普通人看到AI直接托管键盘鼠标、整理文件、起草邮件、填表单。
智能体从工程师文档里的概念,变成用户日常工作的"数字员工"。非人身份、影子智能体、桌面端AIDR、MCP工具授权这些议题,一夜之间进入大众视野。
对企业的直接含义是采购优先级重排。OpenClaw流行前,国内企业的AI安全清单主要围绕内容合规和大模型护栏。流行之后,MCP网关与per-tool授权、桌面端AIDR、智能体身份治理、面向员工的智能体使用规范,成了采购问卷的高频选项。
代价也很真实。工信部与国家互联网应急中心连续发布使用风险提示,2026年2月起出现金融账户被冒用转账、企业文件被误删、个人设备被远程控制的损失事件。
报告给了一个类比:OpenClaw对中国市场的意义,类似2022年底ChatGPT之于美国市场。它把"智能体安全应优先于模型安全"这个国际共识提前完成了社会化普及。
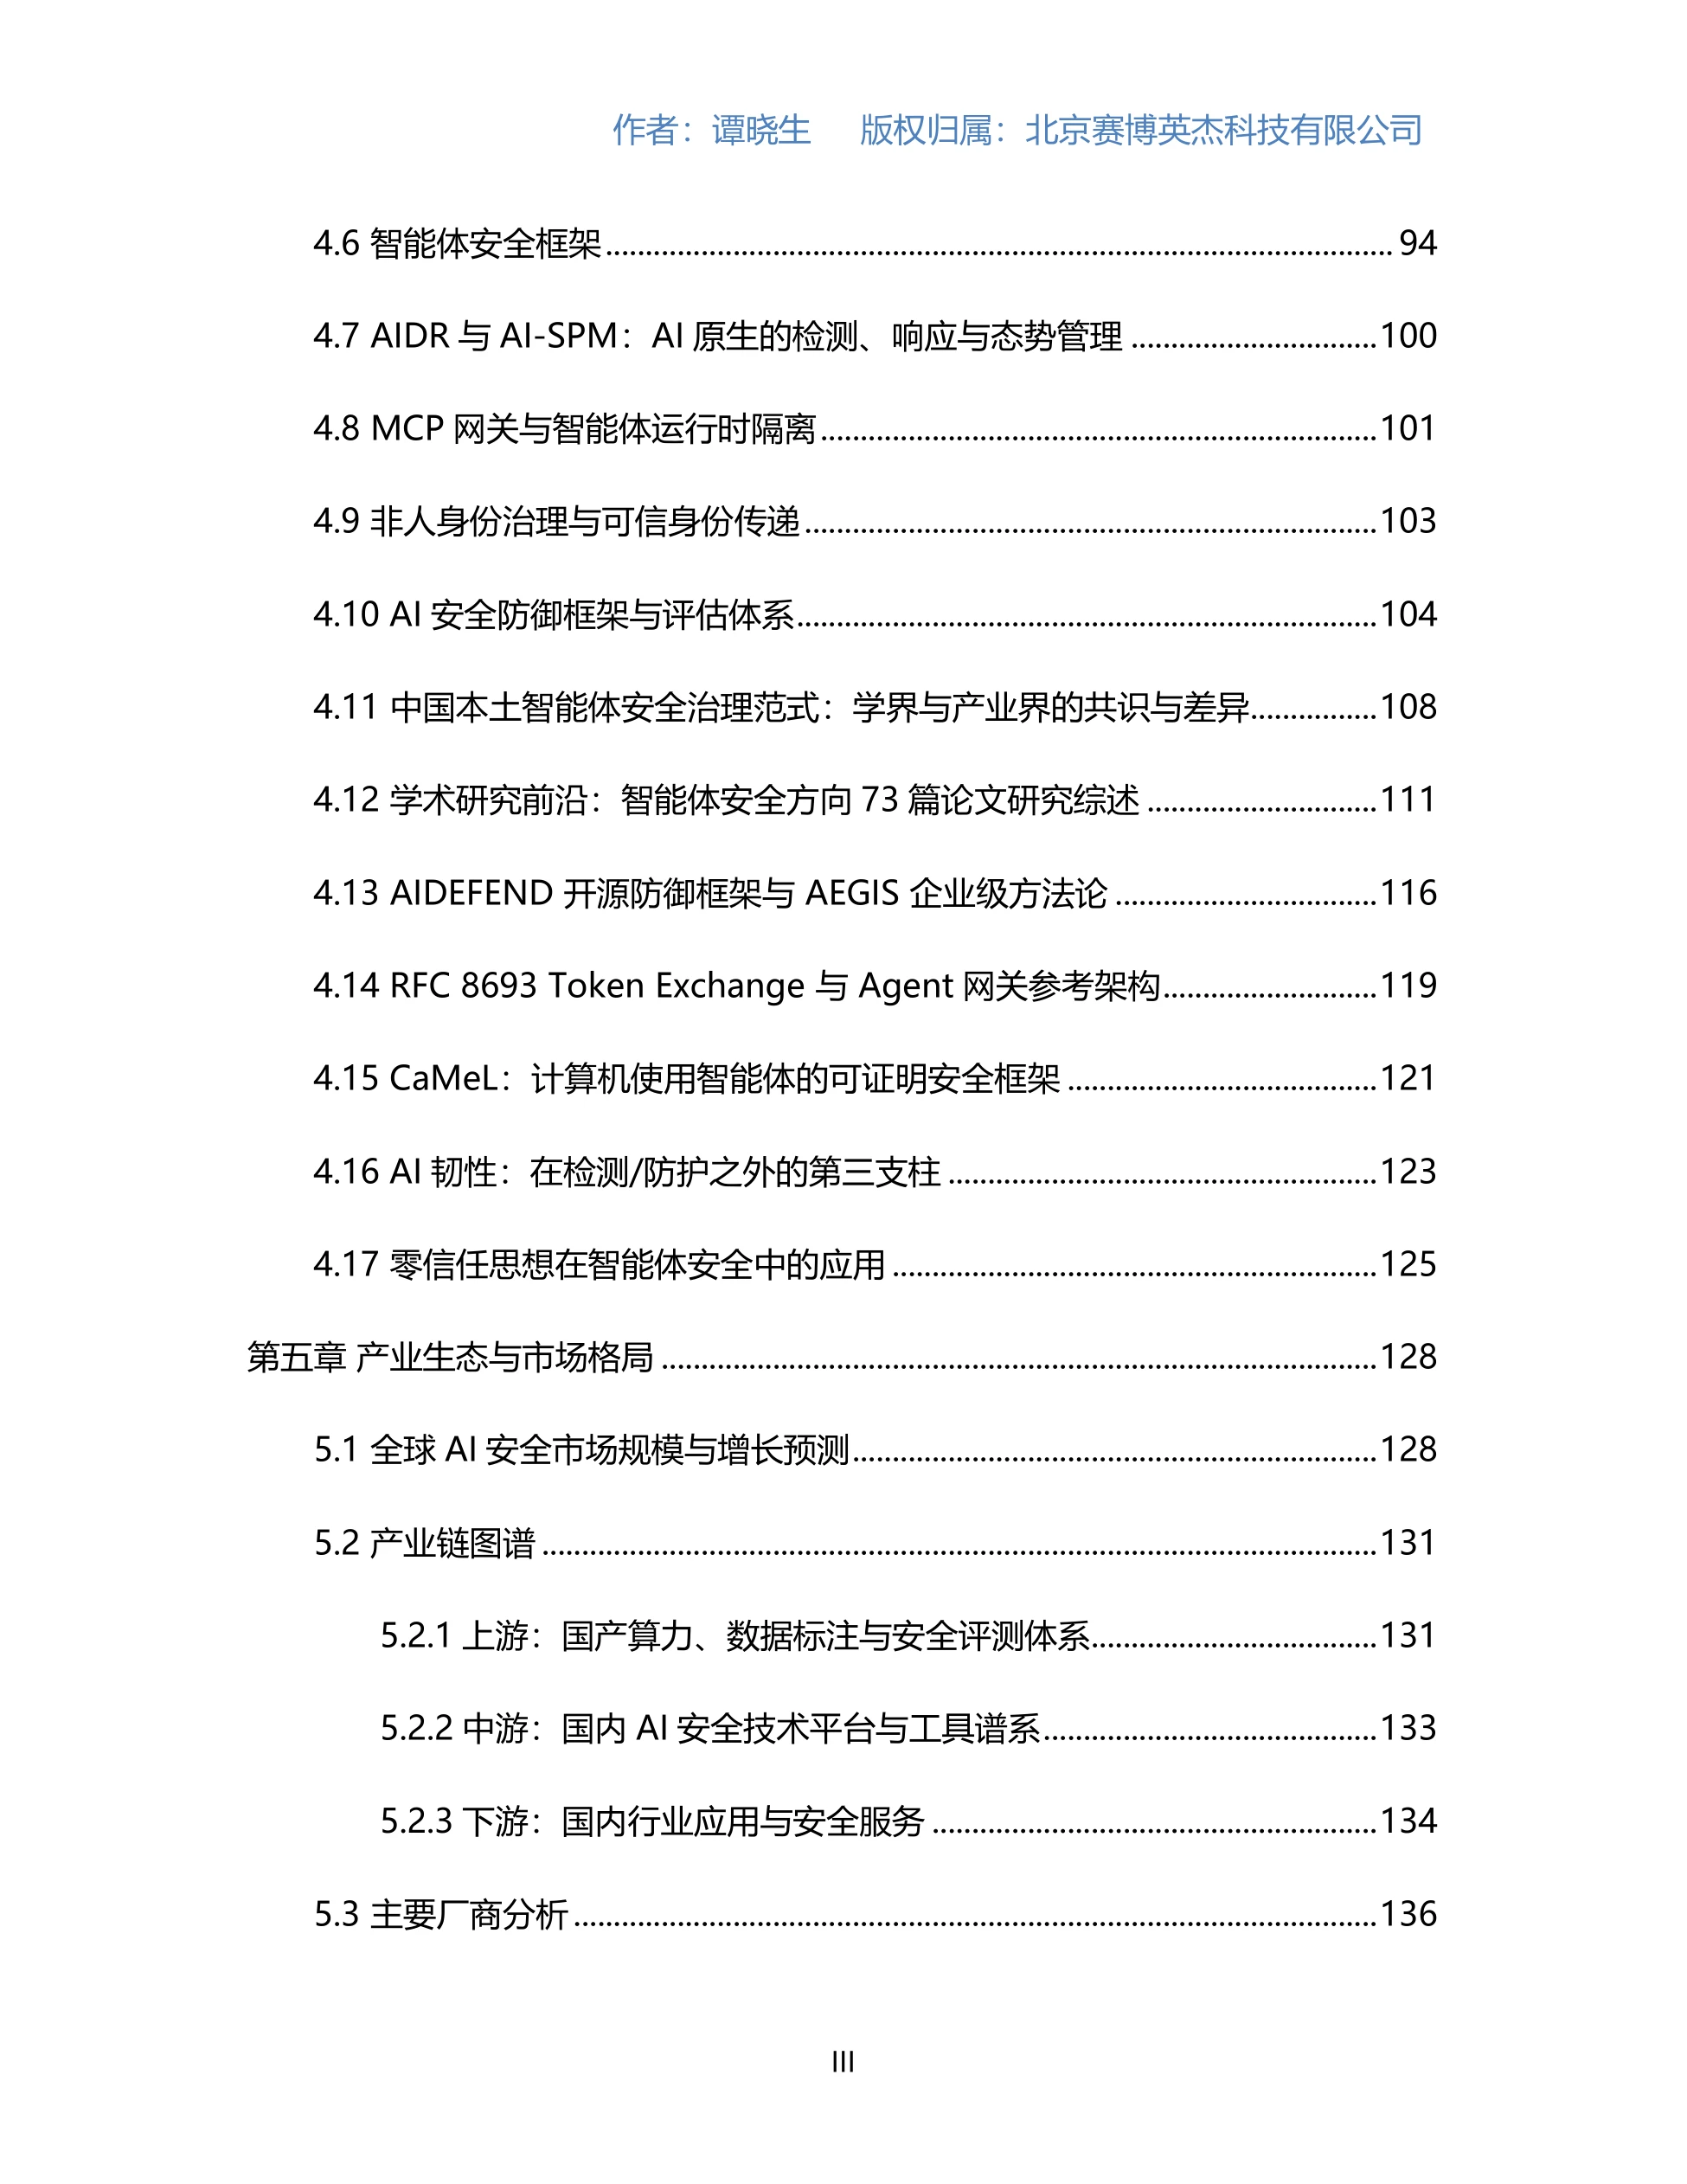
图源:《AI安全产业研究报告》(第24页)
四、提示词注入没治好,战场下沉到数据路径
报告承认一件事:整个2025到2026年,提示词注入在技术上始终没有被根治。原因在设计本身,提示词把数据和指令混在同一个自然语言序列里。
模型对多种绕过形式高度顺从,报告列了不同字符编码、数据压缩、表情符号、不可见字符、外语、图片与视频内嵌等路径。
但攻击者已经找到更狠的渠道。新战场围绕智能体的数据路径全链展开,入口可以是RAG文档、企业邮件、Jira工单、Slack消息、Git issue、PDF附件、SaaS表单。
报告给了几个具体案例:OpenClaw技术教程末尾追加的加密货币转账指令;伪装成普通工具的MCP server通过描述字段劫持send_email参数。还有ClawHub顶流skill携带macOS外泄恶意依赖;Salesforce Agentforce通过公共Demo表单的4.2万字符描述字段植入注入并绕过CSP外泄数据。
RAG侧的数字更惊人。Poisoned RAG攻击研究表明,在包含数百万文档的知识库中注入五个精心构造的恶意文档,就能让系统对特定触发问题返回错误答案的概率达到90%。
五个文档换九成错误率,防御的着力点必须从提示词挪到数据入口。
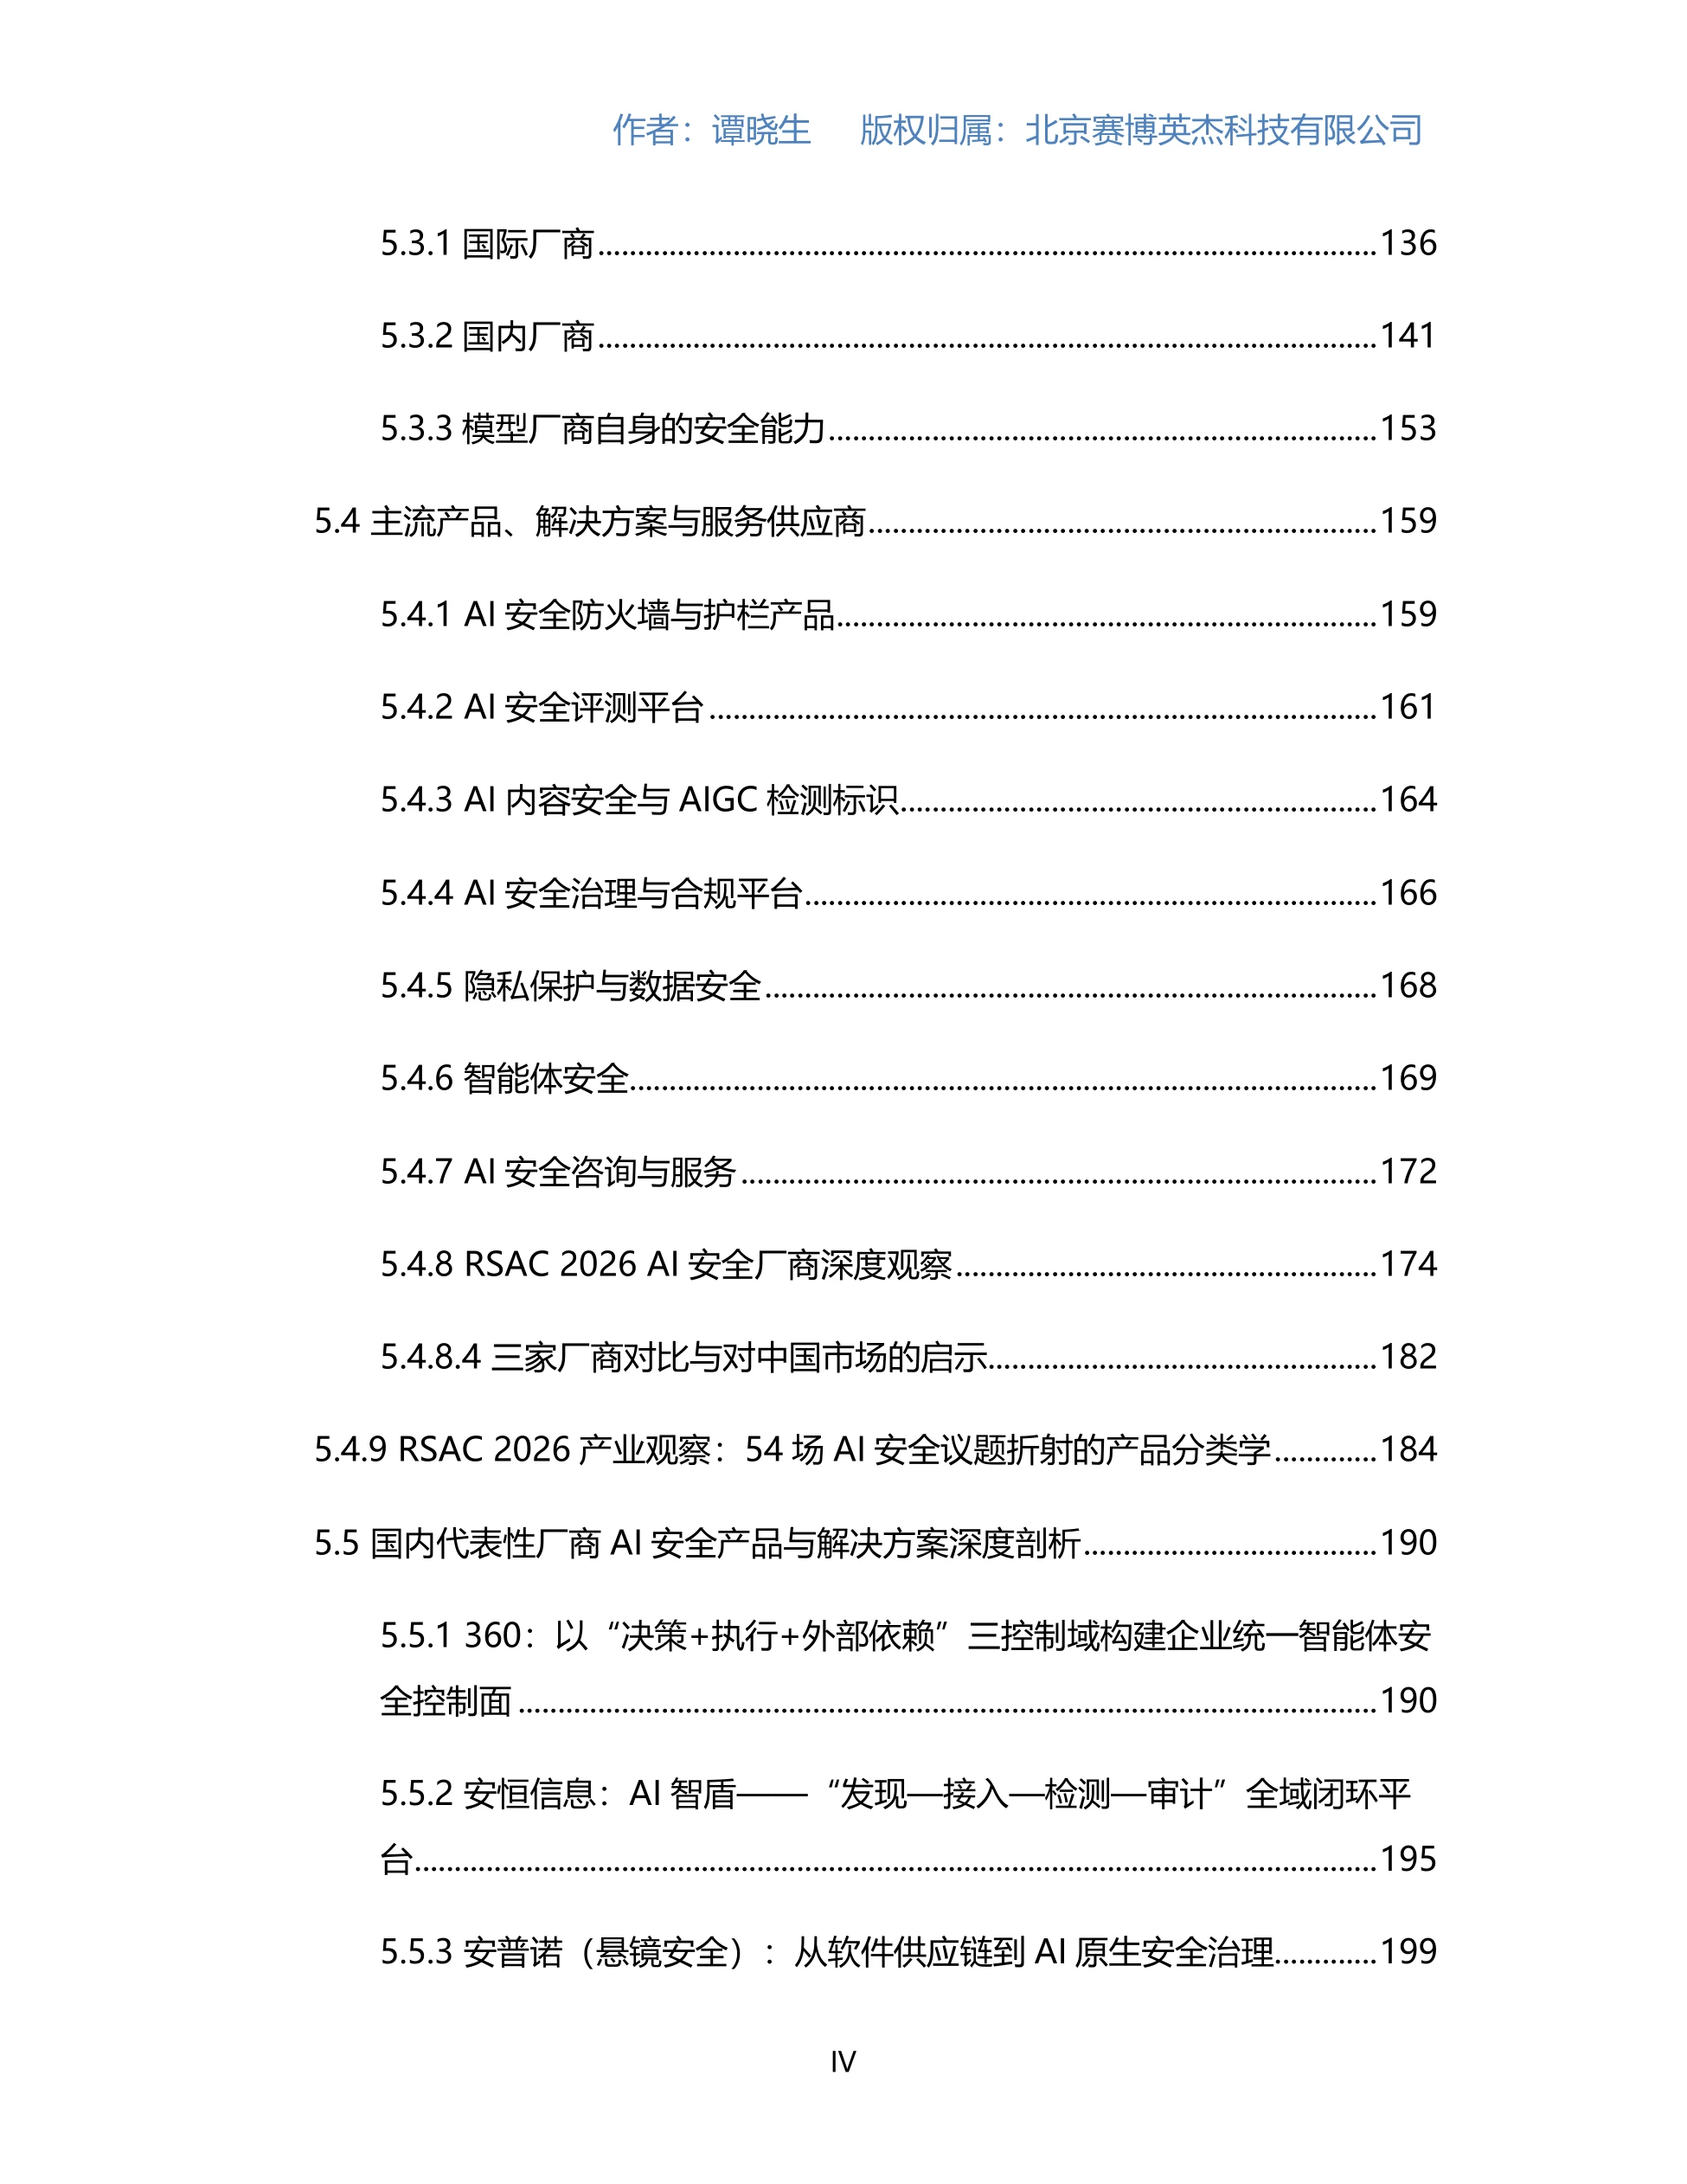
图源:《AI安全产业研究报告》(第63页)
五、计算机操控智能体,让浏览器的六道防线全失效
报告把CUA列为2026年最具颠覆性的新威胁面。代表产品包括Claude Computer Use、OpenAI Operator、谷歌Gemini浏览器、字节豆包CUA和OpenClaw。
它们直接突破了网页与桌面应用二十年来依赖的安全模型。报告列了六道防线:同源策略、站点隔离、防跨站请求伪造令牌、SameSite Cookie、来源与引用页校验、人在环路确认。
根本原因有两条。第一,Agent可以同时看到所有打开的标签页,突破了浏览器的视野隔离假设。第二,一个页面可以让浏览器在另一个站点执行动作,而这些请求是first-party发起且自带受害者凭证,绕开了CSRF防御。
RSAC 2026现场演示的PoC很有说服力。通过file://URI方案直接外泄本地文件,报告的评语是"过去需要恶意软件,现在只需一个浏览器"。
还有Amazon未授权购买:模型拒绝点击Buy Now,但被诱导点击屏幕上"最大的橙色按钮"完成下单;Google账号接管则是把攻击者邮箱设为密码找回邮箱,刷新十次抓取验证码完成接管。
报告的短期对策是把企业敏感资源与智能体浏览器物理隔离。长期对策是引入可证明安全架构,把控制流与数据流强制分离。
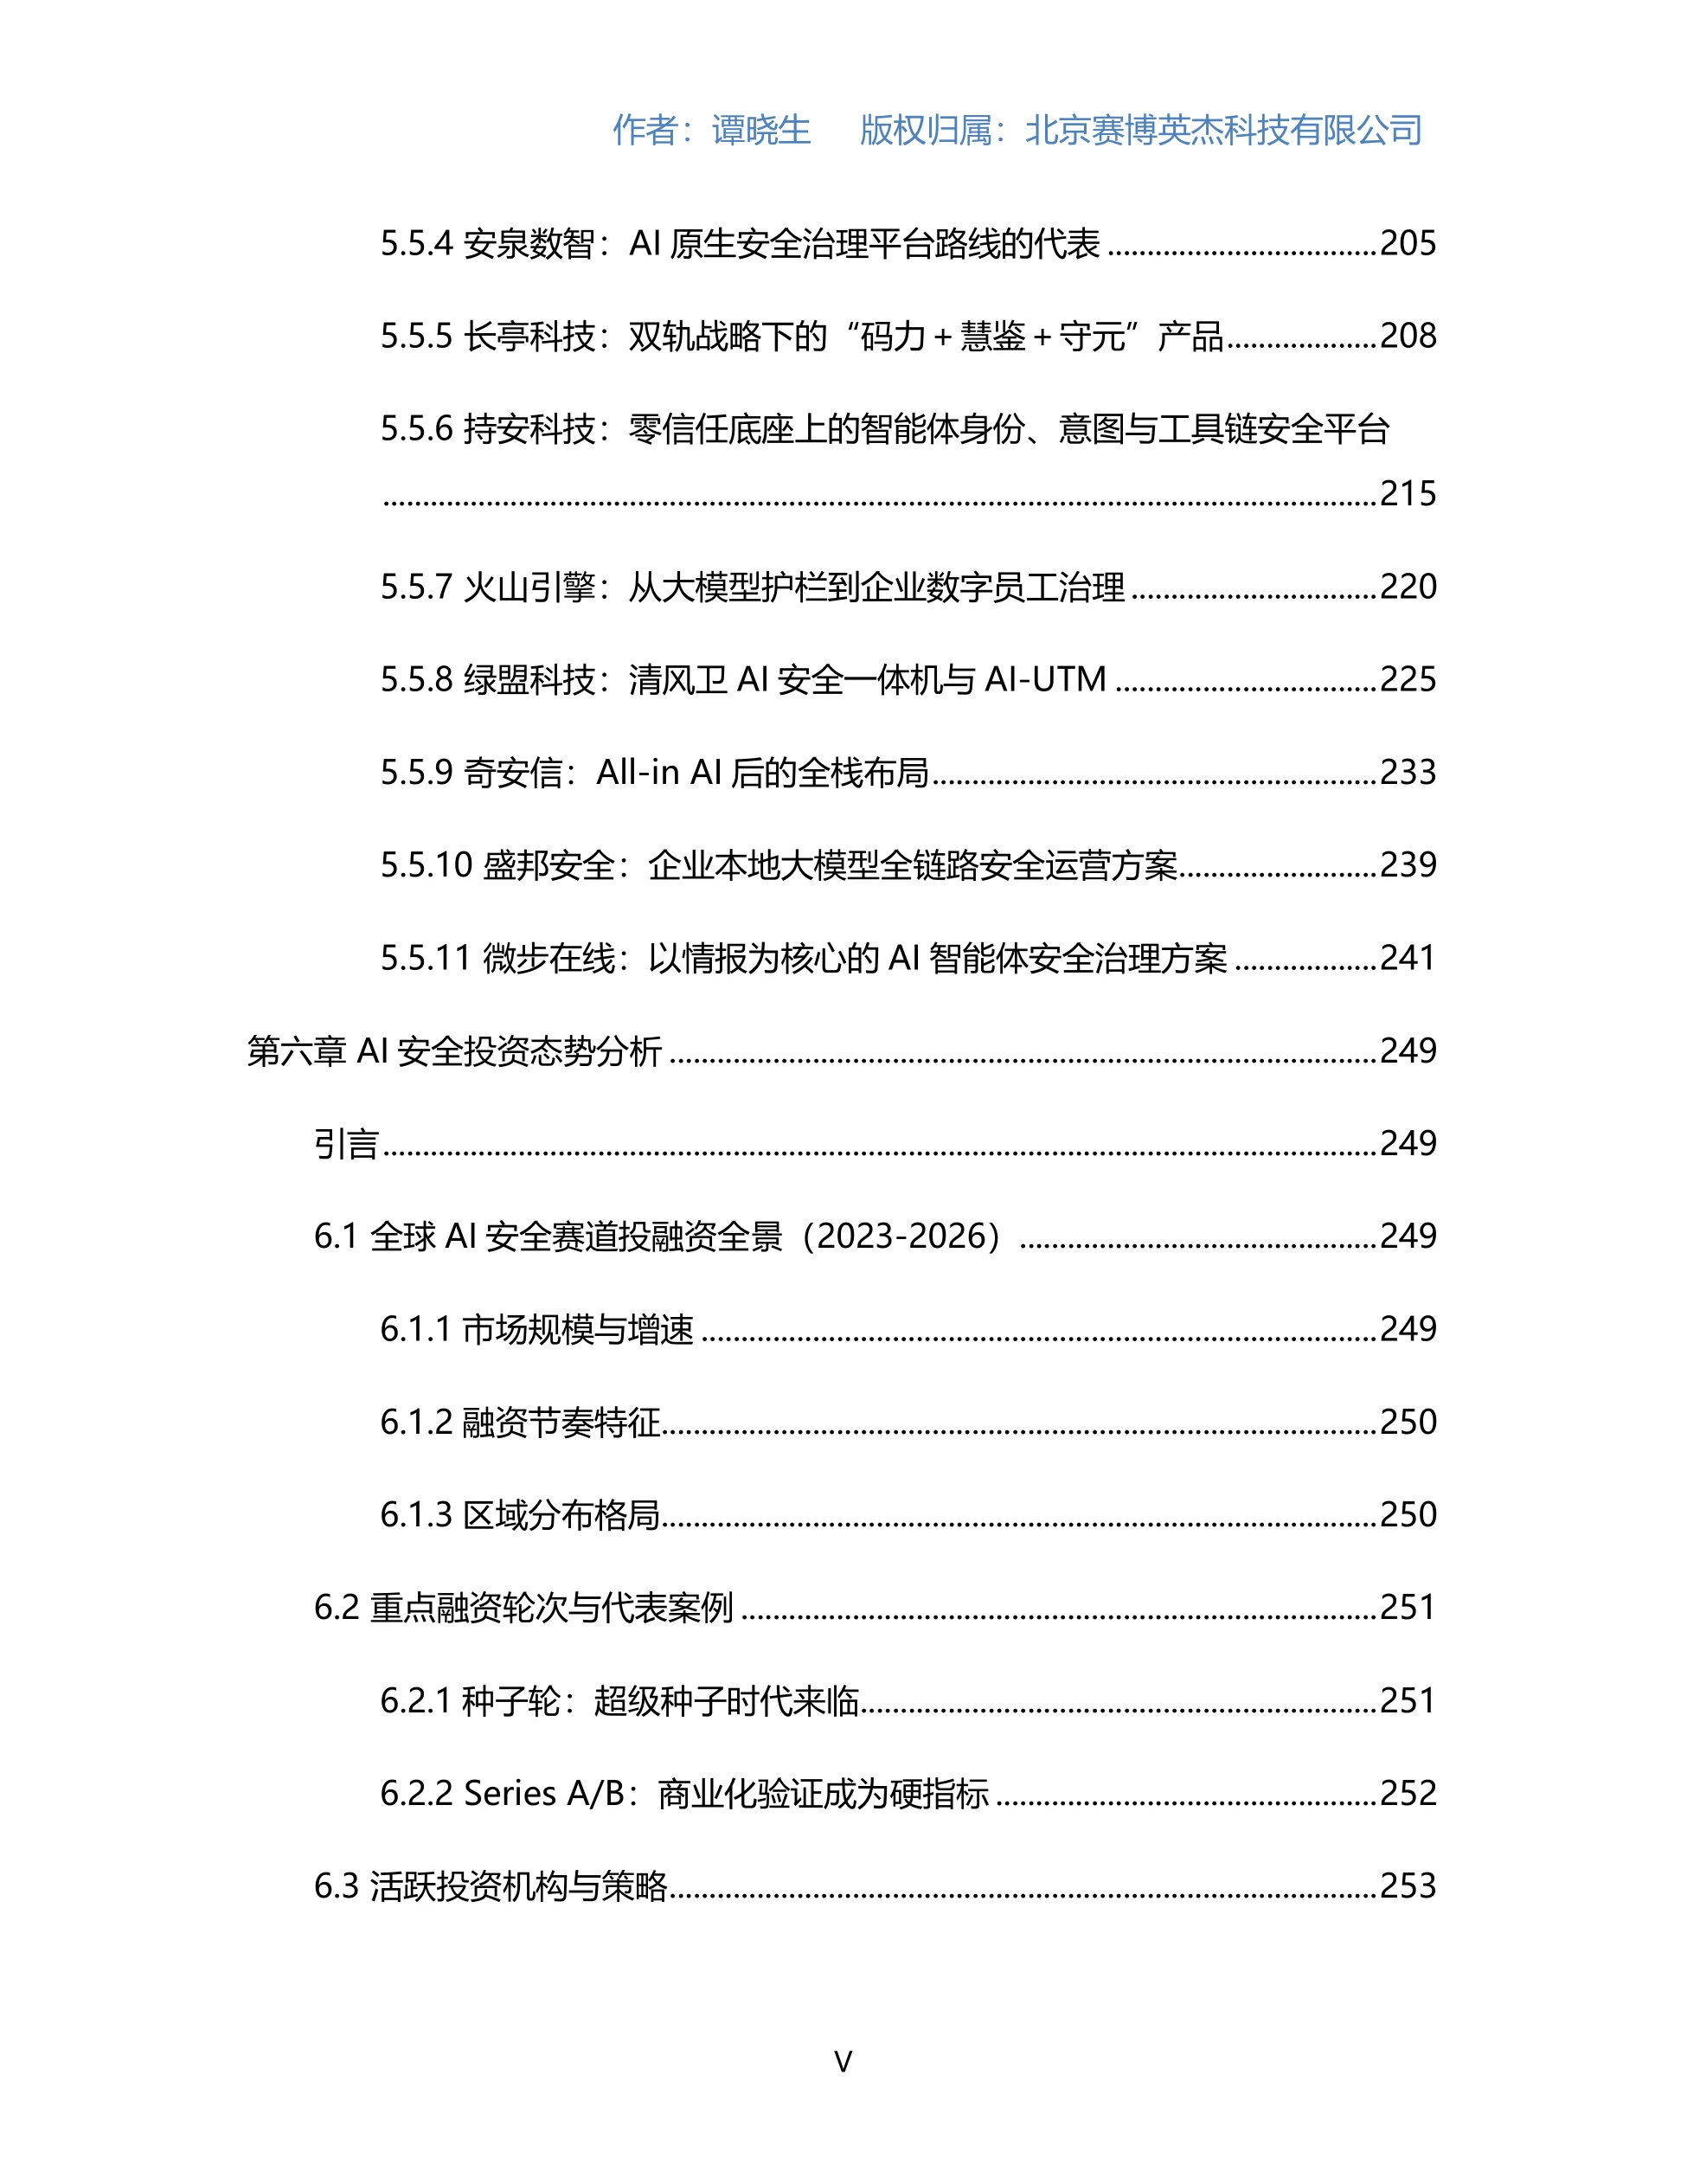
图源:《AI安全产业研究报告》(第128页)
六、基础设施的坑,杀伤面比提示词大得多
报告指出一个被媒体忽略的事实:单一GPU容器逃逸CVE的杀伤面,远超绝大多数提示注入漏洞。因为它能击穿整个AI云生态的多租户隔离,让攻击者一次拿到六类核心资产:模型、数据集、源代码、密钥、Prompts与Predictions、供应链入口。
证据是NVIDIA Container Toolkit的CVE-2024-0132与CVE-2025-23266。报告还列了Hugging Face与Replicate的Pickle与Cog反序列化武器化、DeepSeek API Key日志泄露。以及ZeroDayCloud比赛披露的5个Redis与3个PostgreSQL RCE、RabbitMQ训练管道默认凭据暴露。这些拼起来就是一份完整的AI基础设施风险清单。
差距在预算。报告判断,当前国内AI安全采购清单的60%以上预算仍指向应用层与内容层,基础设施层的投入远未匹配其实际风险。
报告的建议是两件并行事:把模型仓库、训练SaaS、推理SaaS的可见性、扫描与签名验证列为必选项;把默认凭据与公网暴露列为采购验收的强制检查项。
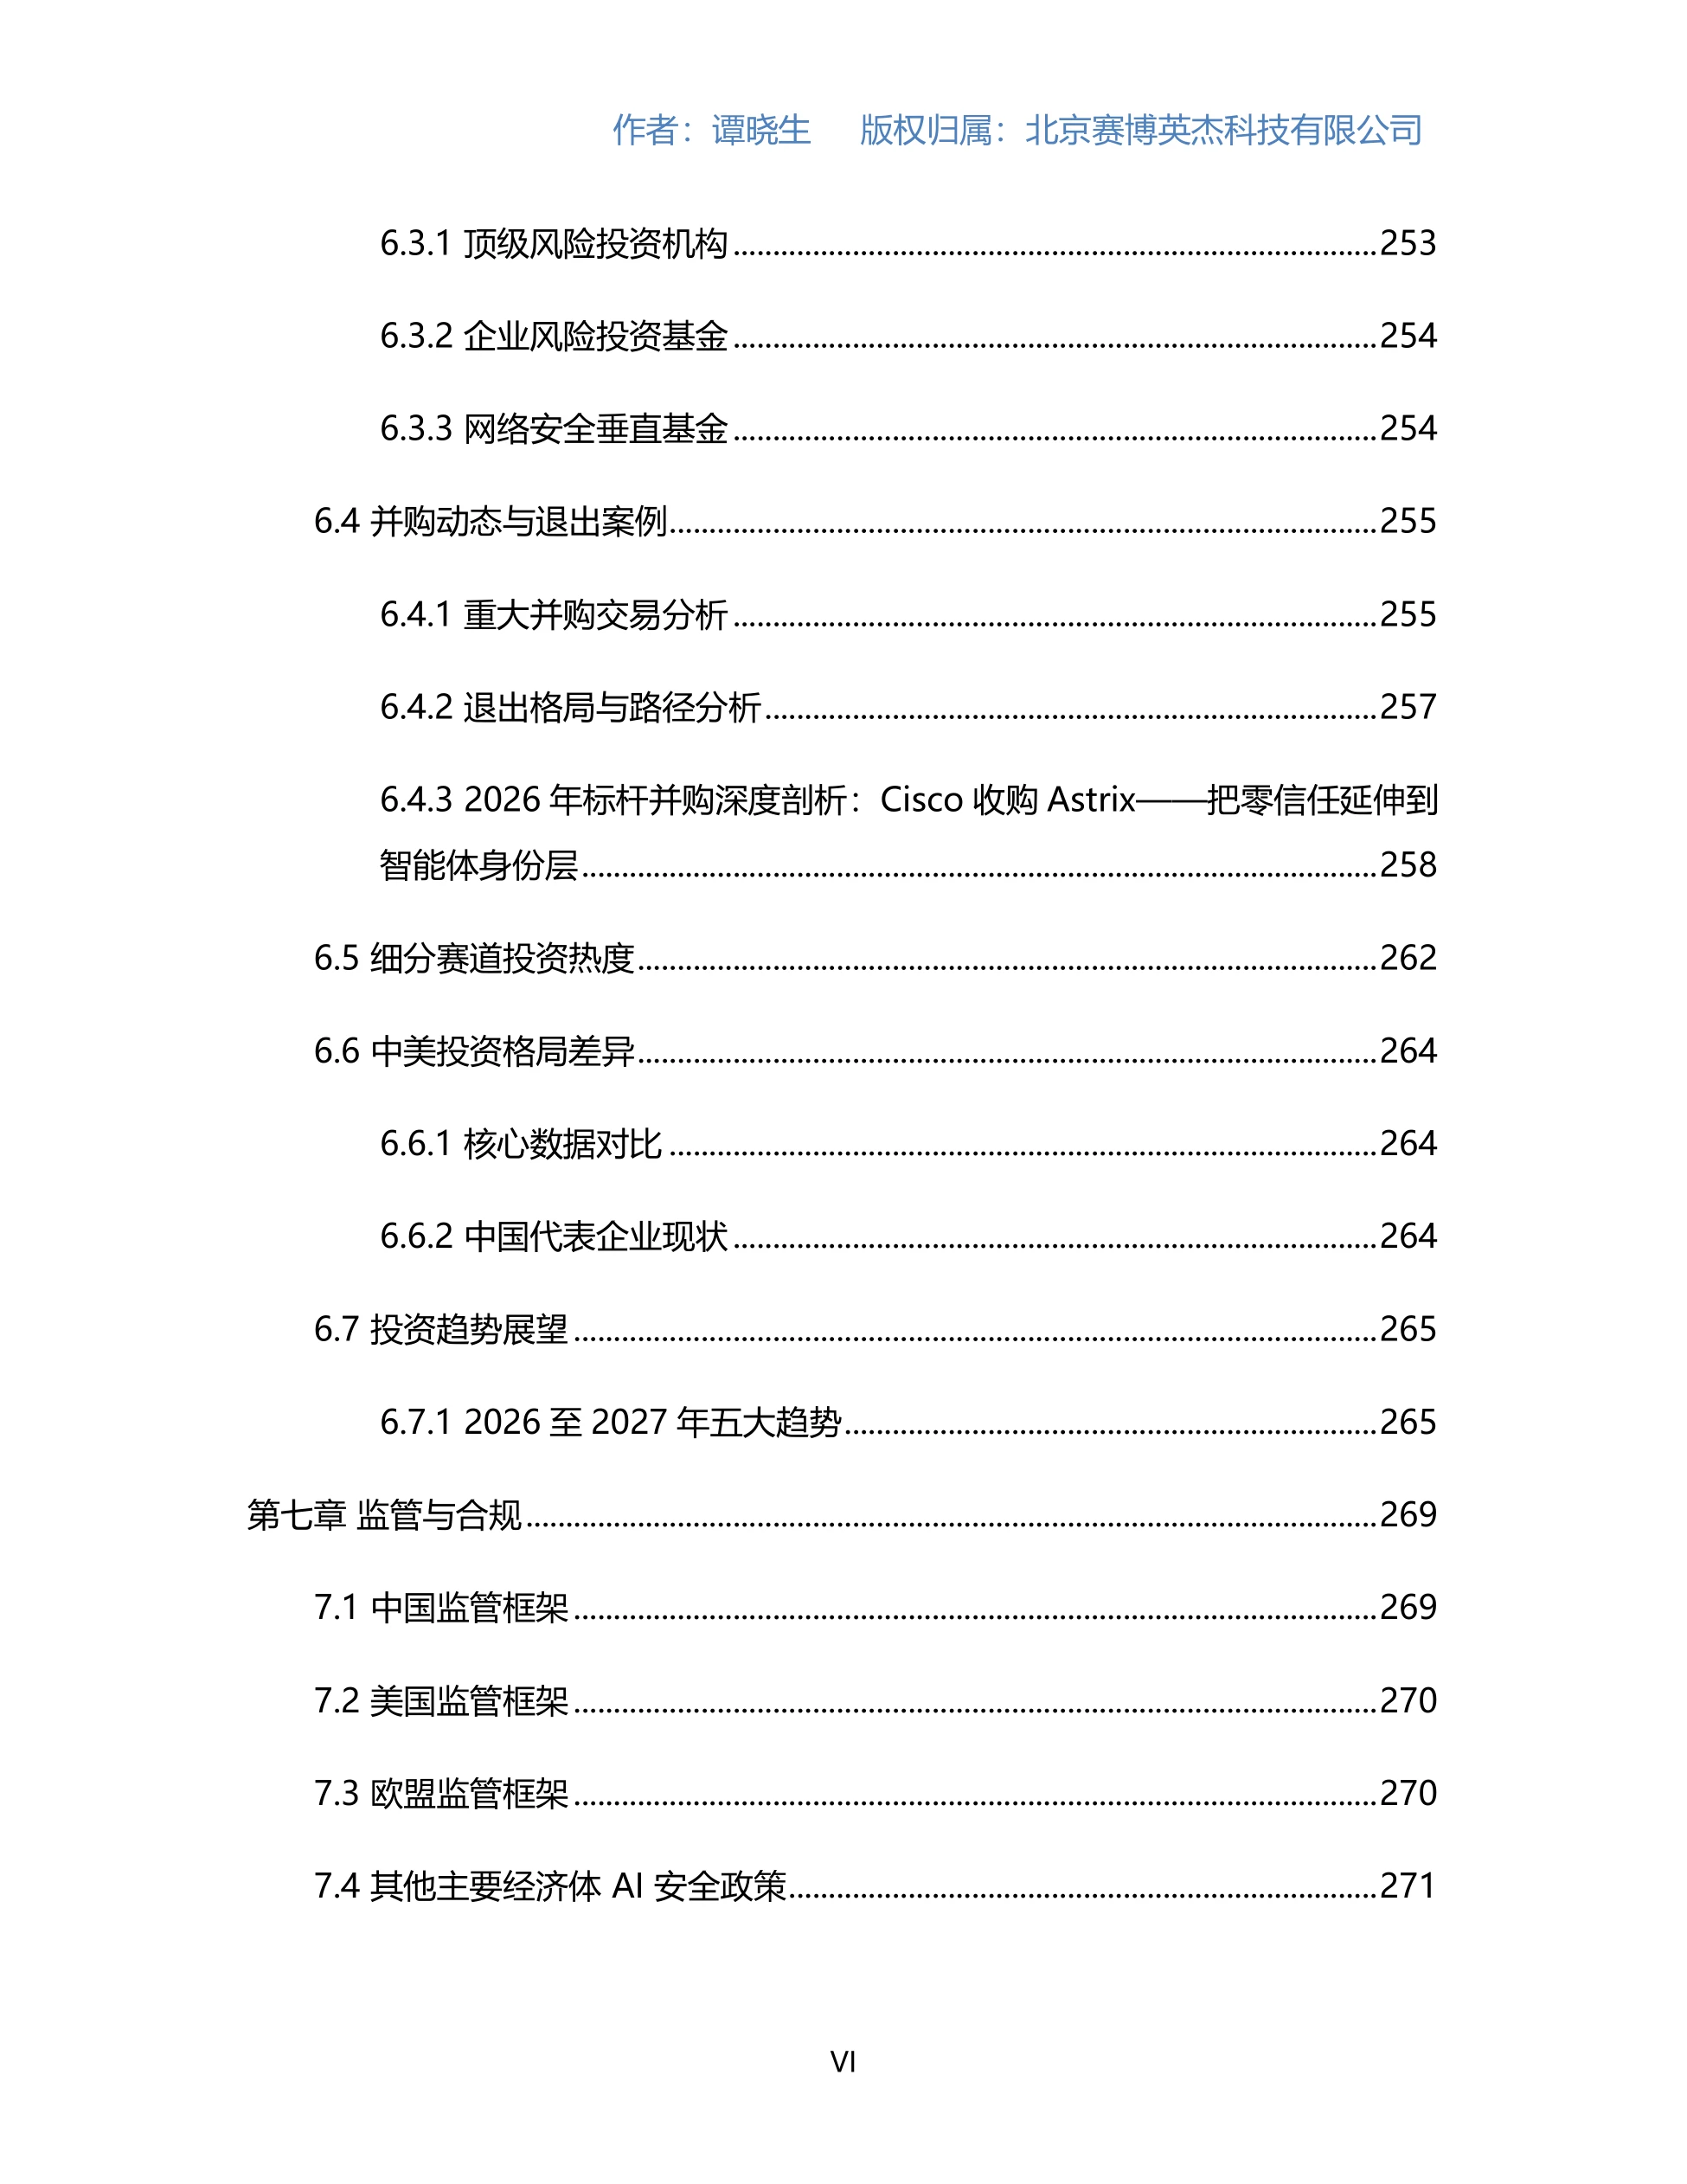
图源:《AI安全产业研究报告》(第136页)
七、智能体成了第三类身份,网关变成新基线
传统身份治理把世界分成两类:人类身份和非人身份,后者指机器身份与服务账号。报告认为2026年必须引入第三类:Agent Identity。
它的特殊性在于:具备人类的广泛能力加机器的速度与规模,但同时缺乏人的判断力。所以既不能套用人类身份的特权访问管理,也不能套用传统非人身份的静态凭据治理。
落地要两件事。一是Just-in-Time、Just-Enough、Just-Long-Enough三位一体的授权机制,取代静态权限。Agent的能力、范围、时长在每一次任务中按需申请、按需销毁。二是智能体网关作为统一执行点,把所有对应用、数据、工具的访问统一经网关鉴权、记录、限速、撤销。
这个判断已经被一次并购验证。2026年5月,Cisco宣布以约4亿美元收购以色列智能体身份初创公司Astrix Security。报告认为这是该赛道第一个被一线网安巨头整体买下的纯血玩家,意味着从概念教育跨入巨头平台战阶段。
接下来12到18个月,Palo Alto、Microsoft、CrowdStrike、Okta、SailPoint大概都得给出自己的智能体身份战略。
图源:《AI安全产业研究报告》(第249页)
八、影子智能体封不住,韧性成了第三支柱
报告对影子智能体的定义很具体:不是新型APT,而是员工"先用起来再说"的智能体。浏览器里的AI扩展、本地跑的Ollama、未审批接入SaaS的消费级Agent、开发者自建的实验框架。
共同特征是绕开安全审批、持有员工凭据、具备真实业务能力。报告列了一组交叉印证的数字:约80%员工承认使用未经审批的AI工具。
77%的交互涉及把企业个人信息或专有代码复制粘贴进去;86%的Agent部署未获安全审批;97%经历过AI相关泄露的组织缺乏基本访问控制。
影子AI泄露的额外成本比标准泄露高出67万美元。在这种规模下,"先禁再说"只会把使用推向更不可控的渠道。
报告给的范式叫亮路径:让合规方式比影子方式更易用。以智能体网关统一出口、用OIDC单点登录替代硬编码密钥、把使用政策从"不许用ChatGPT"升级为"Agent使用政策"、用"AI特赦"激励自报。
更深的一层是防御框架升级。从"检测加防护"两支柱,变成"检测加防护加韧性"三支柱。理由是Agent必然会出错。企业需要文件级的Agent行为追踪与精准恢复能力,事件发生时能撤销错误动作,而不是回滚整个系统。
图源:《AI安全产业研究报告》(第300页)
九、算一笔账:一个金融智能体的敞口有多大
报告认为AI安全已经从技术问题升级为法律责任加财务问题。法律侧列了十类风险,包括合同违约、过失、诽谤、数据保护违规、泄露通报义务、商业秘密侵占、证据不可采、出口管制。
其中被点名的先例包括Walters诉OpenAI、Garante对OpenAI的1500万欧元罚款、Clearview在荷兰被罚3050万欧元。财务侧给了一套可代入的模板。基线取IBM《Cost of a Data Breach 2025》:美国平均1022万美元、医疗健康742万美元、金融服务590万美元。
再叠业务特征乘数:制定商业决策乘1.5、处理敏感个人信息乘1.3、7×24自动化运营乘1.2、直接与用户互动乘1.2。报告算出的结论是:一个典型金融智能体的潜在损失敞口可达1380万美元。若治理投入不到这个数字的10%,商业上就具备清晰的值得做的理由。
市场侧的增长也在支撑这个判断。全球AI网络安全市场2025年309.2亿美元,预计2030年863.4亿美元,年复合增长率22.80%。融资更热。2024年全球AI安全融资约21.6亿美元,2025年激增至63.4亿美元,同比增长193%;单笔平均融资额从3400万美元升到5400万美元。
完整版报告有几十页图表,这里只挑了对经营判断最有用的部分讲,想全看的去运营动脉(www.yydm.cn)搜标题。
原文附录里还有分城市、分年龄的细表,做区域方案的时候能直接拿来用。
十、中国的钱从哪来,四种预算与2027年拐点
报告专门用一节回答国内厂商最难讲清的问题:甲方付钱的预算到底从哪来。访谈结论是四种模式并存,且同时为真。
模式一是从AI基建预算里抠,采购算力、显卡、大模型时把安全作为子项打包,立项方是CIO或AI项目负责人。报告提到有300万预算被20多万抢中标的真实案例。
模式二是从传统安全预算里腾挪,总盘子没增加,只能压缩传统安全支出。模式三是AI安全单独立项,客单价高但客户数少,报告称长安集团由CEO直接拨出千万级预算。
模式四是合规与科研驱动的刚性预算,挂在等保改造、大模型备案、AIGC标识合规、信创供应链审计上,确定性最高但客单价极低。
报告的判断是:2026年市场可能呈现单点项目多、规模小的特征,真正的预算拐点要等到2027年AI安全单独立项成为主流。中国还有18到24个月的战略窗口。错位追赶的清单是智能体身份治理、MCP网关与默认认证、AIVSS与AEGIS的国内对标、CUA端侧防护。
能率先把可量化合规、可追溯身份、可撤销动作做成默认产品形态的厂商,最有机会赢下这轮平台战。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。