AIDC是什么?50页白皮书讲清智算中心怎么建
 广告
本文解读:《AIDC白皮书》 · 共 50 页 · 原文
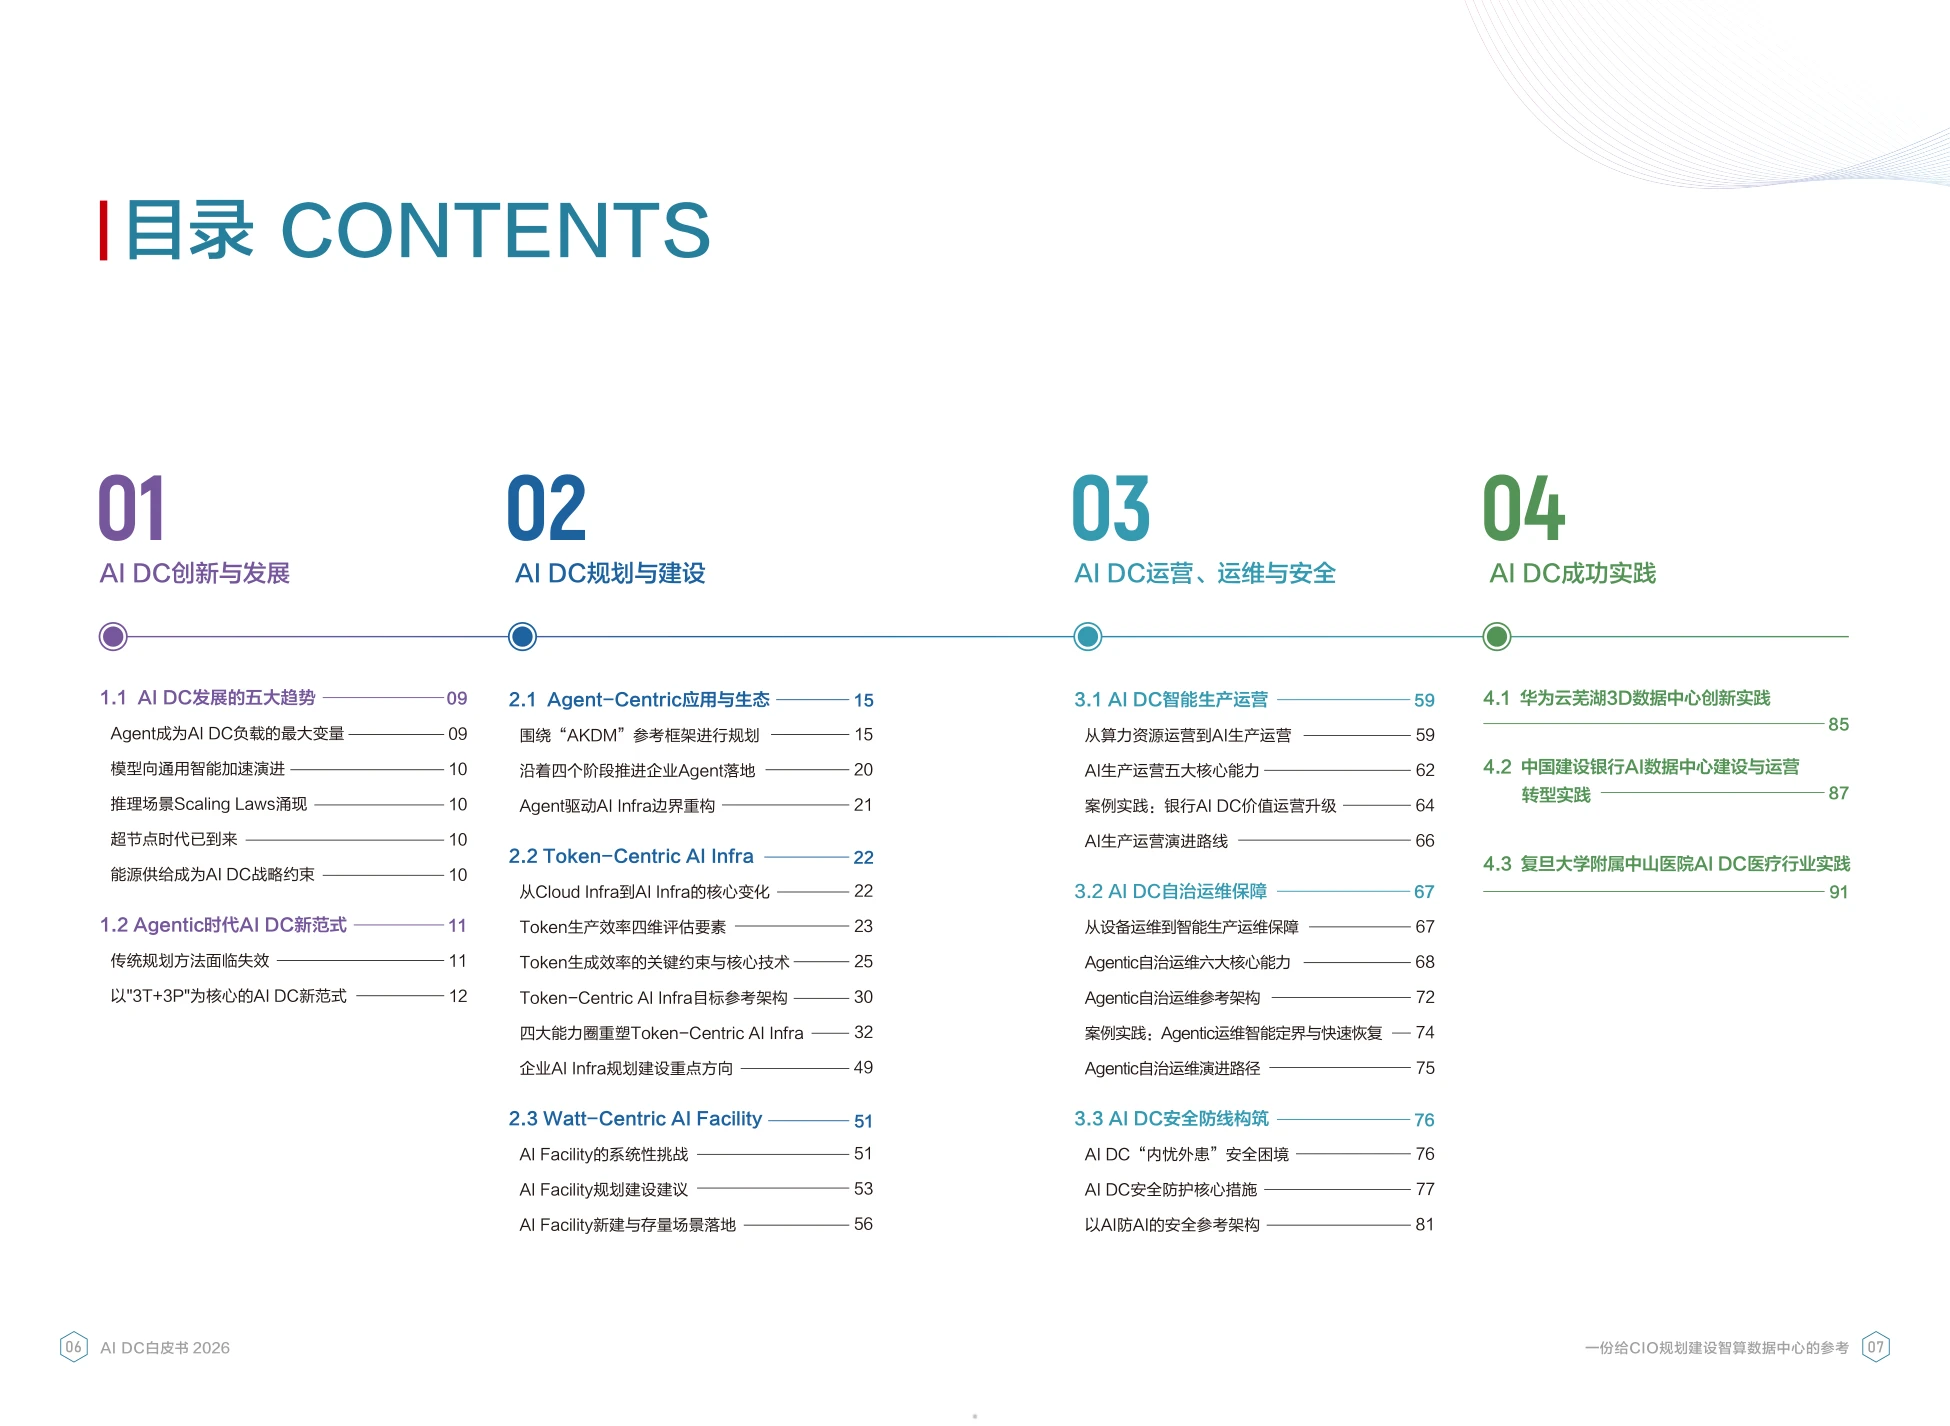
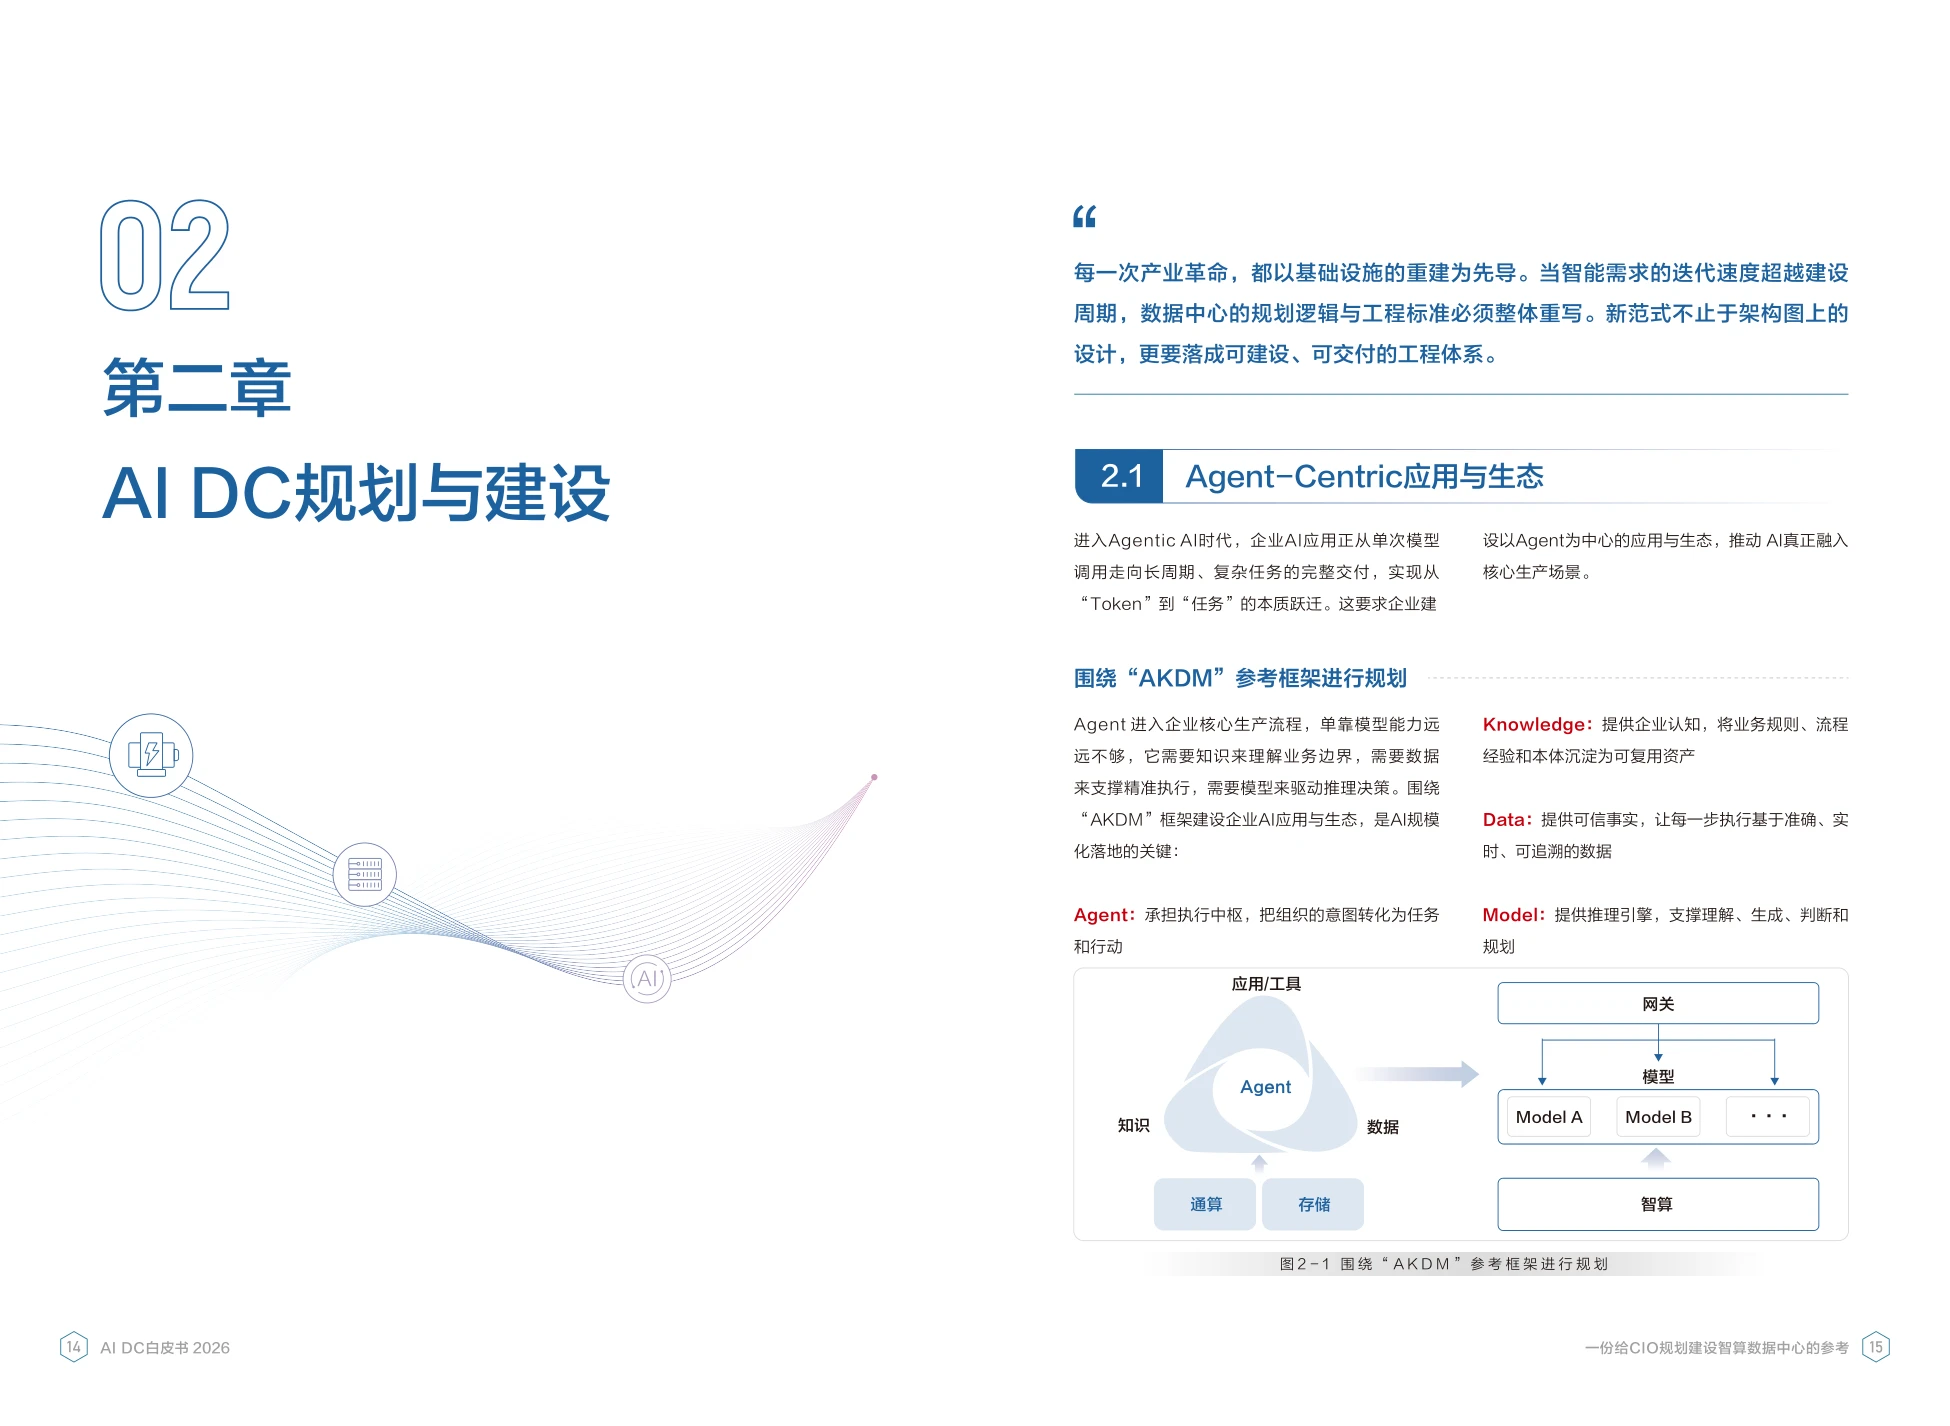
过去建数据中心问的是"放多少台服务器",现在要问"每天能产出多少有效Token"。《AI DC白皮书2026》由华为与中国建设银行联合发布,共50页,定位是给CIO的规划建设参考,分为创新与发展、规划与建设、运营运维安全、成功实践四章。
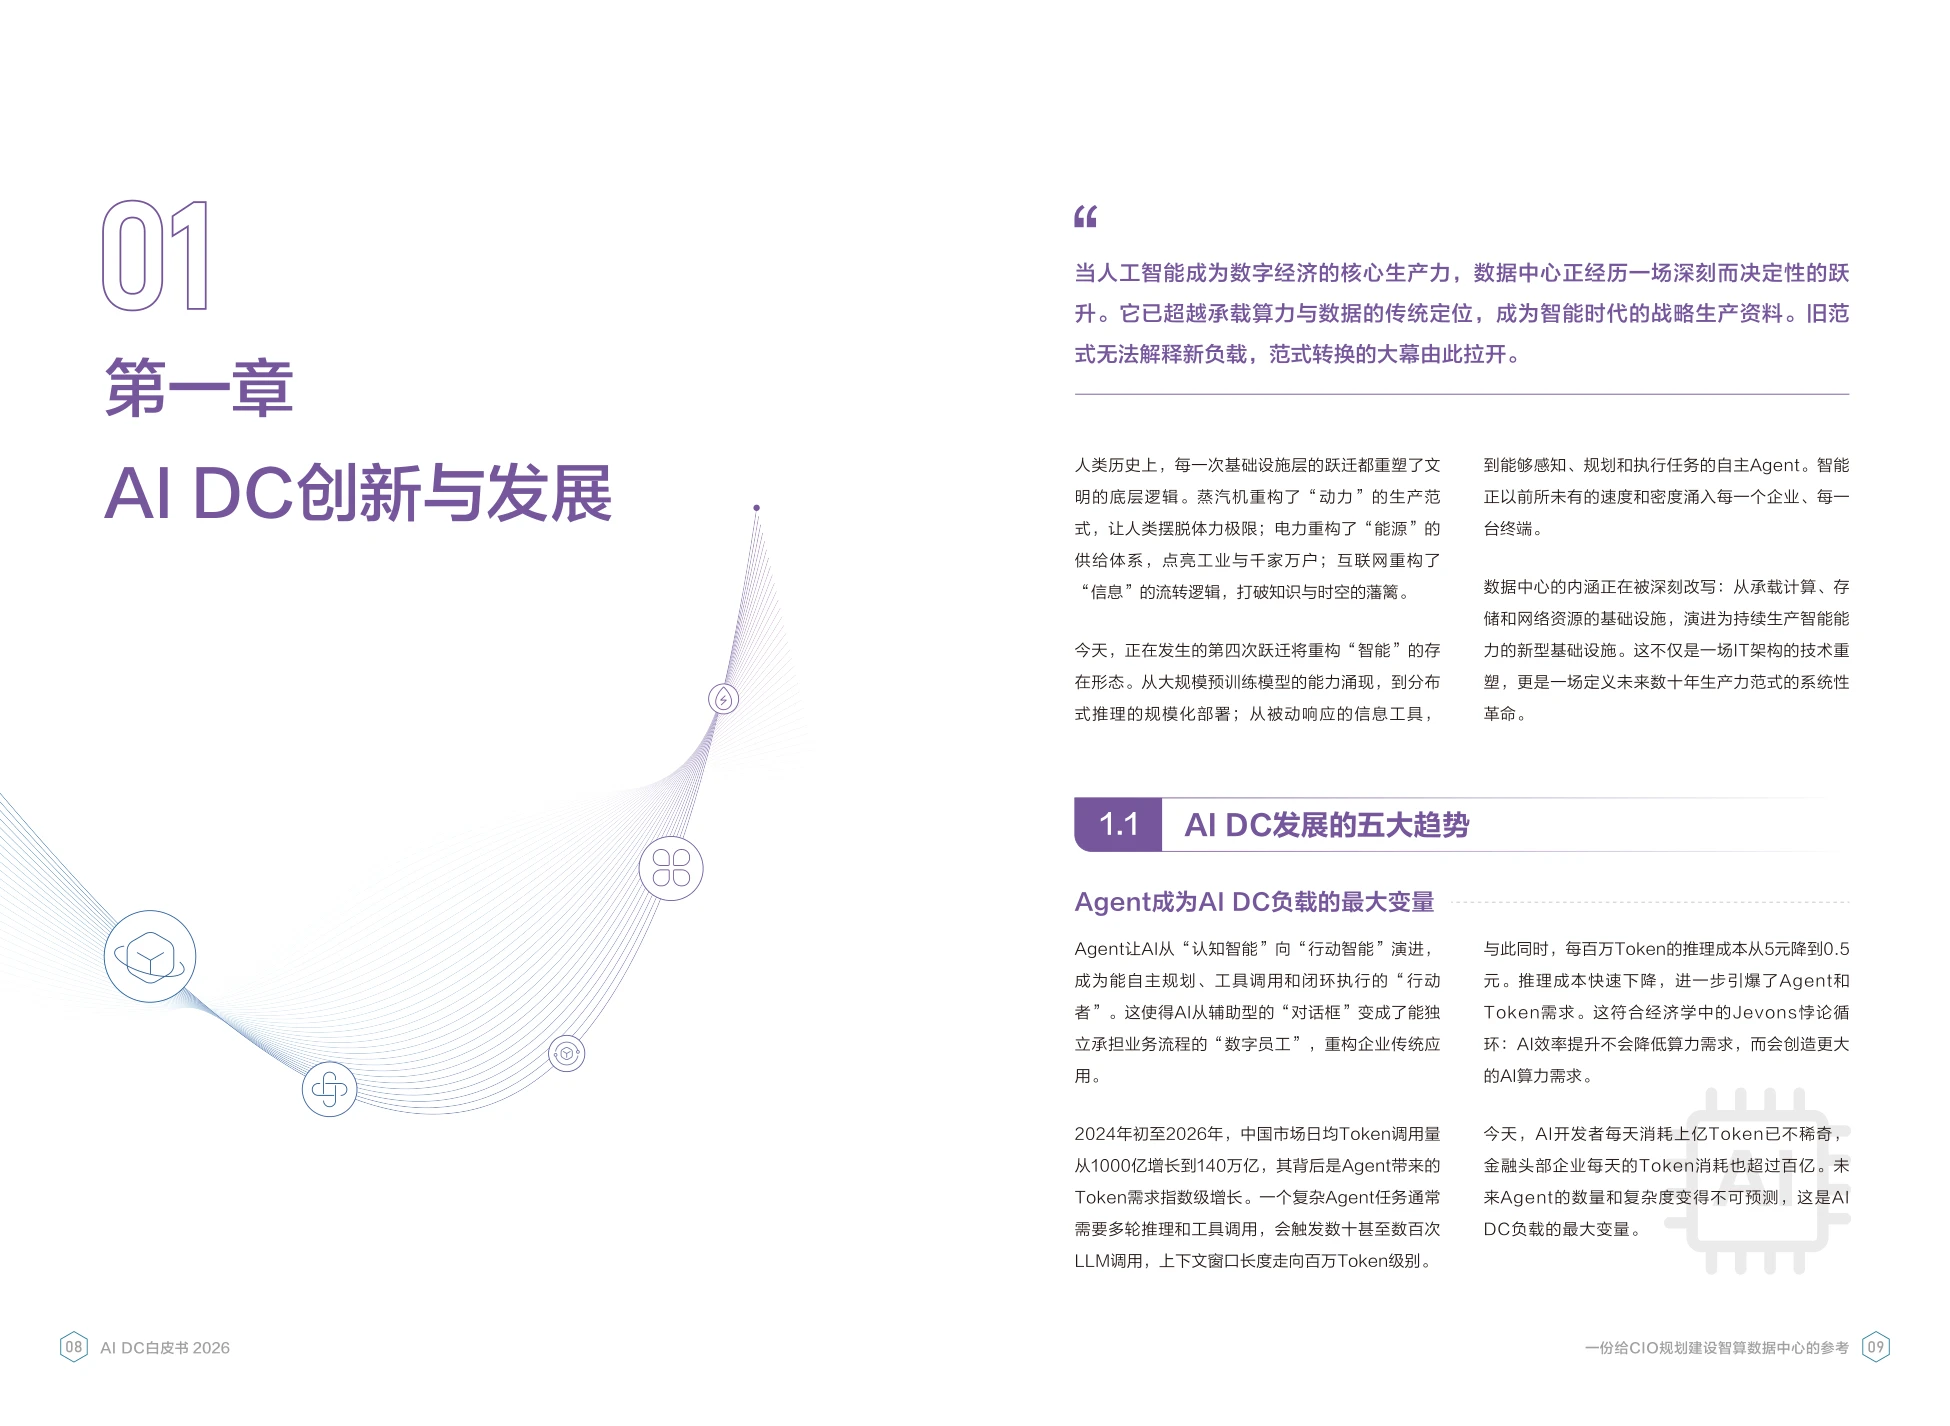
它给出的新框架叫3T加3P:AgenT驱动应用、Token决定算力运营、WatT约束物理支撑,再配上生产运营、运维保障、安全防线三条保障线。支撑这套框架的数字很硬。2024年初到2026年,中国市场日均Token调用量从1000亿涨到140万亿,同期每百万Token的推理成本从5元降到0.5元。
成本降十倍、需求涨千倍,这不是扩容问题,是机房的设计逻辑要重写。
图源:《AIDC白皮书》(第1页)
一、AI DC不只是机房升级,衡量的单位换了
报告对AI DC的定义是:面向AI负载重构的新一代数据中心,是支撑大模型迭代与AI Agent规模化应用的"算力工厂"。它和传统IDC的区别不在功率,在定位。报告的原话是,数据中心正从"资源供给系统"变成"算力生产系统"。
衡量标准也跟着换。从"拥有多少XPU"变成"能产出多少Token",从成本中心变成价值中心。报告的判断有现实依据:2025至2026年中国头部科技企业AI相关资本开支同比普遍增长50%以上,其中字节跳动2026年在AI基础设施领域的投入规模已上调至2000亿元以上。
组织形态也在变。头部企业的AI基础设施团队正从"运维成本中心"转向"AI产能运营部门",业务部门盯的不再是机柜数量,而是每天的有效Token产出。
一旦开始按Token考核机房,采购、建设、运维三套流程都得跟着改。
图源:《AIDC白皮书》(第3页)
二、五个趋势里,Agent是最大的变量
报告列了五条趋势。第一条是模型向通用智能加速演进,大参数模型突破能力上限,中小模型主攻单位Token、单位算力的效率。
报告举的例子是GPT-5.6系列:轻量版Luna模型的后训练,已经可以由旗舰版Sol模型自主完成。第二条是Agent成为AI DC负载的最大变量。一个复杂Agent任务通常需要多轮推理和工具调用,触发数十甚至数百次大模型调用,上下文窗口走向百万Token级。
第三条是推理场景的Scaling Laws涌现。推理效果不再只由模型大小决定,推理时投入的计算量成为新变量,代价是单请求算力消耗和时延同步攀升。
第四条是超节点时代到来。单颗芯片性能逼近物理极限后,只能靠系统化工程突破,华为的韬定律讲的就是器件、电路、芯片、系统四层协同。
第五条是能源供给成为战略约束。超大型数据中心从MW级迈向GW级,一座GW级AI DC的用电量堪比百万人口城市。
图源:《AIDC白皮书》(第6页)
三、旧方法为什么失效,报告点了三处
第一处是业务规划失效。Agentic AI时代,一个新Agent或新模型可能在3个月内从起步变成全网爆火,带动Token需求暴涨百倍。用历史业务做线性外推已经不成立。报告用Google做例子:2022年AI资本开支约310亿美元,2026年预计接近1900亿美元,四年增长超过5倍。
第二处是架构范式失效。传统分层解耦建立在"技术慢速变化、系统稳定"的假设上,而模型迭代从年度变成季度甚至月度,芯片微架构周期从24个月缩到12至18个月。
物理层的冲击更直接。单机柜功率从5至8千瓦跃升到40至120千瓦,传统风冷极限约20千瓦每柜,液冷从可选项变成必选项。
第三处是时间窗口错位。企业拿到NPU后希望3到6个月投产,但传统数据中心建设周期长达12到24个月,机房准备节奏系统性滞后于IT设备迭代。
三处叠加,结论很清楚:沿用旧方法论规划AI DC,规划出来的一定是错的。
图源:《AIDC白皮书》(第9页)
四、3T加3P,把规划拆成六个可算的维度
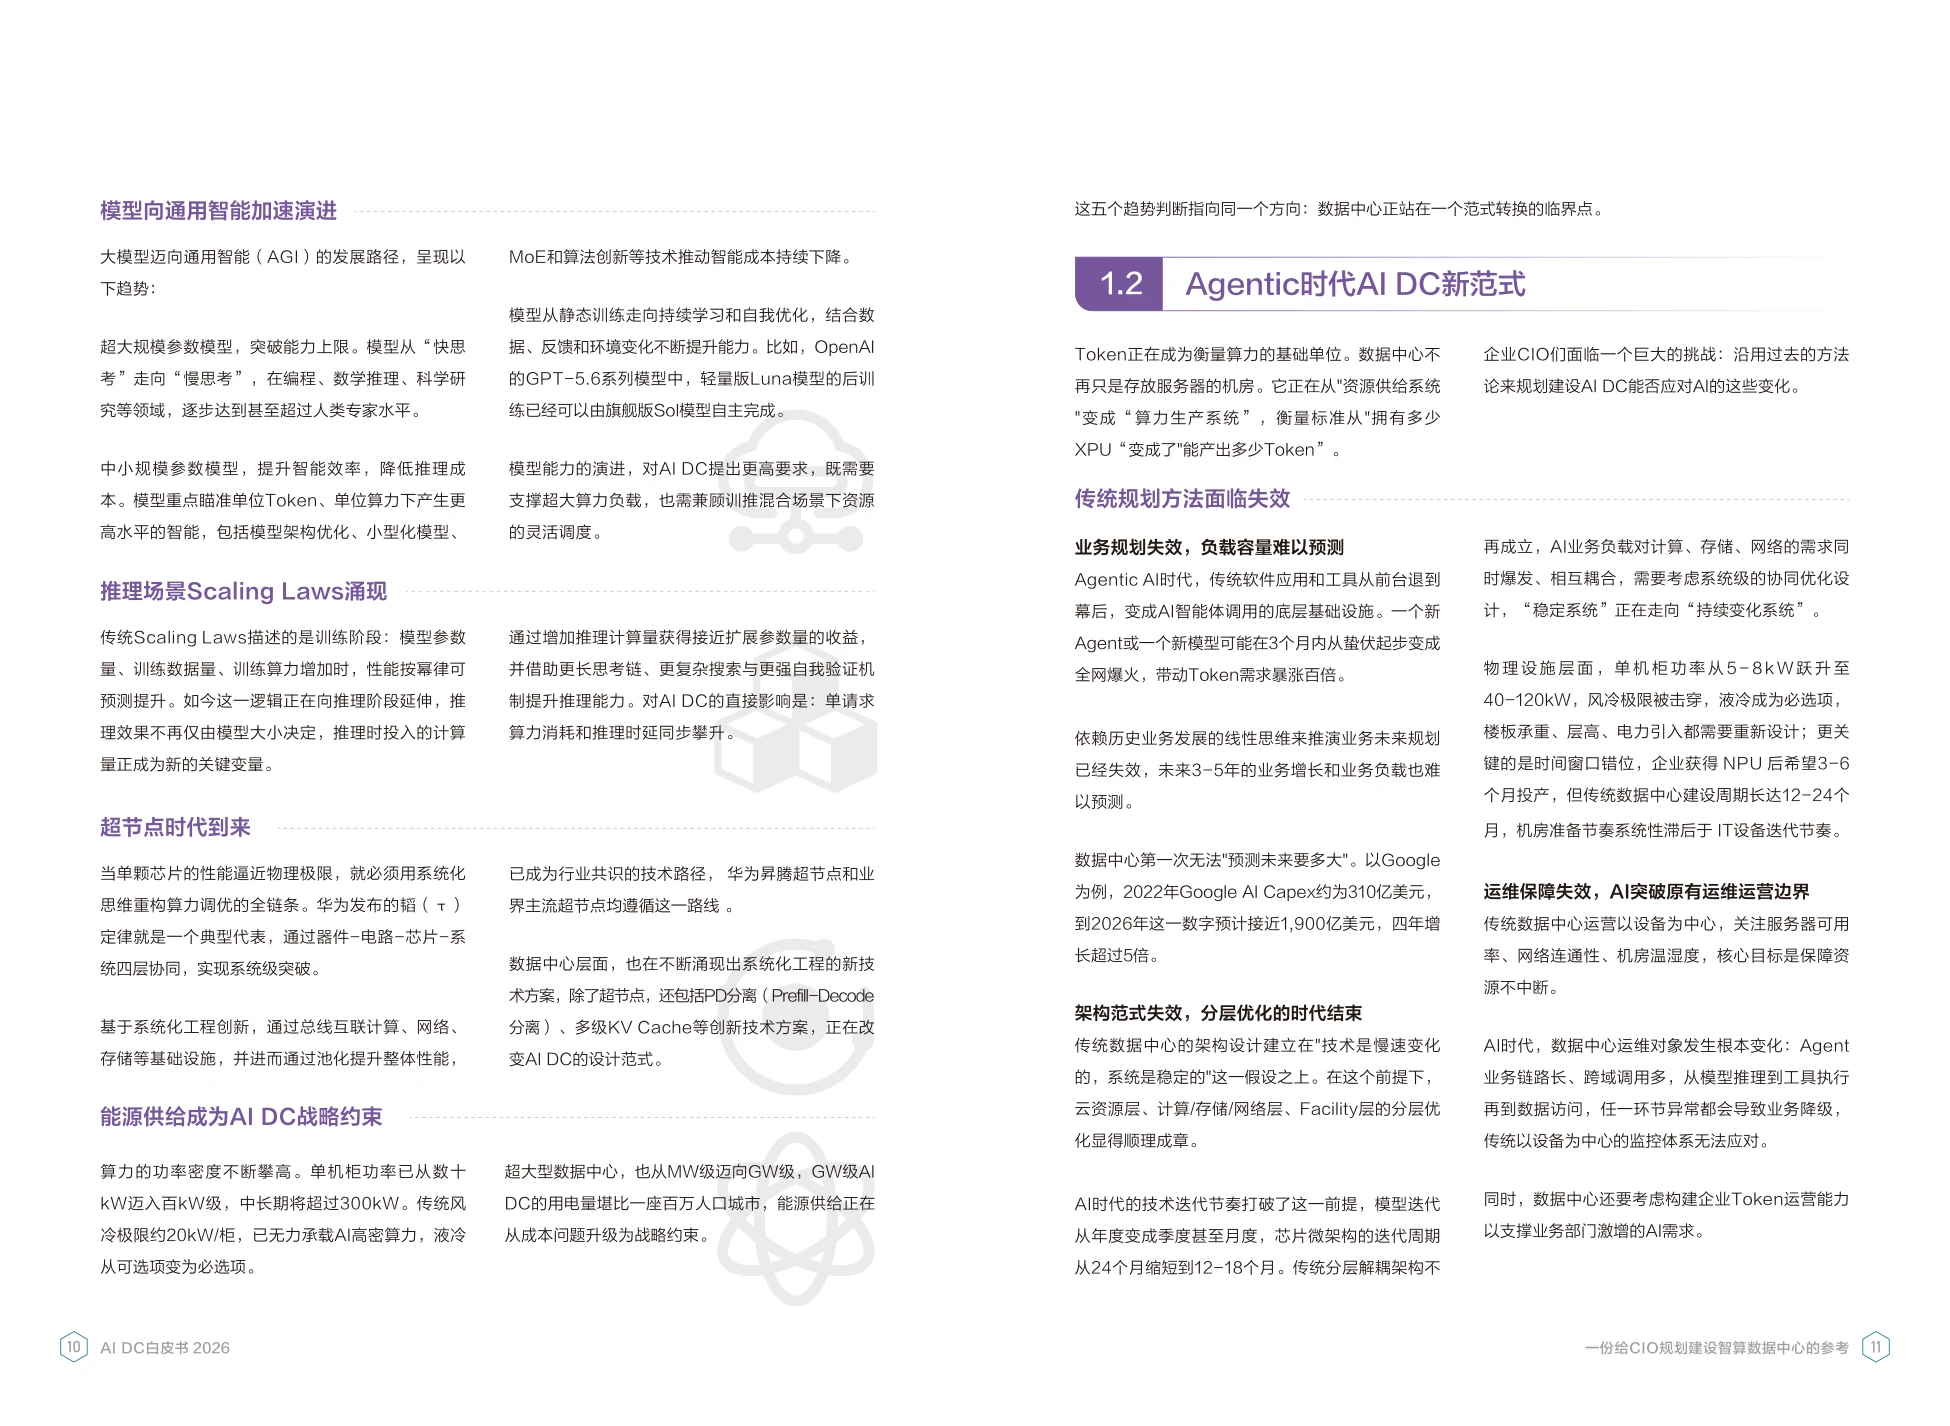
报告给出的新范式叫"3T+3P"。3T是纵向的价值链:AgenT应用驱动、Token算力运营、WatT物理支撑。这三者构成完整闭环。Agent驱动Token消耗,Token消耗决定算力需求,算力需求决定瓦特消耗。报告的原话是,缺任何一个T的考量,规划都不完整。
3P是横向的保障线:Production智能生产运营、Provisioning自治运维保障、Protection安全防线构筑。三者分工明确。生产运营以Token为计量单位驱动价值创造,运维保障以自治化手段保系统连续,安全控制以零信任和以AI防AI守住底线。
这个框架的价值在于把模糊的"AI就绪"拆成了可核算的项。每个T对应一类投入,每个P对应一类能力,CIO可以逐项打勾。
报告还提醒,AI也给安全带来新冲击:内部Agent自主规划执行带来越权和数据泄露风险,外部黑客用大模型驱动自动化攻击,让传统防御面临代差劣势。
图源:《AIDC白皮书》(第13页)
五、应用侧先立骨架:AKDM四个字母
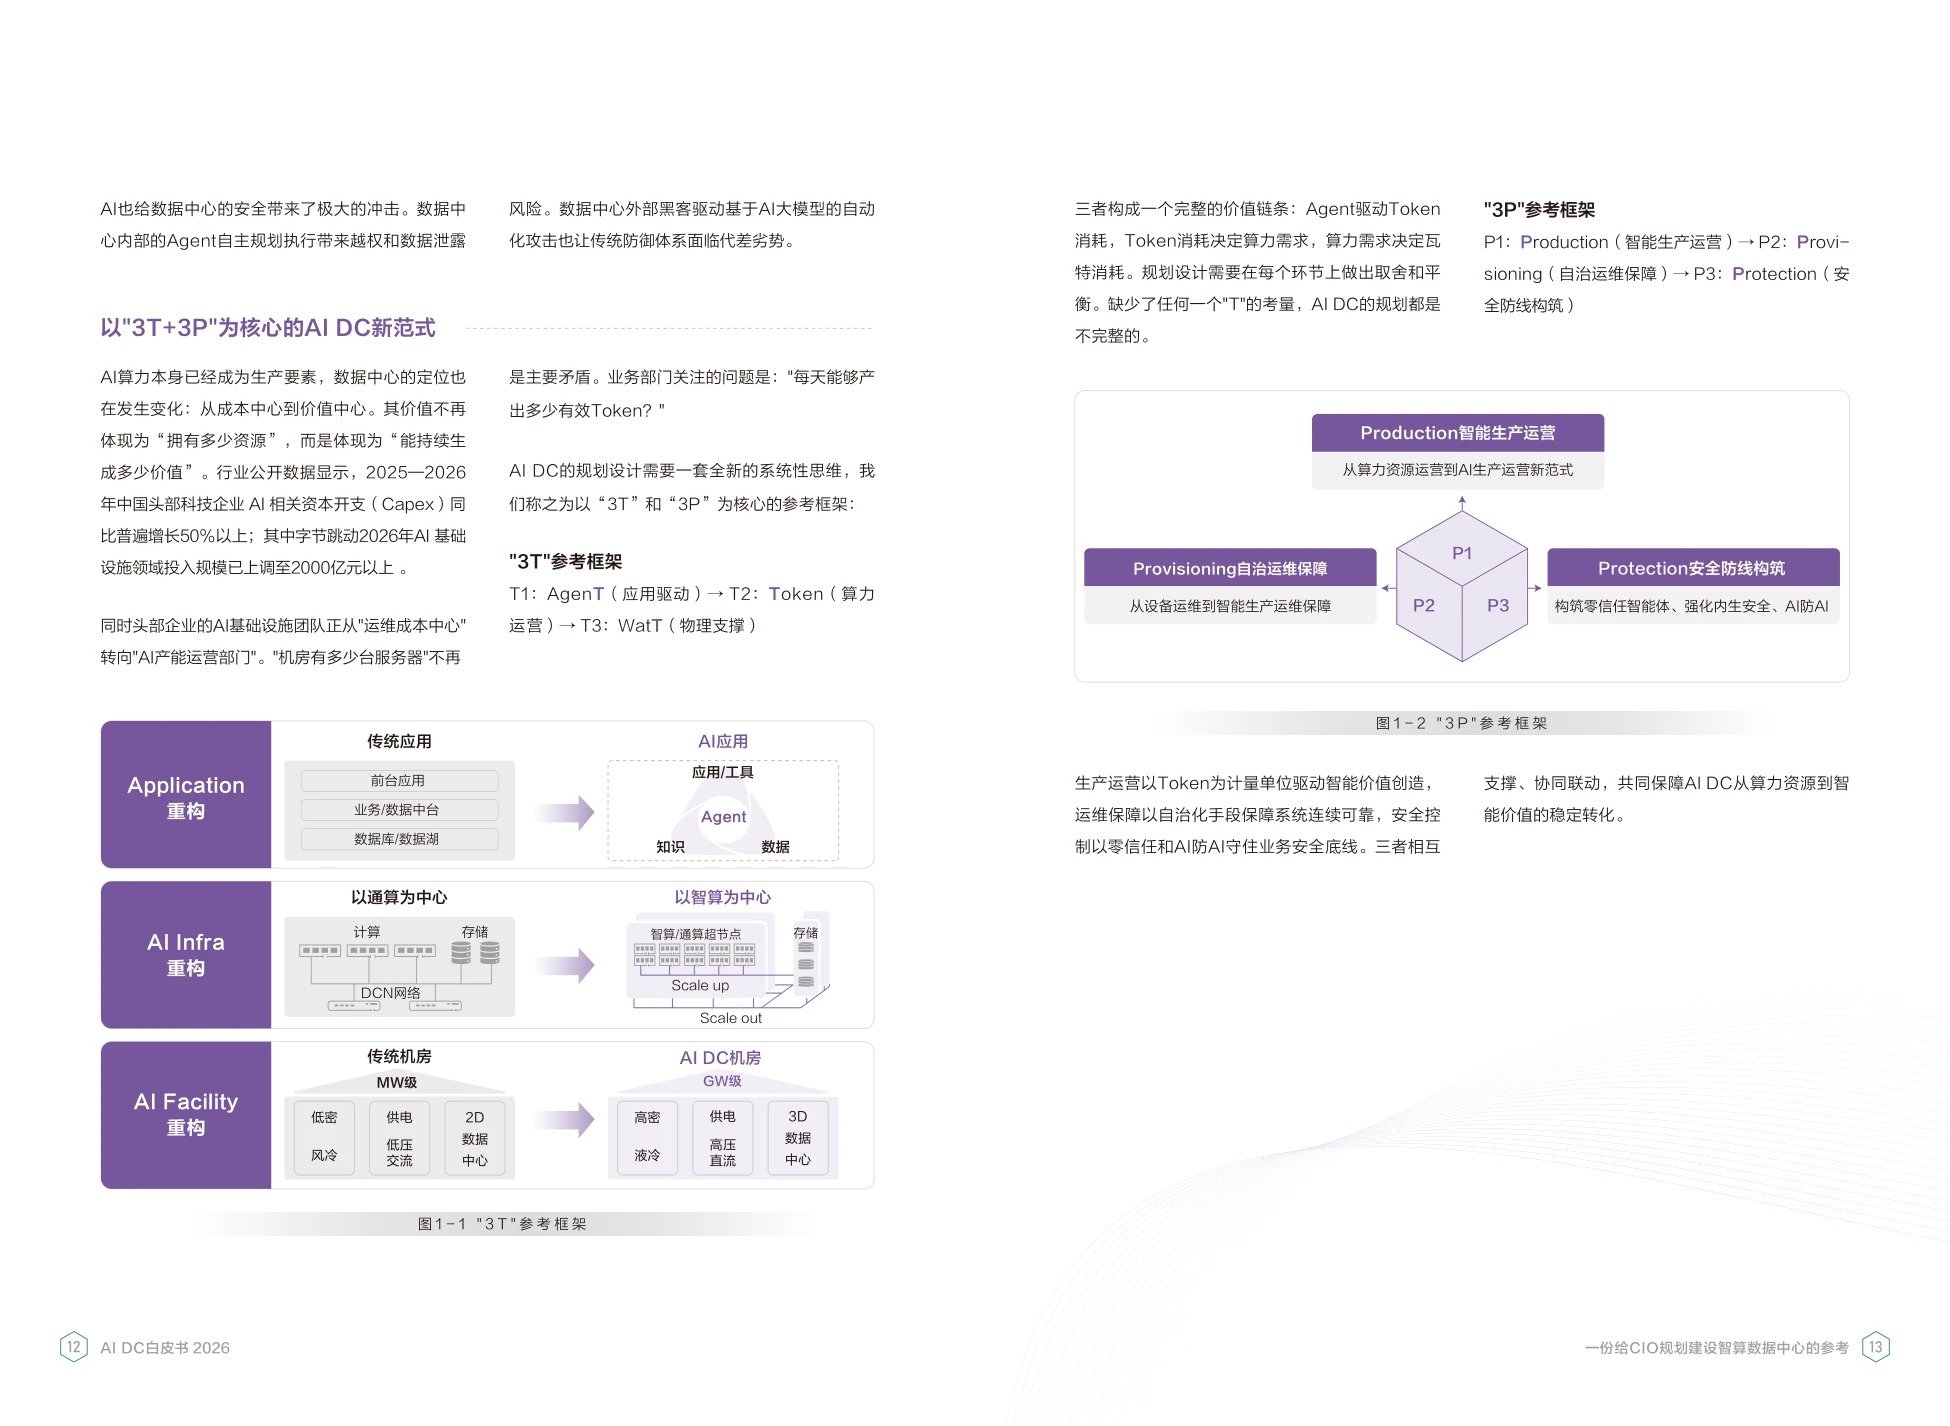
第二章从应用侧讲起。报告提出围绕AKDM框架建设企业AI应用与生态,四个字母分别对应Agent、Knowledge、Data、Model。Agent是执行中枢,把组织意图转化为任务和行动。Knowledge提供企业认知,把业务规则、流程经验和本体沉淀为可复用资产。
Data提供可信事实,让每一步执行基于准确、实时、可追溯的数据。Model提供推理引擎,支撑理解、生成、判断和规划。生产级多Agent系统的关键不在Agent数量,而在分工与协作协议。典型做法是设Lead Agent做任务调度,多个Sub-agent承担架构设计、代码开发、质量评估等专业任务。
报告要求明确协作契约:谁拆解任务、谁拥有执行权限、谁校验结果、谁对最终产出负责。各Sub-agent在限定职责、权限与工具边界内运行。
平台侧要三层:Agent Framework管编排与上下文,Agent Distributed Runtime管分布式可靠运行,Agent System Service管沙箱、隔离与工具调用边界。
图源:《AIDC白皮书》(第15页)
六、超节点:把上千张卡变成"一台计算机"
算力底座的核心载体是超节点。报告的判断很直接:模型从百亿、千亿参数走向万亿参数,传统单服务器架构已经逼近物理边界。
举例来说,1T参数模型即使按FP16精度也要约2TB内存,超过主流8卡AI服务器的片上内存容量。量化压缩能缓解,但留给KV Cache的空间不足,并发和长上下文都会被卡住。
超节点的定义是逻辑上的"一台计算机"。同一超节点域内AI芯片互联应不少于32颗,带宽大于每秒400GB,时延小于500纳秒,且统一内存编址。
效果能算出来。在DeepSeek、Qwen等MoE模型推理中,端到端性能获得3倍以上提升。DeepSeek的大EP方案是最具体的例子:EP卡数从16卡增加到288卡,单卡权重占用从42GB降到2.33GB,Batch Size从8增长到30。
省下来的显存变成了KV Cache的空间。这就是报告反复强调的逻辑:不是买更多卡,而是让已有的卡少等数据。
图源:《AIDC白皮书》(第31页)
七、KV Cache成了新的存储命题
报告把KV Cache列为影响推理成本的关键手段。原因是Agent任务"只增不改":后续请求复用大量已有上下文,只追加少量新内容。以AI Coding为例,任务持续数小时甚至数天,上下文达64K、128K甚至百万Token级,单任务产生的KV Cache可能达到数百GB甚至TB级。
这带来三个具体挑战。片上内存存不下;从NPU到SSD要经过DDR、PCIe多级中转,时延上不去;SSD频繁擦写,每日全盘擦写次数可达10次以上,寿命被快速消耗。
解法是层次化。报告给出L1到L4四级:片上内存存活跃KV,DDR存热KV,共享池存温KV,集群级AI存储存冷KV,时延从纳秒级排到毫秒级。介质侧也有改法。报告提到SSD向语义化存储单元演进,通过生命周期感知聚合与智能磨损均衡,把写入放大降低70%以上。
结果是每日全盘写入从10次以上降到3次以内,存储寿命延长2到3倍。这些数字对AI DC的TCO影响很直接。
图源:《AIDC白皮书》(第33页)
八、液冷与供电:硬指标已经写进设计规范
物理设施这部分,报告给的都是可验收的数字。新建液冷算力机房,楼板承载建议按20千牛每平方米及以上标准实施。
层高面向300千瓦以上超高功率机柜场景,综合测算机房层高建议不低于7.5米,或梁下净高不低于6.5米。搬运斜坡坡度不超过8度,宽度不小于2.2米。
供电侧主推800伏直流。报告把它定义为覆盖全链条的系统性工程,硬件涉及直流UPS、高压锂电、高压母线、连接器、断路器与服务器电源的协同适配。
散热采用风液同源架构:前端冷源与一次侧管网统一规划,末端按机柜功率选风冷、液冷或混合。机位同步预留液冷快接与风冷送风条件,同一机房可弹性部署不同代际设备。
存量改造有三条判定线:楼板承重不低于12千牛每平方米、机房净高不低于5.4米、电力冗余不低于现有IT峰值负载的1.5倍。三项全达标才具备改风液混合的基础。
工期压缩靠预制化。报告称以POD为基本建设单元、机电模块工厂预制后,能把传统土建12到18个月的建设周期压缩至6到8个月。
图源:《AIDC白皮书》(第43页)
九、运营从"看设备"变成"看产出"
第三章把运营单独拎出来讲,理由是价值不再在建成那天锁定,而是在运营中持续生成。报告提出AI生产运营(AIPO)的概念。
传统模式是IT保障型:需求、应用部署、资源分配、系统运维、服务保障。AI生产型变成:智能需求、模型编排、算力规划调度、推理服务、Token生产交付、质量评价、价值反馈、持续优化。
运维侧讲自治。报告提出Agentic自治运维六大能力,参考架构要把定界与恢复做成自动化。案例里银行的目标是智能定界与快速恢复。
这里有个容易被低估的指标:前沿编码Agent单次连续运行已达到25小时。传统"服务99.9%可用"已经无法覆盖长链任务的可靠性要求。
所以可靠性标准要从"服务不中断"升级为"任务必完成",需要持久化执行、状态检查点、断点续跑、跨节点迁移。安全侧强调"以AI防AI",同时给Agent运行环境提了硬要求:microVM级强隔离沙箱、网络与权限默认隔离、会话级安全控制、全流程行为审计。
报告原文都放在运营动脉(www.yydm.cn)上,图表、口径说明和样本量写得清清楚楚,可以对着核。
遇到拿不准的数据,建议回原文翻一眼,比被二手解读带着走要稳妥得多。
十、三个案例,三种建法
第四章给了三个实践样本,覆盖互联网、金融、医疗三类负载,思路差别不小。第一个是华为云芜湖3D数据中心。它的看点是把"3D"落到建筑与机电:供电、制冷、IT三层立体布置,用空间换密度。
第二个是中国建设银行的AI数据中心建设与运营转型。作为国有大行,建行已建成"四地五中心"高可用智算集群,重点在多中心容灾与运营体系。
第三个是复旦大学附属中山医院的AI DC医疗实践。医疗负载的特点是数据敏感、合规严格,落地重点在不出域与可审计。三个案例的共同点值得注意:都不是从买卡开始,而是先定业务目标,再倒推算力、网络、存储和机房条件。
对准备立项的企业,报告给的最实用一句话是弹性建设:长期锁定土地电力等稀缺资源,中期滚动收敛需求,短期用标准化POD敏捷扩容。
先算清每天要产出多少Token,再决定买多少卡、留多少电——顺序反了,钱一定花错。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。