医疗数据要素怎么用?79页案例集拆14个落地样本
 广告
本文解读:《中国健康医疗数据要素应用案例集》 · 共 79 页 · 原文
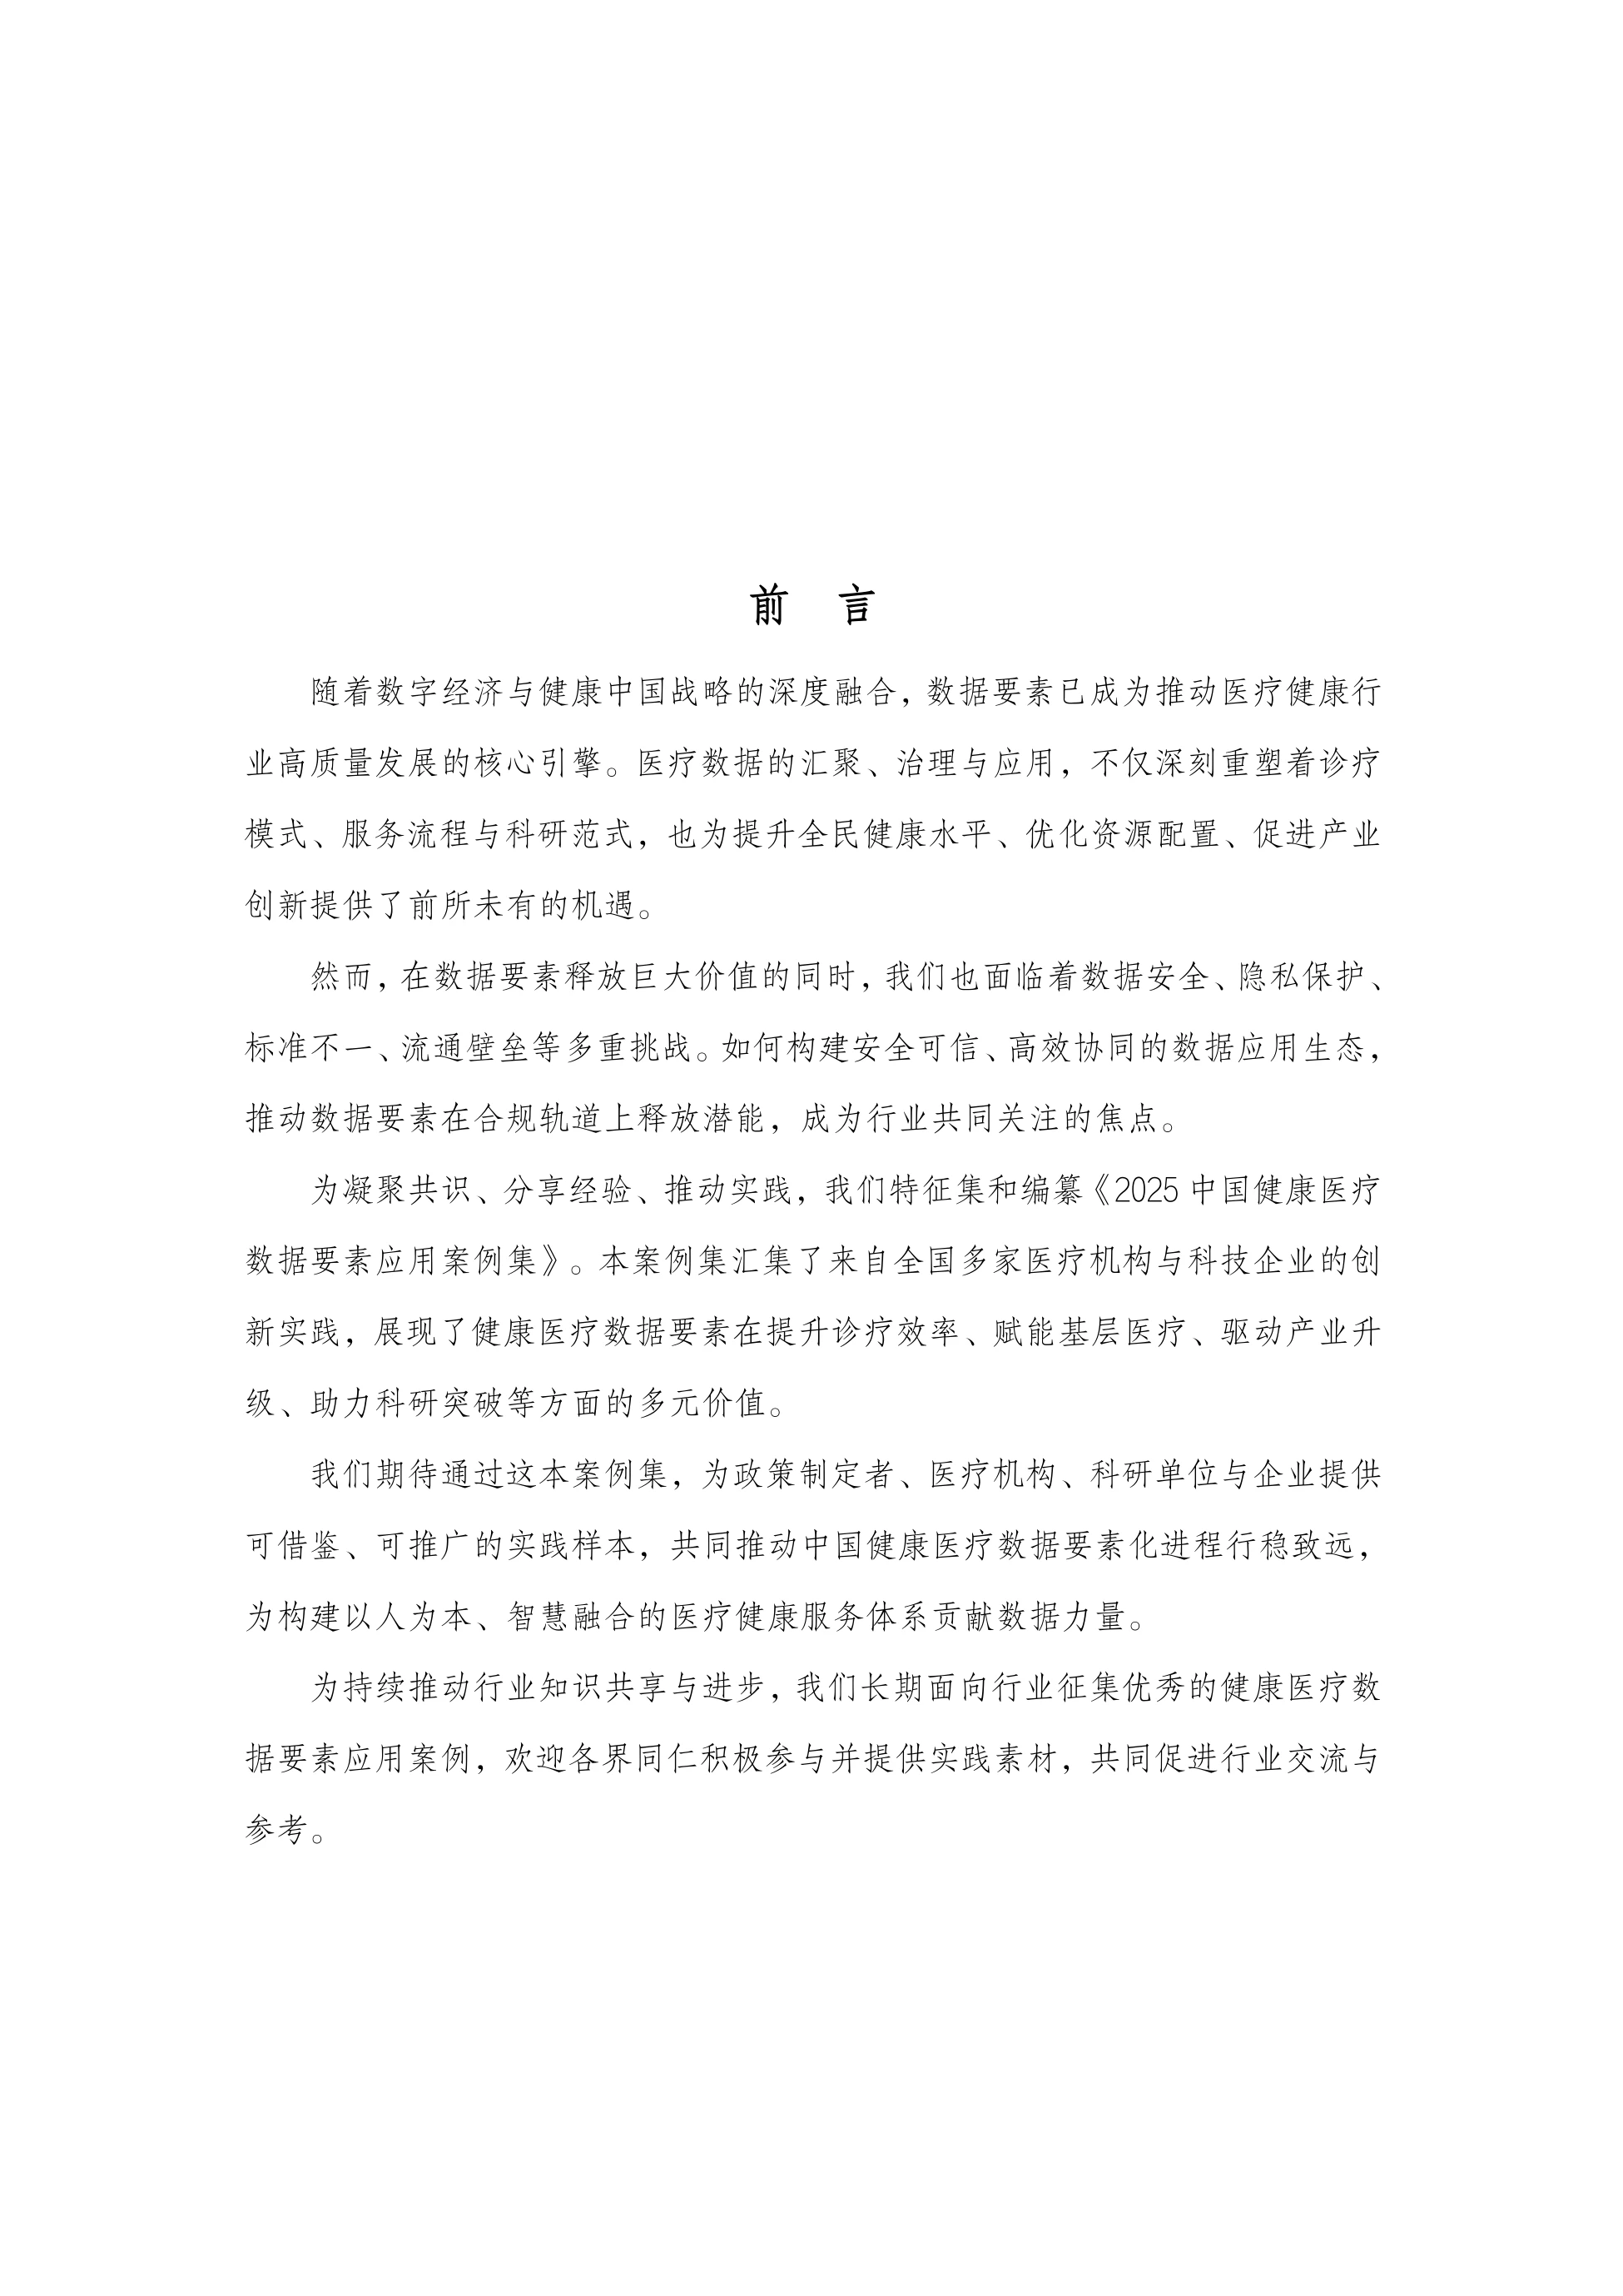
这本案例集里最值得记住的一句话是:医疗数据的价值不在存了多少,而在能不能算出一个更短的时间。《2025中国健康医疗数据要素应用案例集》共79页,收录14个案例,其中10个出自广东的医院和企业。
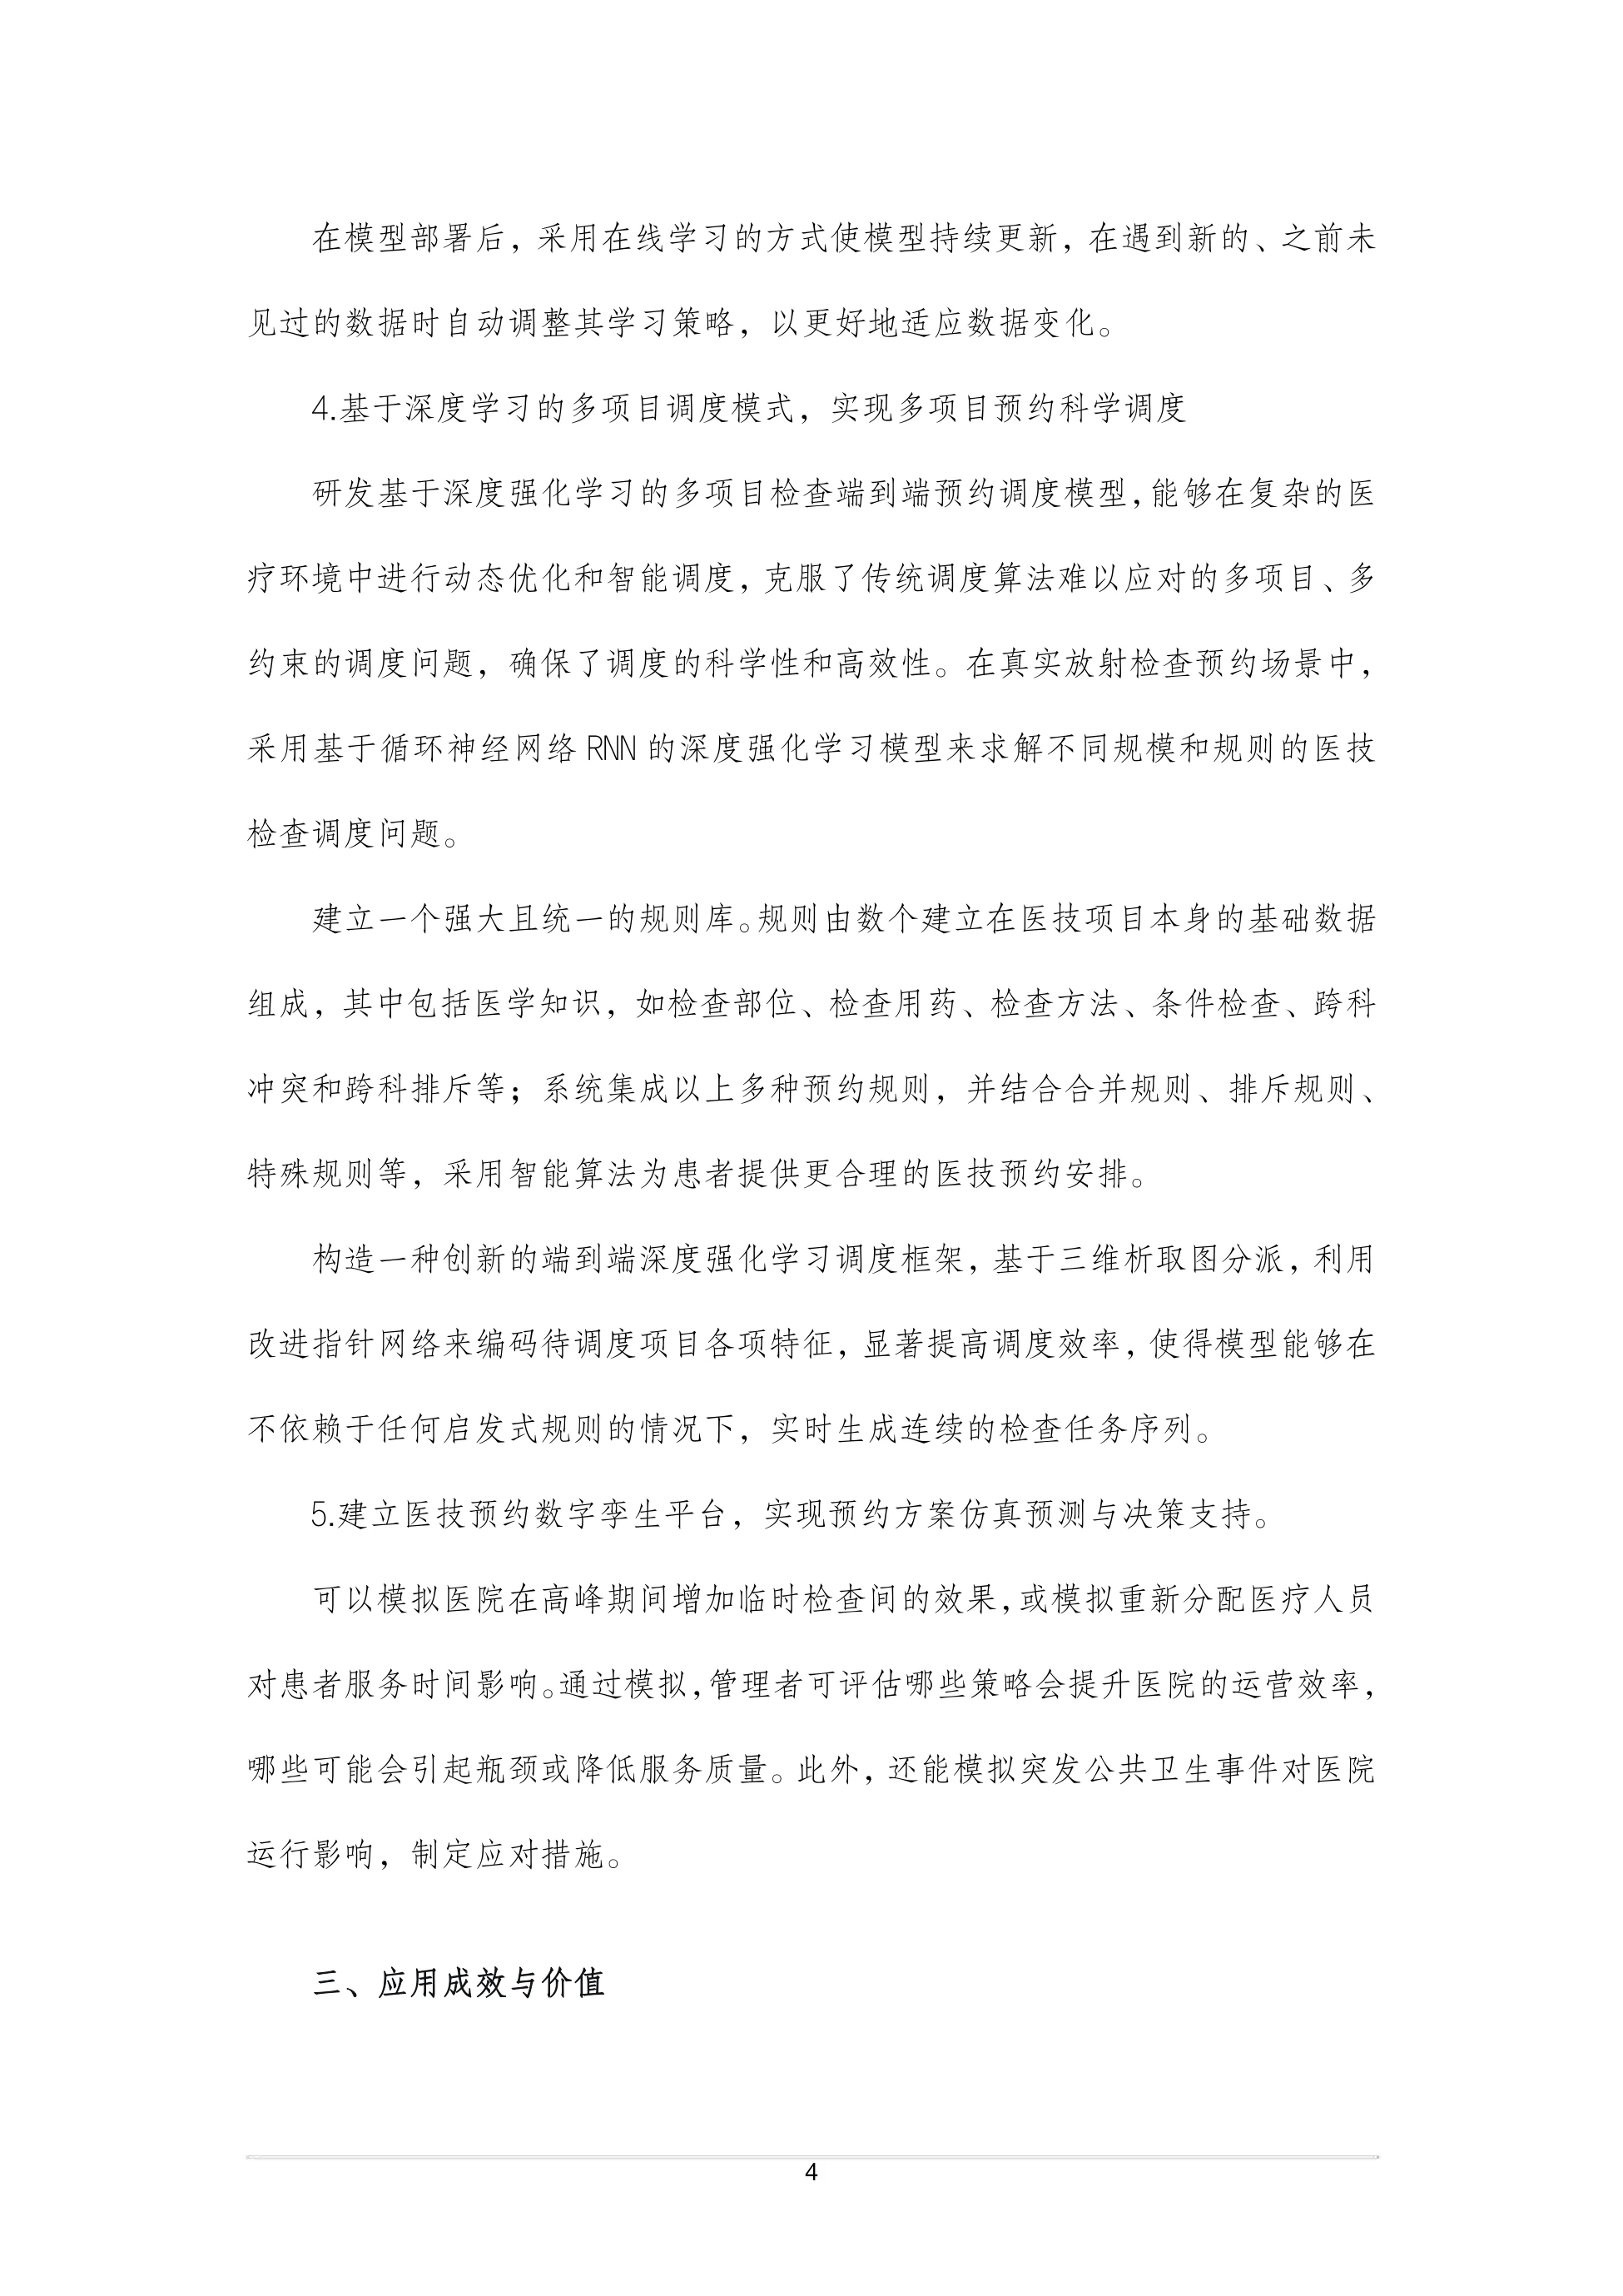
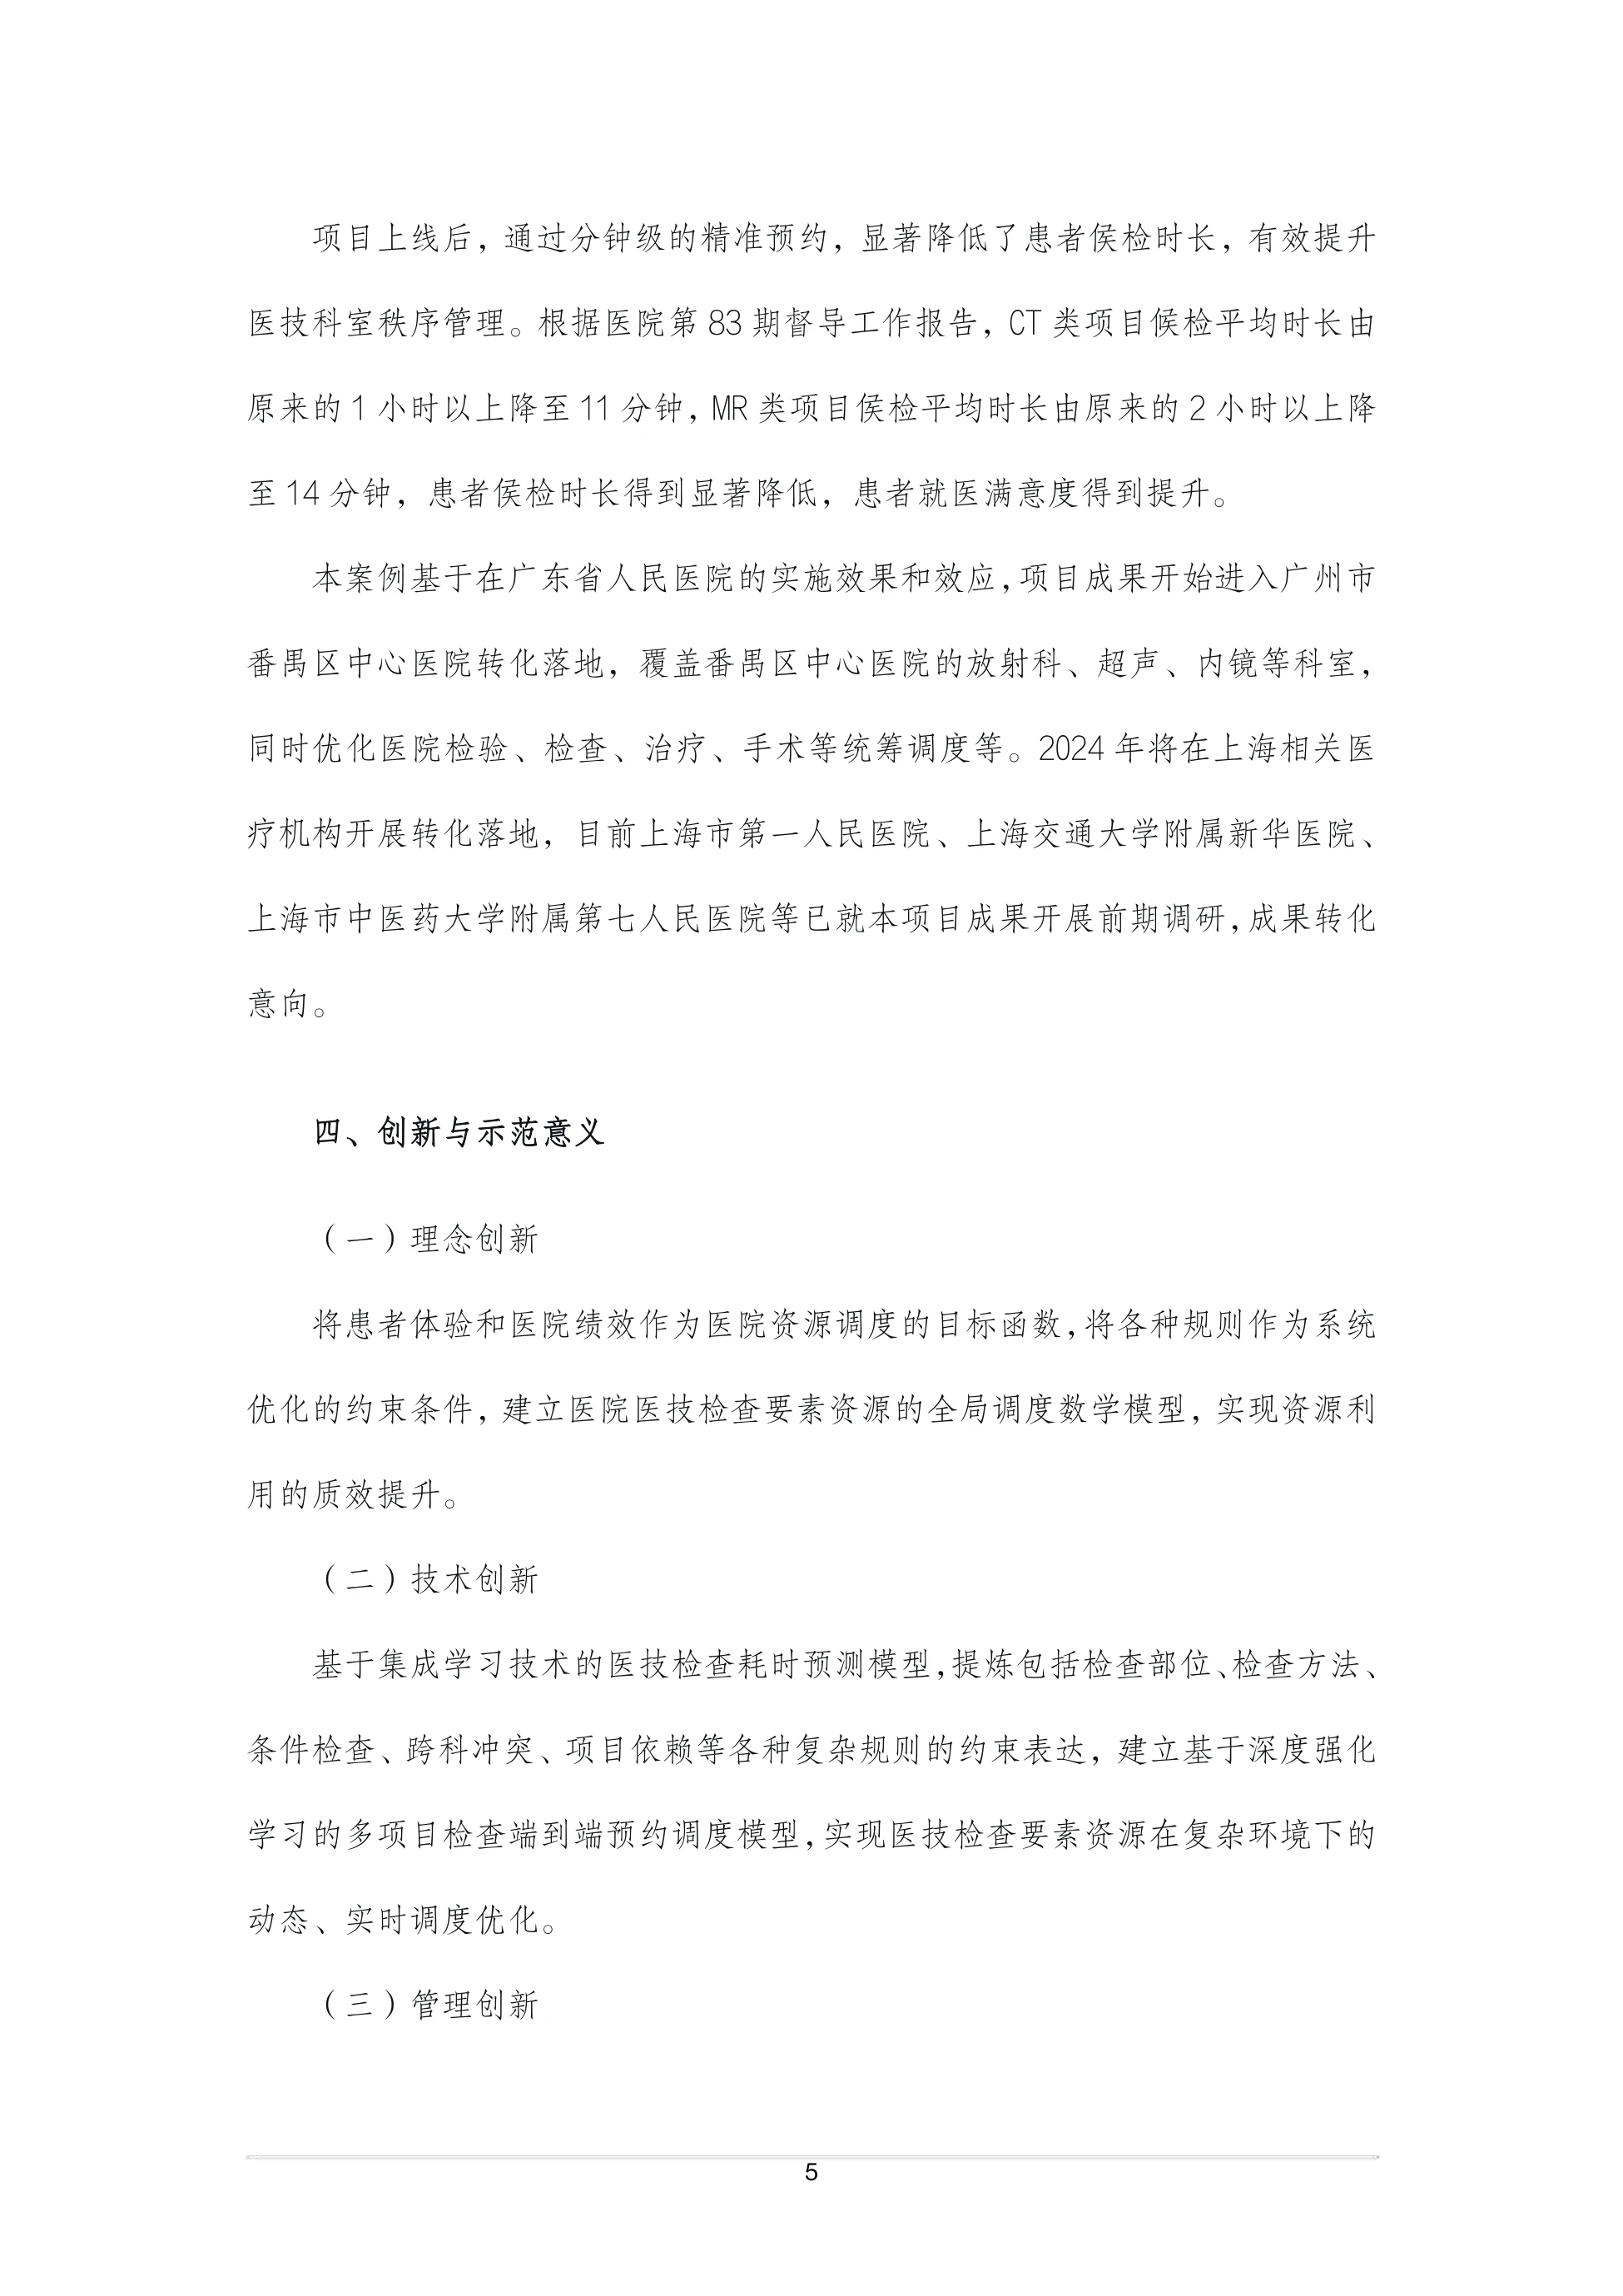
最直观的一组数字来自广东省人民医院:CT类项目候检平均时长从1小时以上降到11分钟,MR从2小时以上降到14分钟。
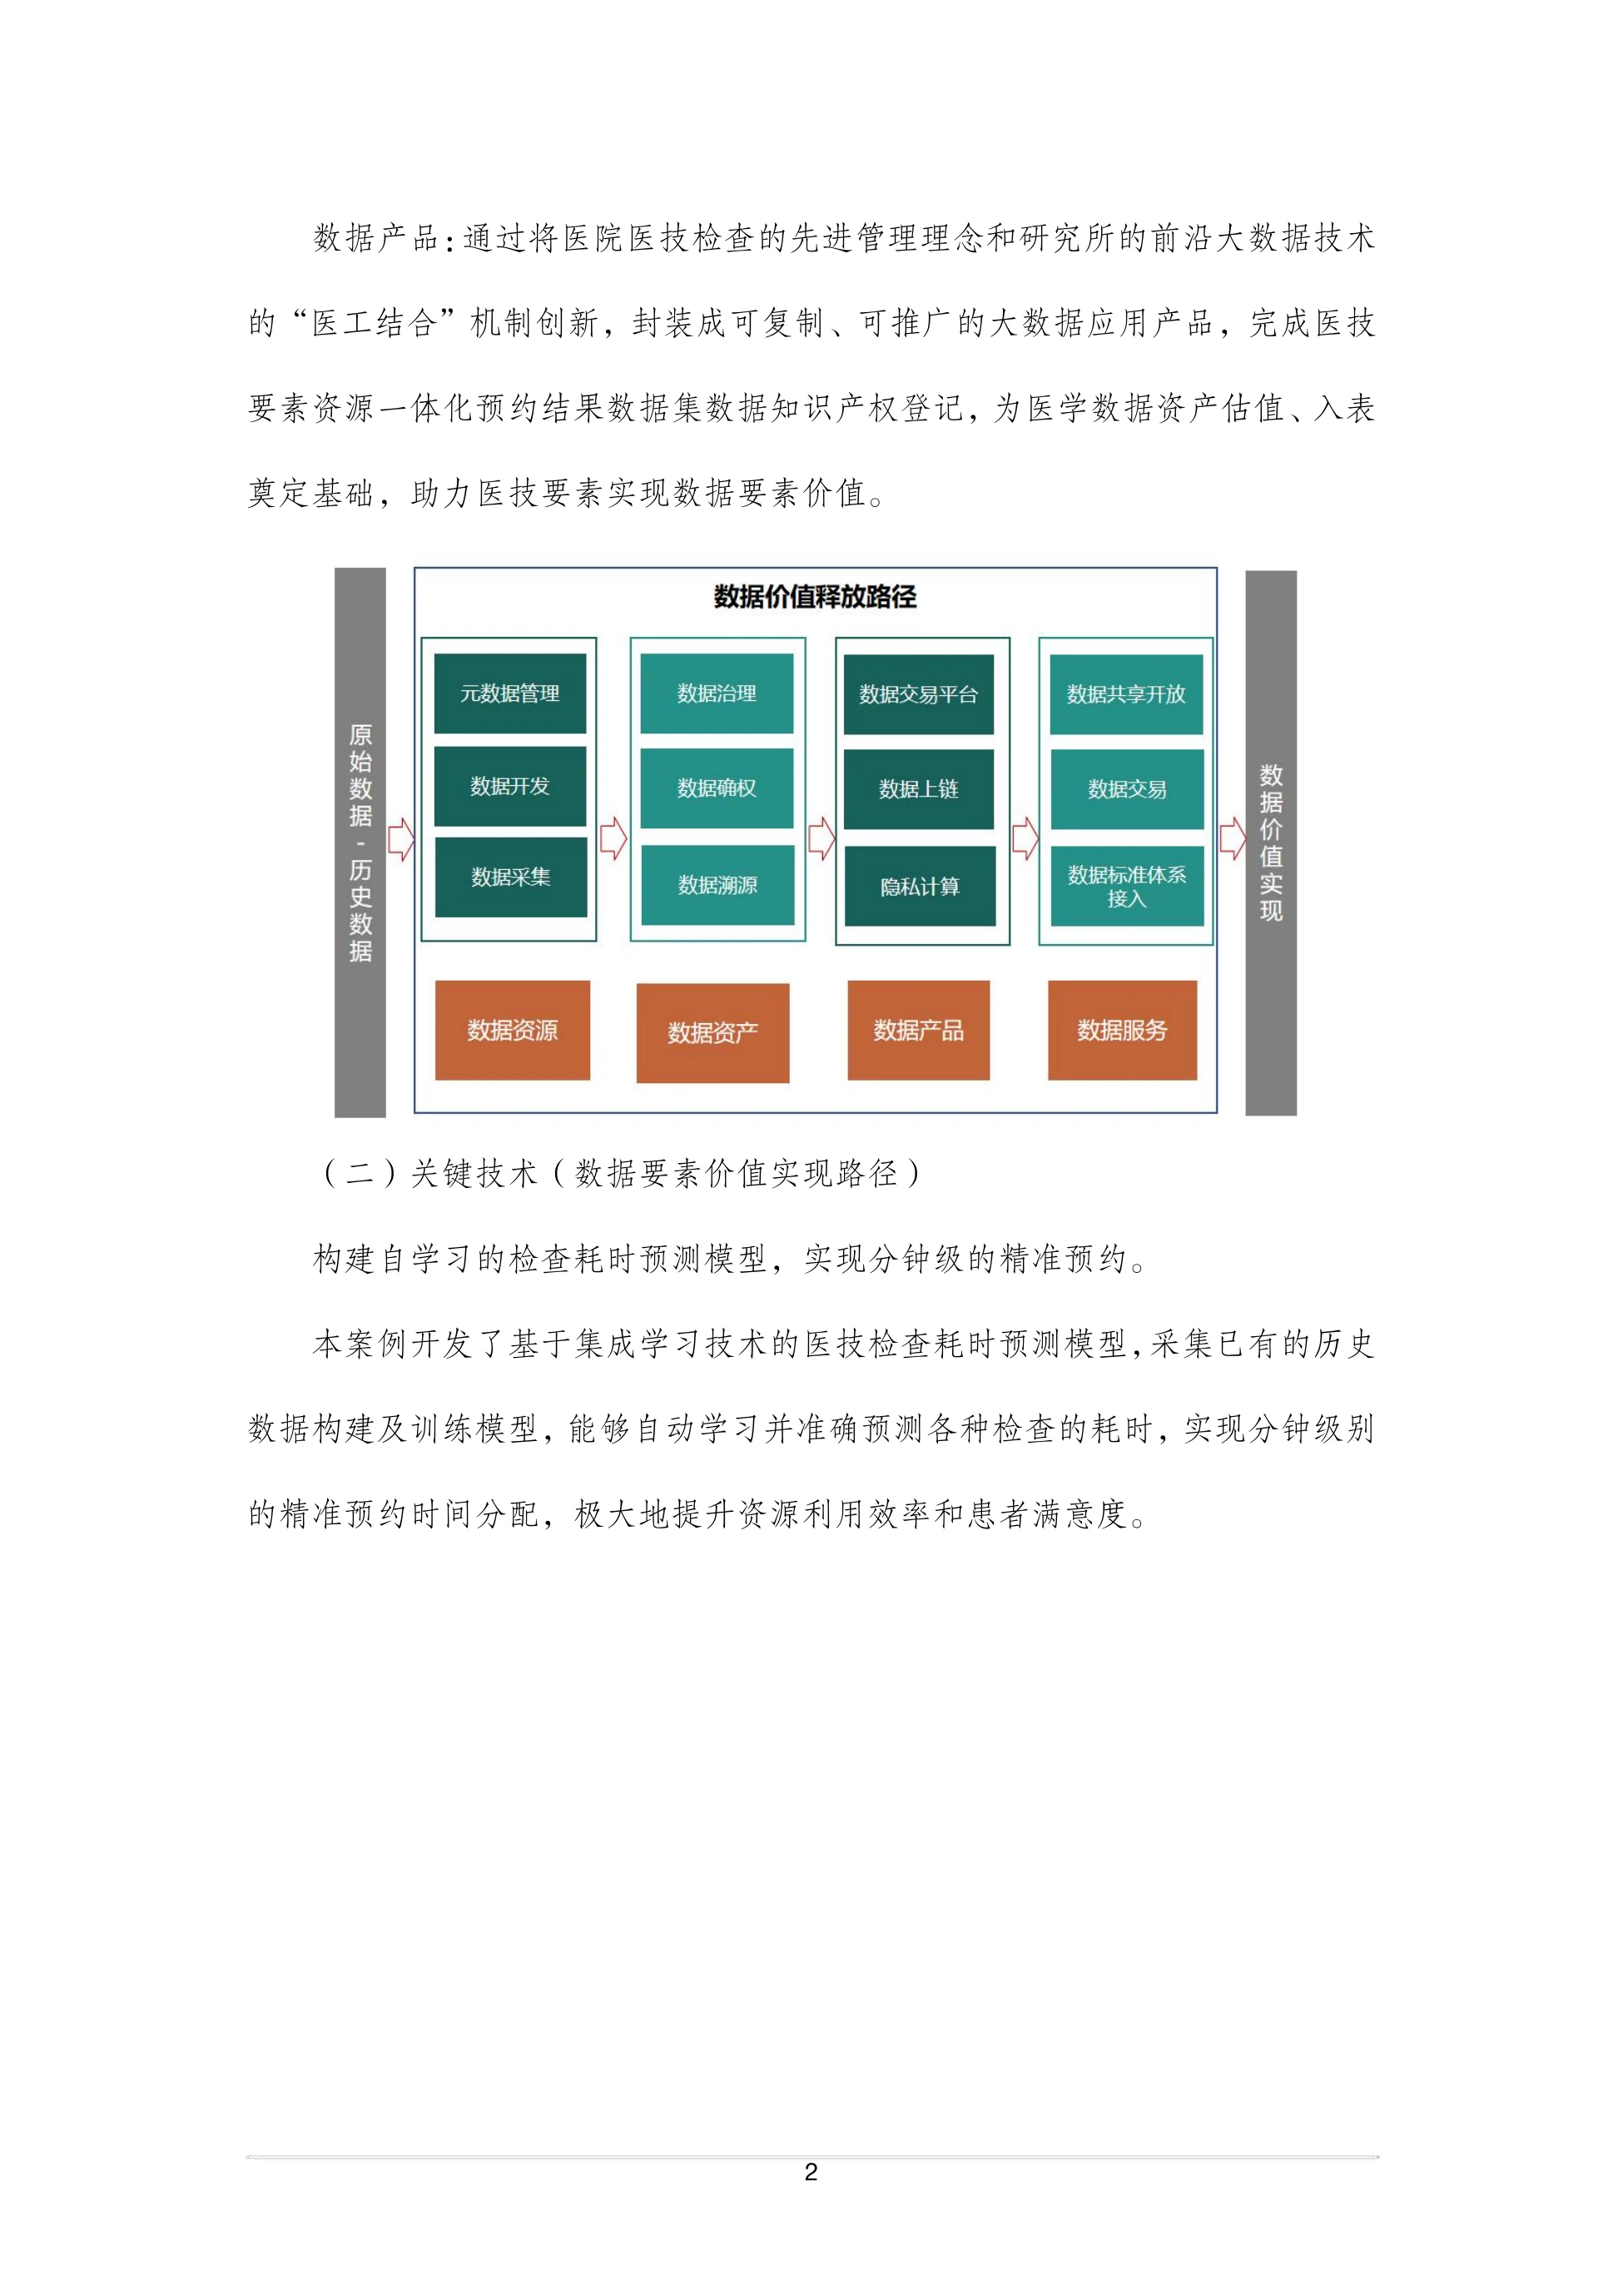
报告反复用三个词描述这件事的路径:数据资源、数据资产、数据产品。先汇聚成标准数据,再做成能估值入表的资产,最后封装成可交易的产品。
数据要素这四个字听着抽象,落到医院里就是一句话:同一个病人,少等一小时。
图源:《中国健康医疗数据要素应用案例集》(第1页)
一、14个案例里,10个来自广东
目录里的14个案例排下来,机构分布很集中:广东省人民医院4个,南方医科大学珠江医院3个,南方医院、广州妇儿中心、中山小榄人民医院各1个。
剩下4个来自企业:杭州迪安医学检验中心、创业慧康、北京优理数智、京卫智云。这意味着案例集更像一次区域实践的汇总,不是全国抽样。读它的时候,别把广东经验直接当成全国平均水平。
每个案例的结构都一样:案例背景、数据应用场景与方法、应用成效与价值、创新与示范意义。四段式,读起来快。选的病种也有讲究:眼科、新生儿、心电、脑血管、阿尔茨海默病,都是影像和时序数据密集、医生判断差异大的领域。
图源:《中国健康医疗数据要素应用案例集》(第3页)
二、医技预约:把候检时间压到分钟级
传统医技预约按号源数量扣减,先来先得。检查项目耗时不均,结果就是走廊里排队,设备空转与患者久等同时发生。
广东省人民医院的做法是先预测耗时。团队用一年放射科33万条历史记录训练模型,输入年龄、性别、检查类型和预约时间。
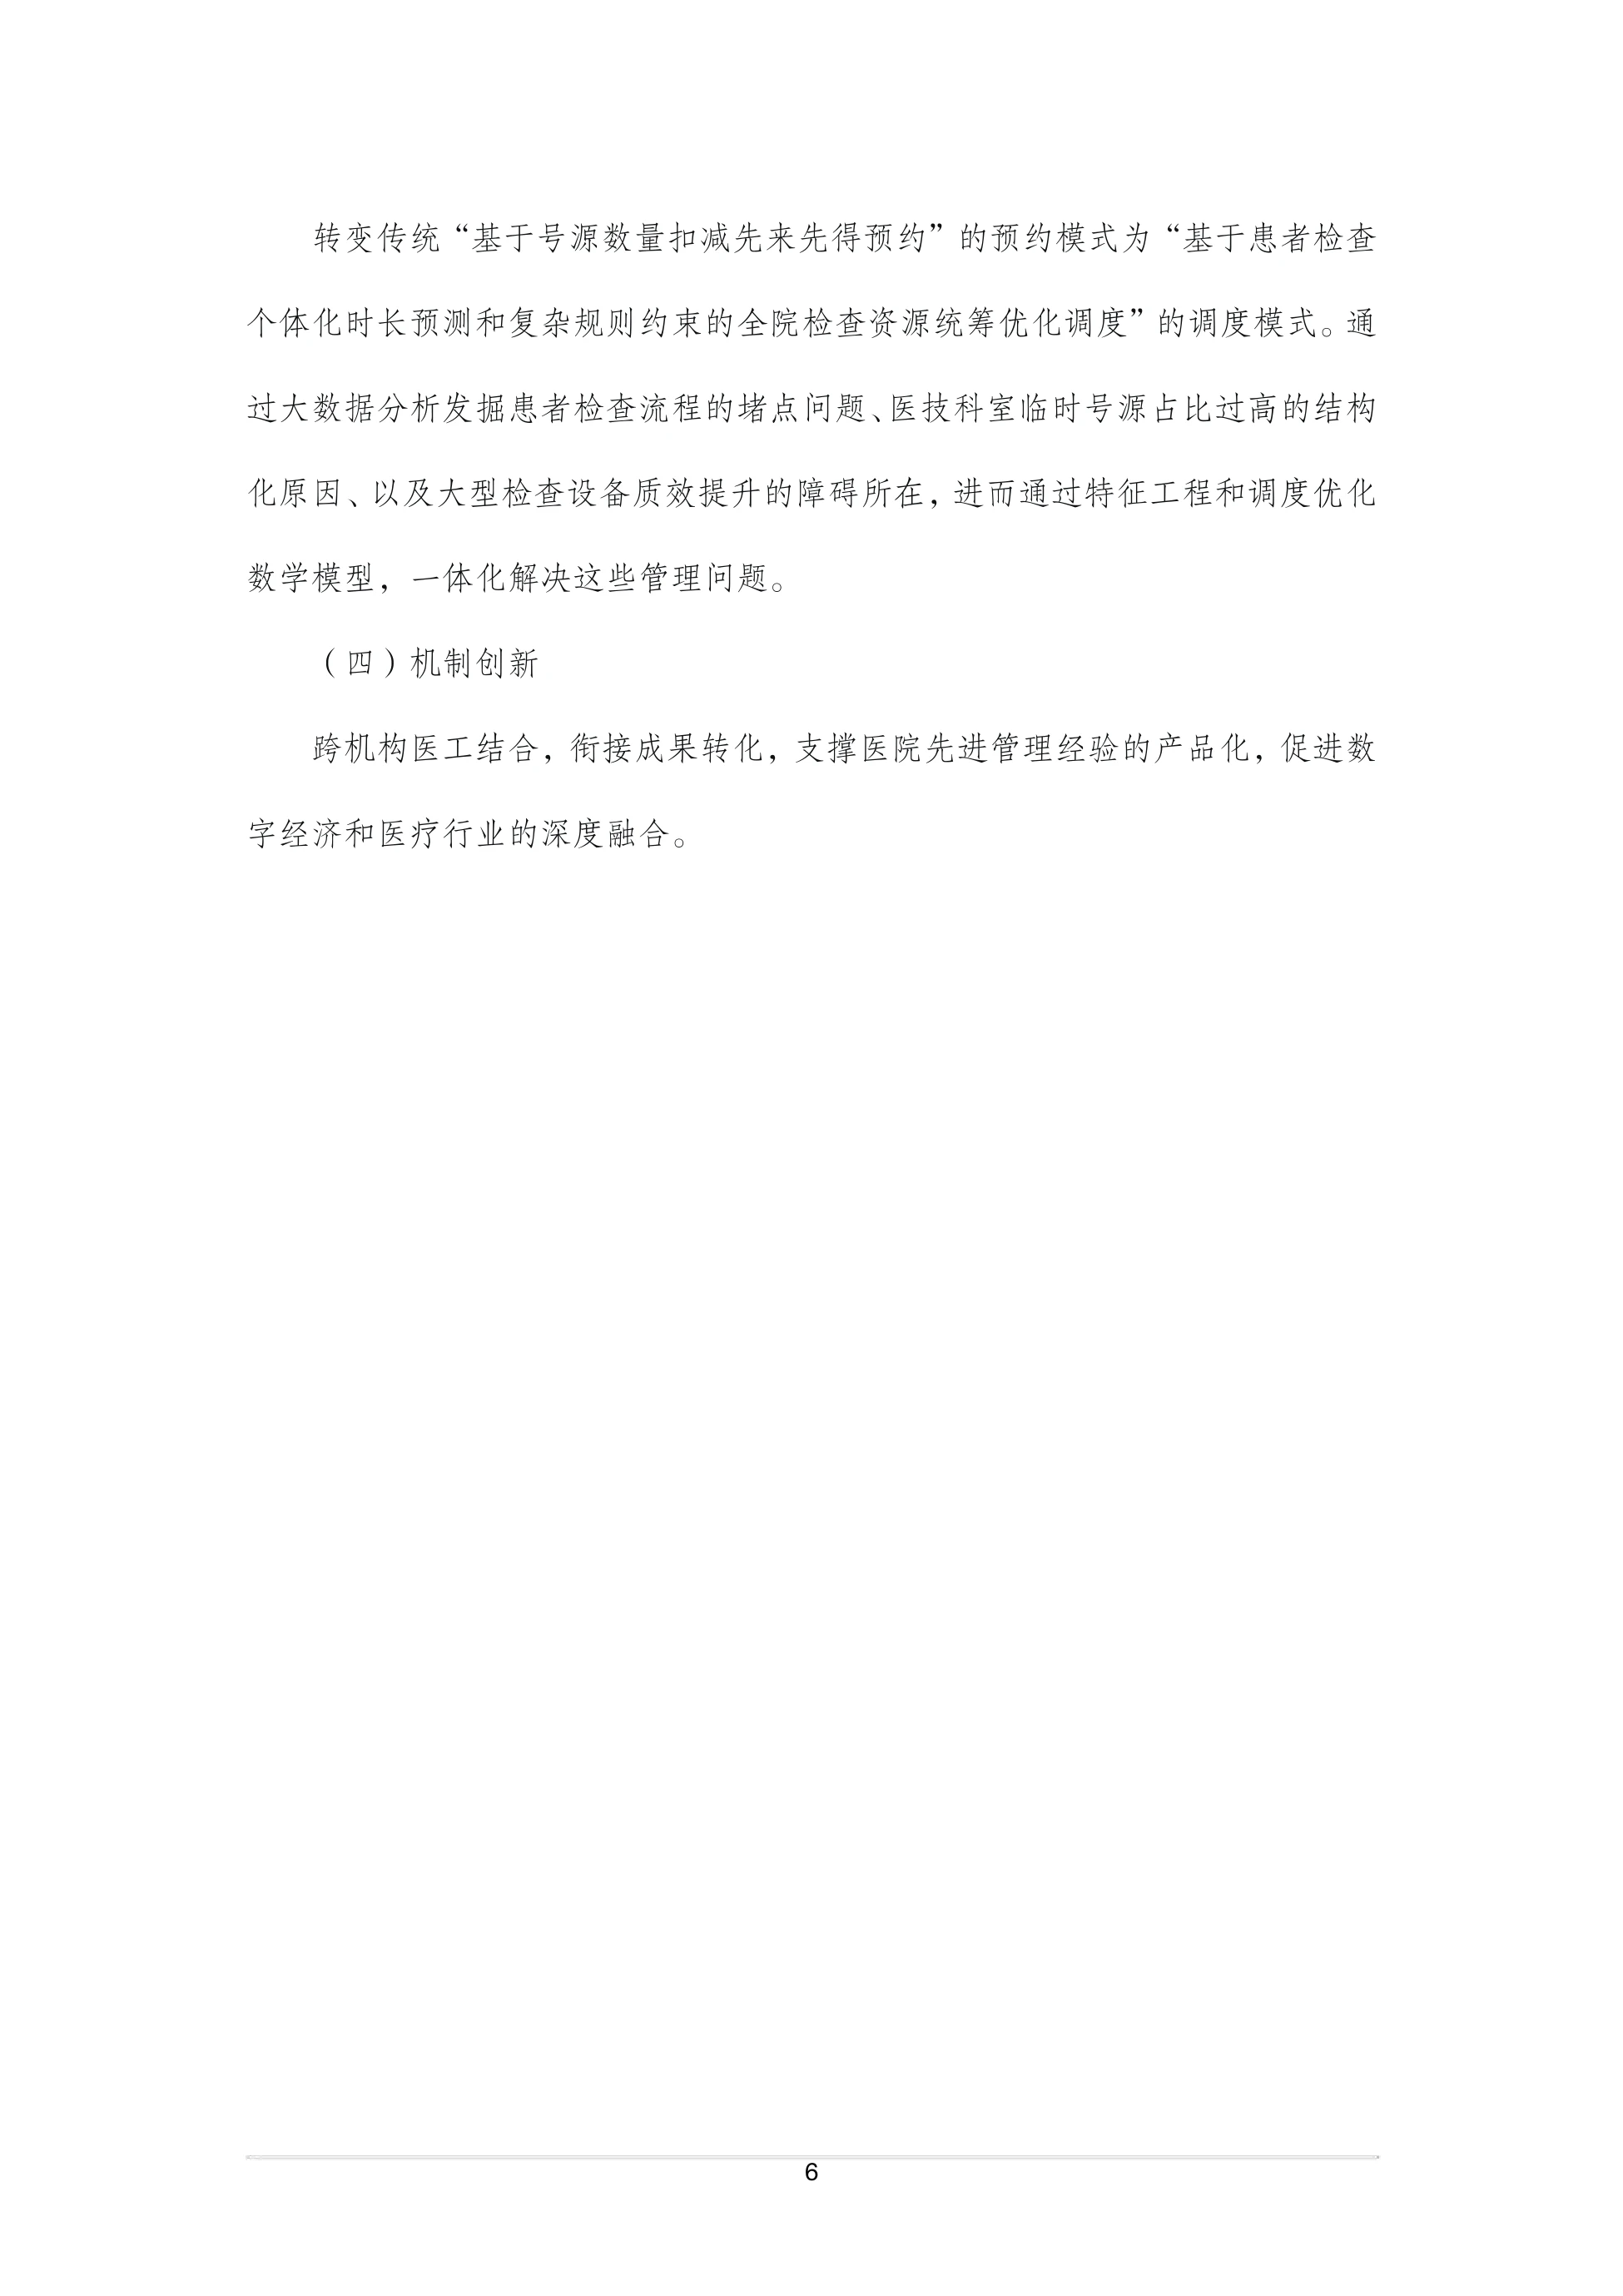
模型用LightGBM和XGBoost两棵树模型,再加LSTM处理时序。三者在Stacking框架下集成,单模型容易偏,集成之后更稳。更难的是多项目调度。报告用了深度强化学习,把检查部位、用药、跨科冲突这些规则都放进约束里,端到端生成任务序列。
从“先来先得”改成“按预测耗时排班”,本质是把排队权从号源手里交还给数据。
成果已经迁到广州番禺区中心医院,覆盖放射、超声、内镜;上海几家医院也在做前期调研。
图源:《中国健康医疗数据要素应用案例集》(第4页)
三、一张眼底照片,撑起95%的诊断准确率
早产儿视网膜病变是我国儿童首位致盲性眼病。报告给了一个判断:早筛早治能降低九成以上的致盲率。现实是筛查覆盖率低、专业医生少。基层医院拍出来的照片质量参差,AI又常常只给结论、不给依据。
广东省人民医院攒了10万余张新生儿眼底彩照和60万条文本,覆盖首次筛查到矫正胎龄45周。这是训练的地基。系统先把多方位照片拼成超广角全景,再分割量化亮度、颜色、纹理、血管形态,最后输出可解释的图文报告。
性能数字很硬:诊断的曲线下面积为95%,45周内发病风险预测为94%,严重程度预测为88%。这套系统已经推广到26家医院,服务超过5万人次,基层筛查效率提升3倍,并完成3000万元成果转化。
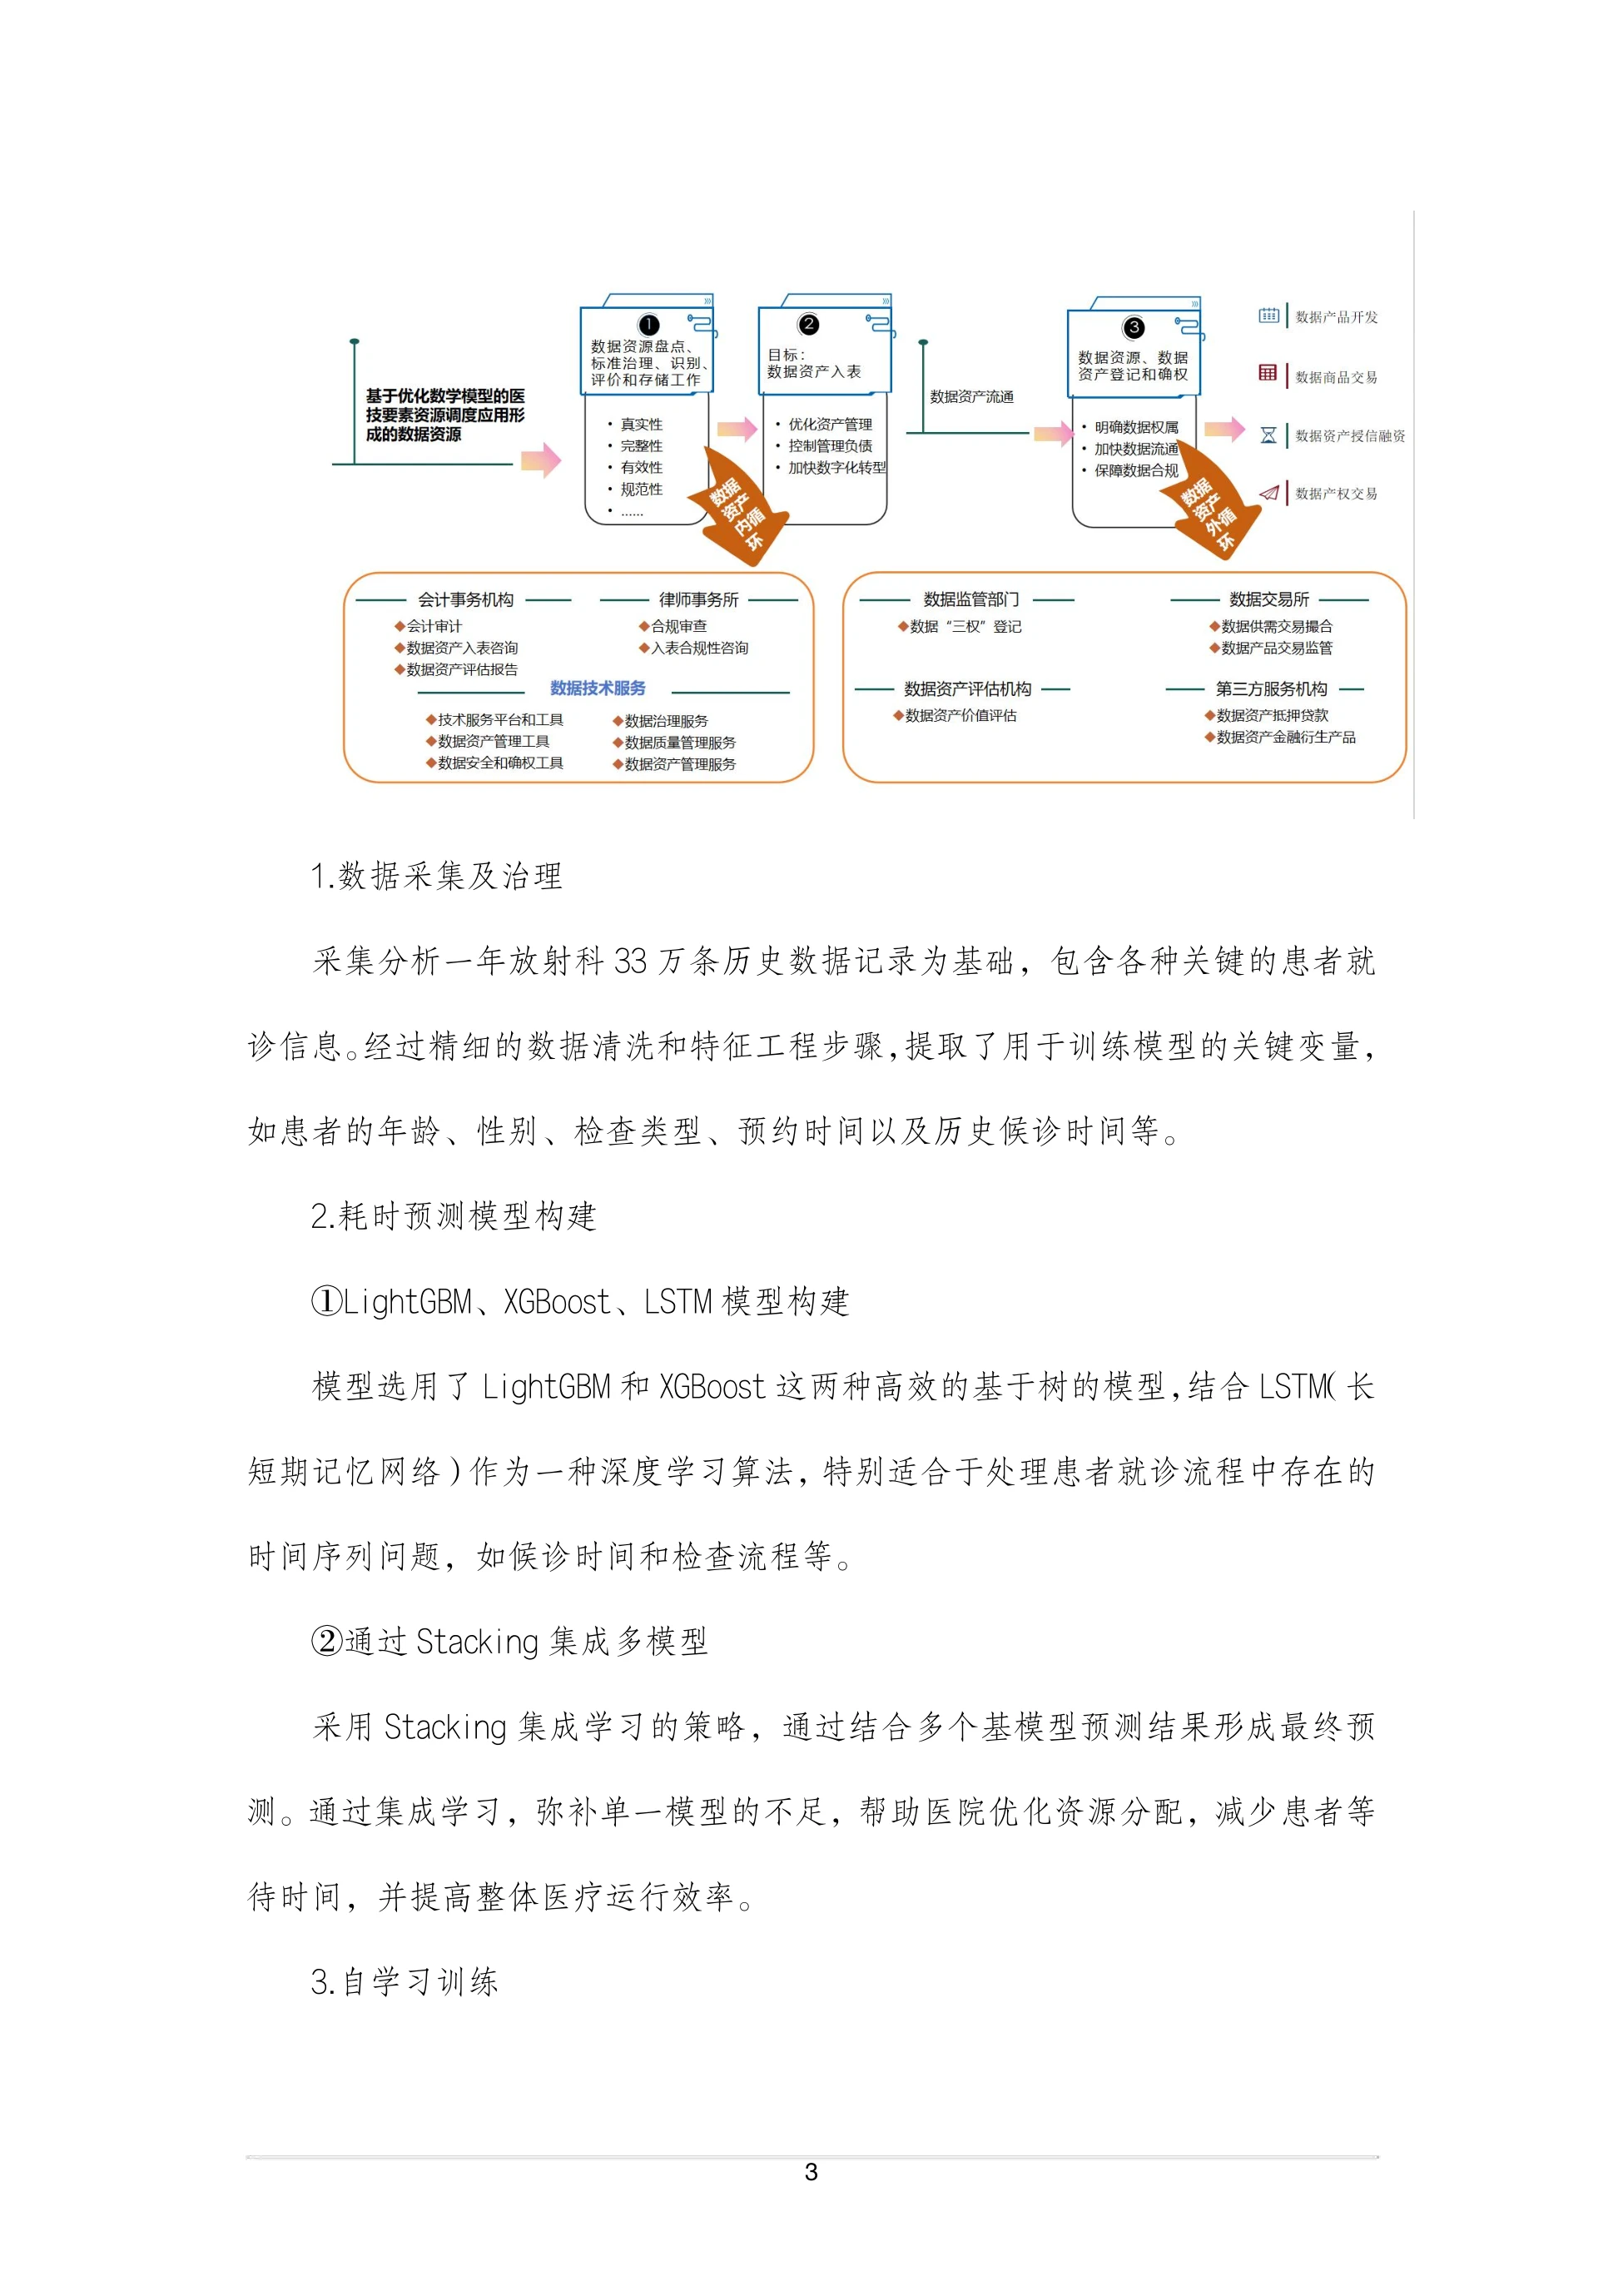
图源:《中国健康医疗数据要素应用案例集》(第5页)
四、新生儿黄疸:把随访率从7%拉到11%
黄疸的难点不在院内,在出院之后。家长在家看不出胆红素高低,复测不及时,重症就会被耽误。广州妇儿中心的平台把家庭、社区、医院串成一条链:家长在小程序上报经皮胆红素,社区复测,高危直转三级。
判读不靠经验。平台用指南阈值、规则引擎和机器学习三层,把日龄与胆红素曲线分成三色等级,再推随访计划。落地范围是广州11个行政区、711家机构,注册医生1920名,累计服务儿童78726人,2023年还推广到中山。
效果有两个指标:随访平台使用率从2020年的7.05%升到2022年的11.59%;高胆红素发生率从19.91%降到10.78%,严重者从0.57%降到0.30%。更值得注意的是机制:政府主导、多部门共建,把妇幼网络变成了一张能持续监测的网。
图源:《中国健康医疗数据要素应用案例集》(第6页)
五、血清质量:人工看10分钟,模型看几秒
溶血、黄疸、脂血这三类干扰,长期靠检验技师肉眼判断。耗时、主观,还容易漏。南方医院用16427张离心血液图像训练模型,网络选的是Inception-ResNet-V2,训练完再做五折交叉验证。
模型同时干两件事:分类判断合格、不合格、图像干扰,回归预测溶血、黄疸、脂血三项指数。准确率从传统图像分割算法的30.19%提到95.85%,识别合格、不合格、干扰三类样本的AUC分别为0.987、0.983、0.999。
单份样本的判读从约10分钟缩到几秒。这句话在急诊场景里的分量,比任何算法指标都重。
这个案例还走了一步别人少走的:模型在广州数据交易所完成产权登记,成了可交易的数据产品。
图源:《中国健康医疗数据要素应用案例集》(第7页)
六、心电数据集:50万例怎么变成资产
心血管病是我国居民死因首位,心电图是基层初筛的核心工具。难点是诊断靠经验,标准化数据缺。广东省人民医院整合近6年50万例历史心电记录,月均再纳入约7000例,波形与电子病历深度关联。
运营机制是72小时闭环:新增数据三天内完成清洗与标注,临床误判案例自动触发复核和模型迭代。开放分三级:脱敏波形给签约科研机构,含非敏感临床信息的需伦理授权,完整病历只给重大项目。
2024年完成广东省数据资产登记。按数交所评估模型测算,这批数据潜在估值3000万至5000万元。
报告也给了应用侧的预期:基层诊断时间缩短三成到五成,误诊率降15个百分点以上。
图源:《中国健康医疗数据要素应用案例集》(第8页)
七、围术期数据:25亿条是怎么攒出来的
手术室里最贵的不是设备,是数据流。麻醉机、呼吸机、监护仪每秒都在吐数据,但多数医院采不下来。广东省人民医院的做法是直采。麻醉机和呼吸机通过标准接口入库,四大类数百项数据可按需采集。
到2025年3月,资源库登记数据超16亿条,运行超700天,累计达25亿条,手术台次超3万台,数据量超700GB。预警模型的输出也很具体:轻度低氧血症提示75758次,低血氧症提示26693次,疑似通气回路异常2051次。
这份报告的完整版、原始图表和数据附录,都放在运营动脉(www.yydm.cn)上,搜标题就能直接打开。
同类赛道的其他报告那里也都收了,顺着行业目录往下翻,比一份份到处找省事得多。
设备侧同样有账可算:平台连了院内1204台设备,麻醉专项设备覆盖率100%,调度效率提升35%。
先把采全这件事做扎实,后面才有得选——数据不用等想清楚怎么用再开始攒。
图源:《中国健康医疗数据要素应用案例集》(第9页)
八、慢病筛查:180元一例,覆盖率翻三倍
糖尿病肾病是终末期肾病的首要诱因。我国糖尿病患者1.4亿,患病率32.6%,但基层筛查覆盖很低。卡点有三个:传统方案单例380元、设备基层普及率不足两成、国际模型只能预警一两年且AUC在0.78到0.83。
珠江医院把指标压到12项,8项包含在血常规和生化常规里。模型AUC0.94,灵敏度87%,特异度83%。结果是单例成本从380元降到180元,只有传统方案的47.3%;基层筛查覆盖率从20%提到60%。
按年覆盖10万患者算,一年省下医保支出1.61亿元:透析1.29亿,住院3240万。
技术上还有一层:联邦学习做跨机构共享,数据不出院、模型动起来;SHAP给每个指标算风险贡献度。
图源:《中国健康医疗数据要素应用案例集》(第10页)
九、共性判断:医疗数据要素要过三道关
把这14个案例横着看,第一道关是确权。血清模型在广州数交所登记,心电数据做了省级资产登记,围术期库拿了国家数据知识产权登记。
第二道关是治理。报告里的案例几乎都写了同一套动作:脱敏、标准化编码、分级授权、上链留痕。第三道关是场景。能算清楚一个临床痛点的数据才卖得掉,泛泛的“数据汇聚平台”没法证明价值。
还有个细节值得注意:14个案例里有4个直接写到了钱——3000万元成果转化、3000万至5000万元估值、1.61亿元医保节约。
想判断一家医院的数据项目是不是真落地,看它有没有一个能被外部核对的数字:候检几分钟、筛查多少钱、少住几天院。
下一步值得盯的是两件事:数据资产的会计入表怎么落地,以及跨机构共享的定价规则什么时候出来。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。