


调查报告数据怎么分析?样本清洗和交叉分析这2步先做
 广告
调查报告数据分析不是算百分比,关键在样本清洗和口径统一这2步。顺序反了,后面每一张图都白做,而且很难发现错在哪。
我见过太多报告,结论写得很漂亮,但一翻附录,样本里有三分之一是废卷,而且没人说得清那三分之一是怎么来的。
这不是数据的问题,是流程的问题。流程里少做两步,后面每一步都在放大误差,而且放大得看不出来。
那三分之一没被洗掉,结论就一直悬着。
这就是顺序为什么要放在最开始讲,而不是留到最后复盘时才提一句。
所以我把这几年的做法按顺序拆开写。
下面先拿一份现成的报告当参照,再讲具体怎么动手。
先看清一份能当范例的报告是怎么搭的
2026年3月,中国消费者杂志社联合河北、黑龙江、江苏、浙江、江西、山东、重庆、云南、西藏、陕西、青海,以及沈阳、南京、成都等14个省、市、自治区消协组织,共同发布了一份调查报告,题目是《谁在盯着父母的手机?》,副题是银发用户手机使用行为调查报告。
它的目录结构很规整,值得直接照抄:调查背景、调查目的、调查方法、调查结果、相关建议。调查结果下面分六块,日常使用行为、诱导误触风险、隐私泄露风险、消费陷阱与算法风险、维权认知与处理、适老化改进诉求。
这个结构值得直接抄。背景讲为什么问,目的讲要答什么,方法讲怎么问,结果讲答出了什么,建议讲怎么办。
背景那一节用了两个数:截至2025年末,我国60岁以上老年人口32338万人,占全国总人口23.0%;截至2025年6月,60岁及以上银发网民规模1.61亿人,老年群体互联网普及率52.0%。
两个数放在一起,问题的规模就出来了。3.2亿人的群体里,有1.6亿在上网,中间那1.6亿没上网的,恰好是下一次要覆盖的人。
目的那一节其实写的是判断,不是愿望。它没有写"了解银发用户手机使用情况",而是把风险分成了四类:诱导误触、隐私泄露、消费陷阱与算法、维权困难。
四类一分开,问卷的骨架就出来了。
来源:2026谁在盯着父母的手机-银发用户手机使用行为调查报告-中国消费者杂志社(第4页)
后面的清洗规则也有地方挂,因为它们最后都要落到这四类风险上,一类对应一组题目。
这正是我建议你先看一眼别人的报告结构的原因,结构不对,题目必乱。第一步:样本清洗,先定规则再动手
清洗不是"把可疑的删掉",是把规则写下来再删。规则写不下来,删了也没法解释,下次换个人做出来的结果就不一样。
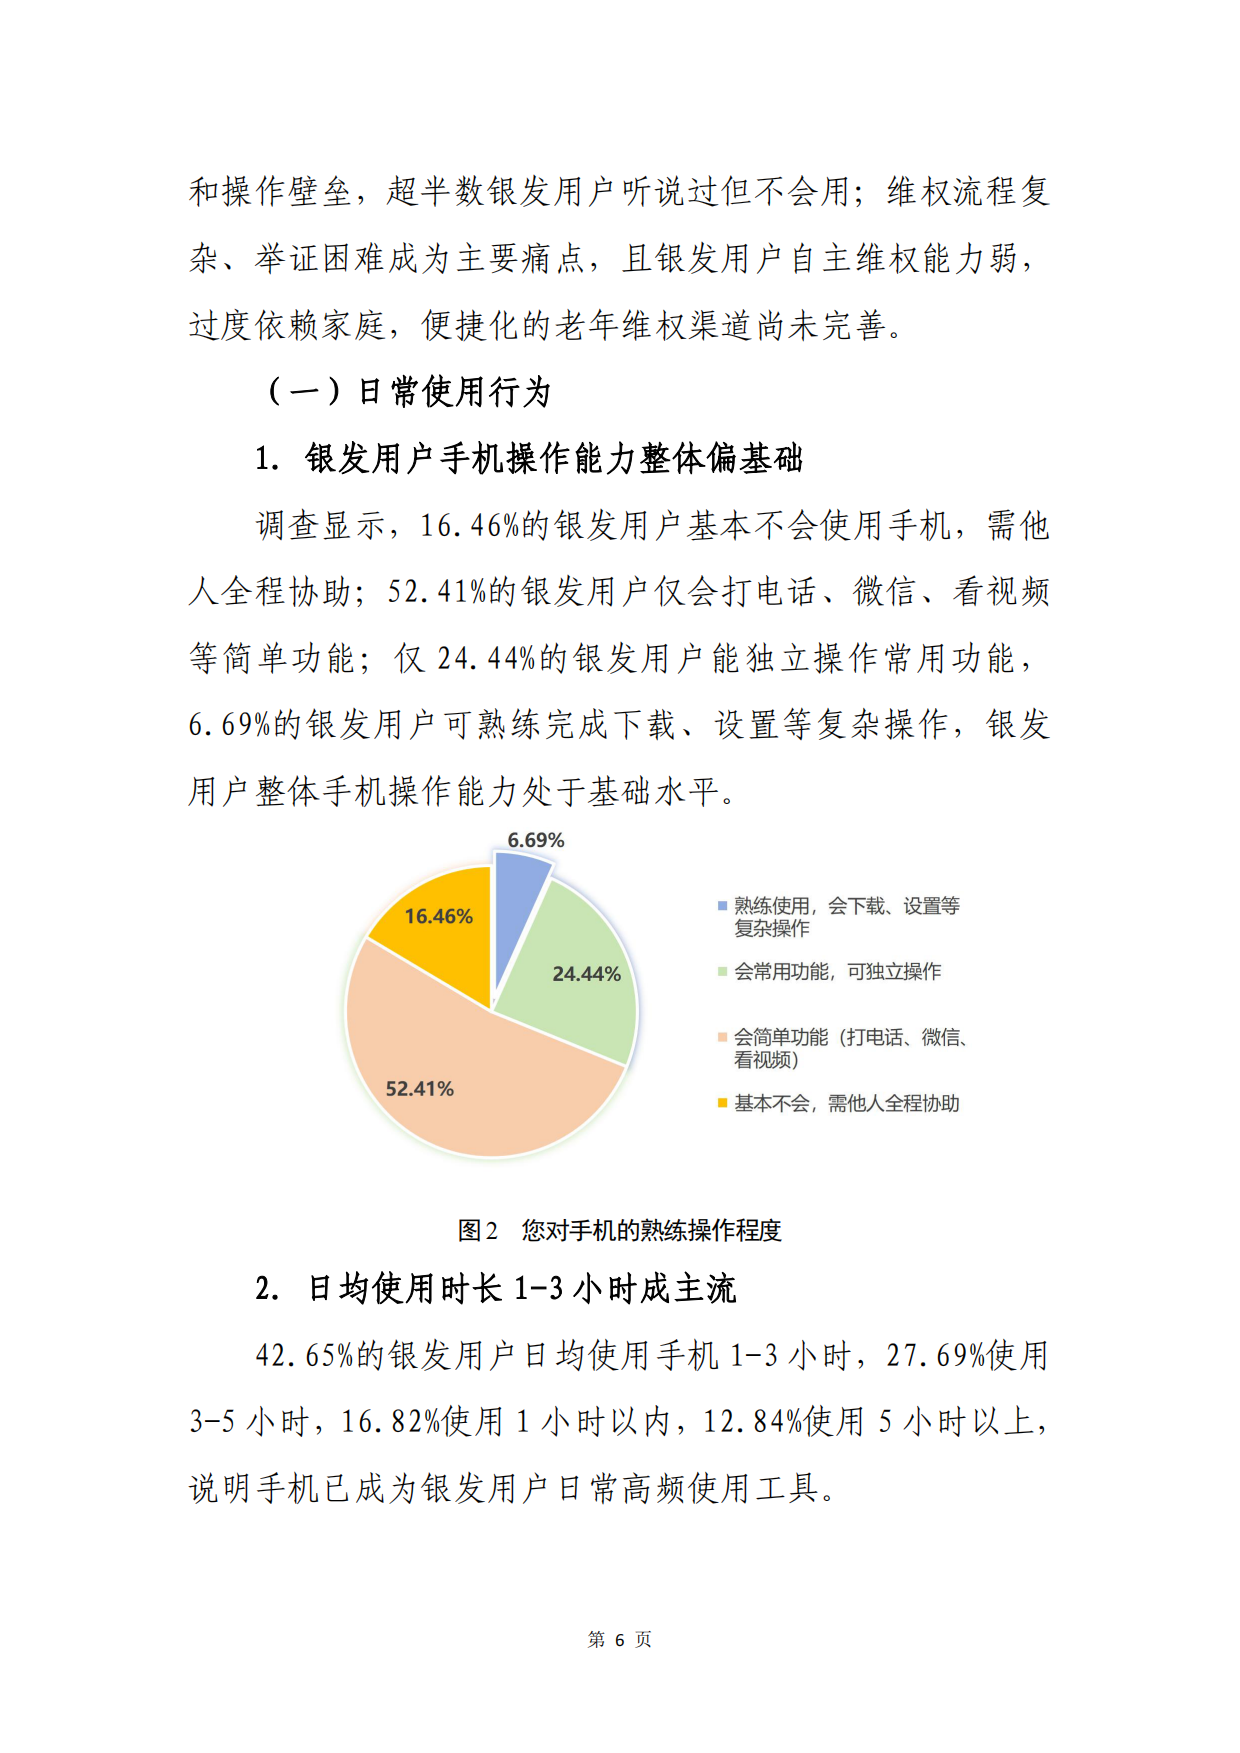
来源:2026谁在盯着父母的手机-银发用户手机使用行为调查报告-中国消费者杂志社(第9页)
我手里的清洗规则是六条,按优先级排。其一,答题时长。低于全部样本中位时长三分之一的,直接标记。这条抓的是乱点。
其二,直线作答。所有量表题选同一个选项的,标记。这类样本不是没看题,是不愿意想。
接下来两条挑的是硬伤。
最后一条是底线。
其三,逻辑冲突。比如前面答"每天用手机不到1小时",后面答"每天刷短视频3小时以上",前后必须能对上。
前面三条最管用,也最省事。
其四,关键题缺失。核心变量空着的,不管其他题填得多完整,都不能进分析。
其五,开放题灌水。开放题只有"好""无""不知道"这类词的,标记但不删,它本身是一个信号。
六条里我砍得最狠的永远是前两条,抓的都是同一件事——没认真答。
银发调查里年龄不达标的,或者不符合筛选题条件的,直接剔除。六条规则用下来,删掉的量一般占总样本的8%到15%,这是一个比较健康的区间。
超过20%,我会先停下来检查问卷本身,而不是继续删。
因为删得太多通常意味着两件事之一:题目太绕,或者投放渠道不匹配。
这两个问题不是清洗能解决的,得回到问卷和投放那一层去改。
清洗的产出不是一张干净的数据表,是一份写清楚"删了什么、为什么删"的记录。这份记录要放进附录,读者才会信你的结论。
还有一件常被忽略的事:清洗要在合并数据之前做。多个渠道收上来的表先各自清洗,再合并。合并之后才洗,你分不清问题出在哪个渠道。
第二步:口径一致,把同一个词钉成一个数
清洗解决"哪条数据能用",口径解决"这条数据算的是谁"。前者管行,后者管列。
举个例子。"日均使用时长1到3小时"这个分类,如果问卷里既有"1小时以内",又有"不到60分钟",合并的时候就会重复。这就是口径不一致。
我的做法是先列一份变量对照清单,两列:问卷原题、分析口径,一题一行。每一个分类变量的边界都要写清是开区间还是闭区间。
银发那份报告的做法可以拿来当参照。它的第一块结果叫日常使用行为,其中第二个发现是"日均使用时长1到3小时成主流"。
这个表述很稳。它没说"平均每天使用2.1小时",因为中位数和均值在偏态分布里差得很远。它给的是一个区间,这是调查报告该有的说法。
同一块里的第四个发现是"长辈模式使用率有待提升"。这个"有待提升"是结论,不是数字。它的价值在于,后面建议那一节里平台方要"推进精准适老化改造"就跟它直接对上了。
所以口径一致不只是区间边界的问题,还有结论表述的分寸:能用区间就不用点值,能用方向词就不用精确百分比。
我给自己定过一条规矩:凡是用来做判断的数字,必须能回答"这个数从哪来、算的是谁、边界在哪"。三个问题回答不全,就先别往报告里写。
调研数据怎么分析:交叉分析才是这份报告最值钱的地方
先把交叉分析这一块说透,它是整份报告的重心,也是最能拉开水平的地方。
百分比是结果,交叉项才是发现,这是两件事,也对应两种完全不同的写作方式。银发那份报告在"诱导误触风险"这一块写了三条:诱导性弹窗广告遭遇率高、超半数银发用户存在弹窗误触行为、误触引发页面跳转和自动下载频发。
这个话题往深里做还有很多层,运营动脉上同类的方案和课件存量不少,需要的时候按主题翻就行。
注意这三条的排列:先遭遇率,再误触率,最后是后果。它是一个因果链,不是三个并列的百分比。
这种排法本身就是一种分析。读的人跟着这条链走一遍,就知道问题严重在哪一环,该在哪一环下手。
再看"隐私泄露风险"那一块的三条:对App权限的关注和识别能力薄弱、手机操作存在陌生人委托情况、超六成银发用户感知到个人信息泄露。
这三条里,中间那条最值得做交叉。陌生人委托手机操作,跟年龄、跟独居与否、跟子女是否同城,几乎一定有关联。
我把这个思路做成三个固定的交叉维度,任何一份问卷都能套,填空就行。
第一维,按人群属性交叉。年龄、性别、地域、收入、家庭结构。这一维回答"谁的问题最严重"。
第二维,按行为交叉。使用频次、使用时长、常用功能。这一维回答"什么行为带来了问题"。
第三维,按态度交叉。信任度、满意度、改进意愿。这一维回答"他们自己怎么想"。
来源:2026谁在盯着父母的手机-银发用户手机使用行为调查报告-中国消费者杂志社(第2页)
三维都做完,你会发现真正有意思的发现,几乎都在"某一人群 + 某一行为"的组合里。单看总体的百分比,永远出不了这个层次的结论。
样本量这件事,先算清能拆到多细
很多人拿到样本就急着做交叉,做完发现某一格只有十几个样本,硬着头皮写进报告。这是最常见的硬伤。
我的经验标准是:任何一个要在正文里单独讲的格子,样本不能少于30个。低于30个,差异再大也是噪音。
按这个标准倒推,你就会知道样本量该怎么定。要做三乘三的交叉,至少需要 9 乘 30,也就是270个,而实际还得留清洗损耗,所以目标应该定在350以上。
银发那份调查没有公开总的样本量,但它联合了14个省、市、自治区的消协组织共同发布,这种规模的联合调查,通常就是为了保证每个地区都有足够的样本可拆。
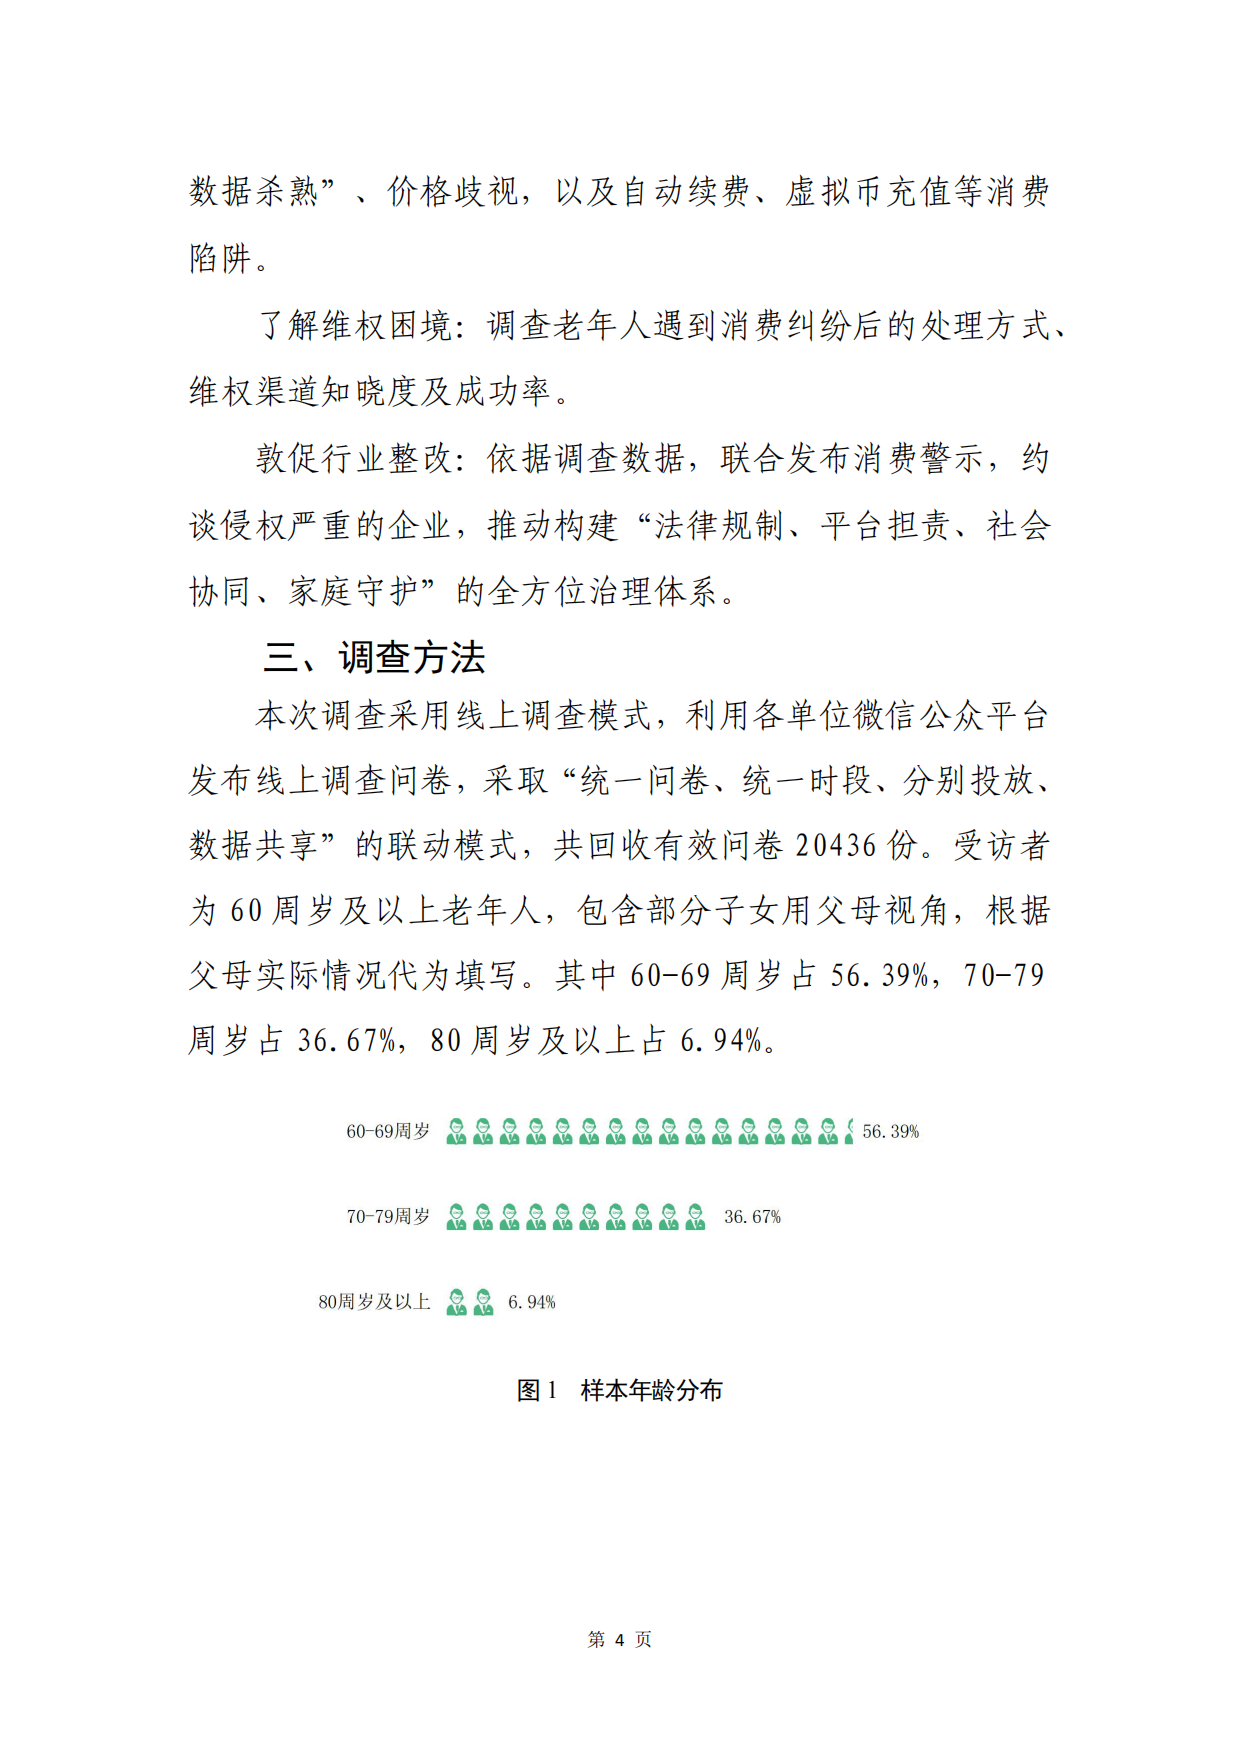
来源:2026谁在盯着父母的手机-银发用户手机使用行为调查报告-中国消费者杂志社(第7页)
如果你预算有限,做不了这么大的量,那有一个替代办法:把交叉维度减到一维,把样本集中在一件事上。
宁可只回答一个问题,也不要用三百个样本去回答九个问题。前者能写进决策,后者只能写进PPT。
怎么判断一个交叉项值不值得写进报告
交叉项做多了会泛滥。一份报告里塞二十个交叉结果,读者一个都记不住。
我的筛选标准是三条,从宽到严,大部分交叉项会败在差异这一关上。
先看差异够不够大。两个组的差至少在10个百分点以上,我才认为值得单独说。差5个点的,写进正文会误导读者。
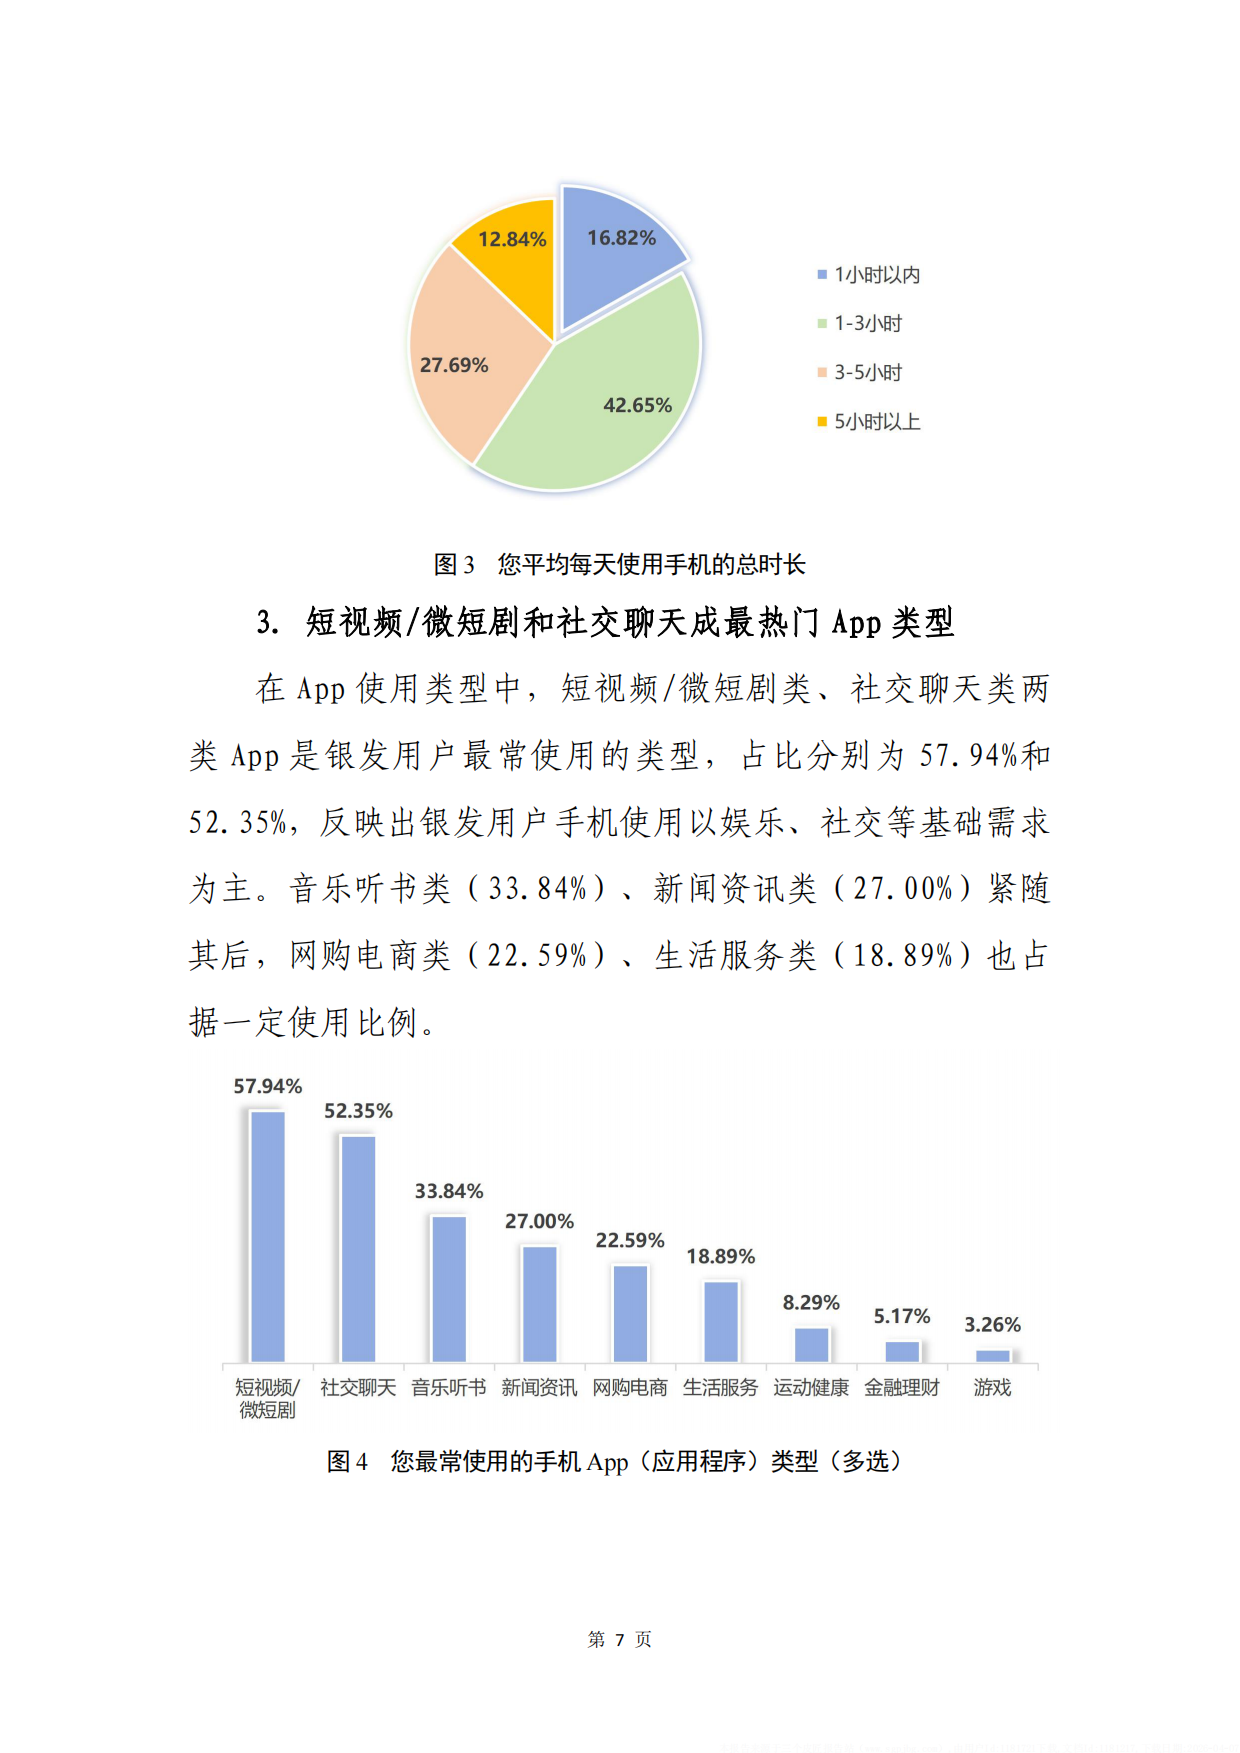
来源:2026谁在盯着父母的手机-银发用户手机使用行为调查报告-中国消费者杂志社(第10页)
再看方向能不能解释。差异大但解释不了,多半是样本量不够,或者是某个组的样本太少。这类要标出来,不能当结论用。
最后看它跟预期是否相反。这是最有价值的一类。调研报告真正值钱的不是百分比,是那些跟预期不一样的交叉项。
举个通用例子。你预期"年纪越大,误触率越高",结果发现65到70岁这一段反而比60到65岁低。这就要停下来问为什么。
可能的原因有两个:这一段的样本里退休教师、退休干部占比高,或者这一段的子女更愿意帮着设置手机。不管哪个原因,它都是一个可以拿去讲的新发现。
关于显著性,我要说一句实用的。样本量两三千的调研,卡方检验很容易过,因为样本一大,微小差异也显著。
所以我的做法是不只看显著性,还看效应大小。显著但不重要的差异,不写。
具体到操作上,我会在交叉表旁边加一列"差值",差值不到10个点的,就算p值小于0.05,我也会把它压到脚注里去,不占正文。
图表选择:一张图只回答一个问题
然后说图。
图的错误率比数字高得多,因为它一眼看上去就像对的。
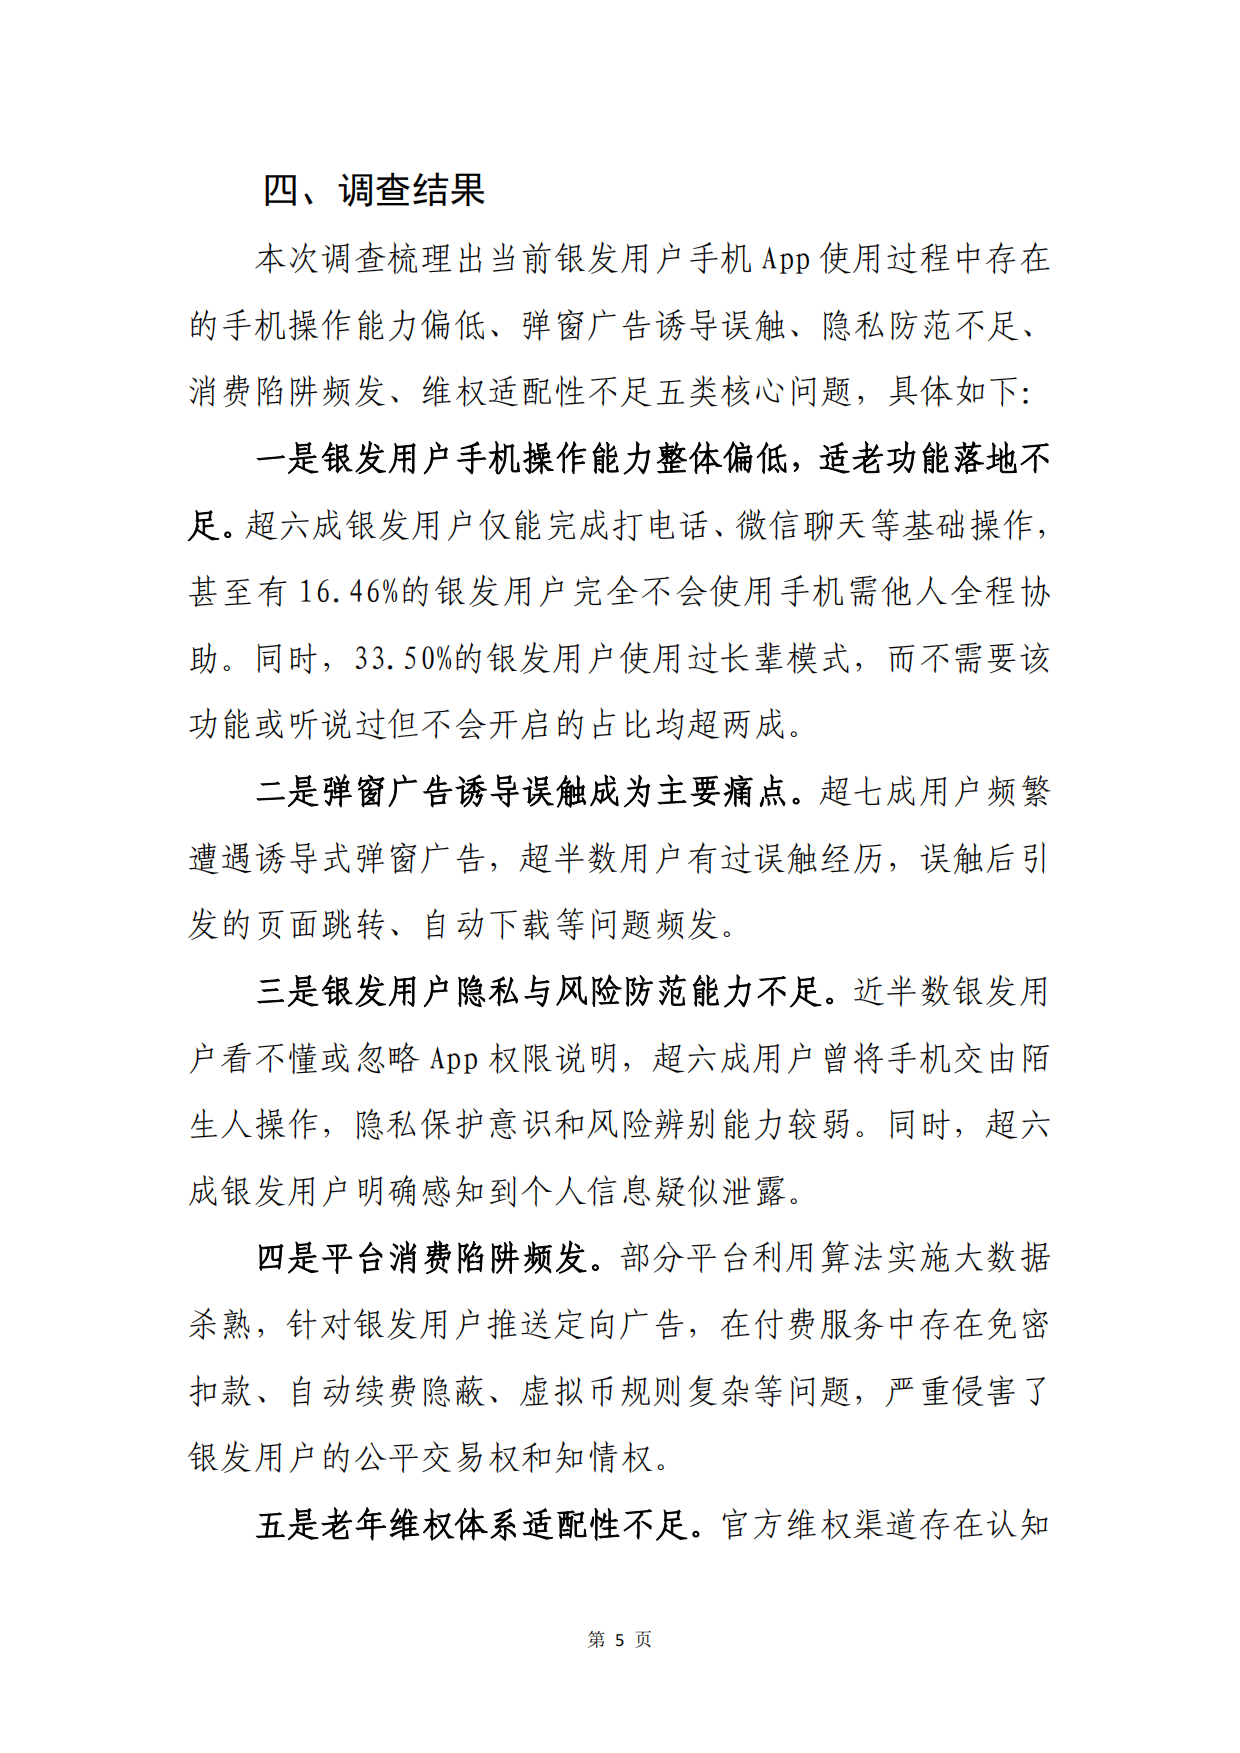
来源:2026谁在盯着父母的手机-银发用户手机使用行为调查报告-中国消费者杂志社(第8页)
图的错误比数的错误更常见,因为图会把错误放大,而且放大得让人看不出来。我的选择规则很固定,四句话。比较几个类别的多少,用条形图,不用饼图;看随时间的变化,用折线图;看两组人的分布差异,用堆叠条形图。
看两个变量的关系,用散点或者交叉表。饼图只在一个时候能用:所有类别加起来正好是100%,而且类别不超过5个。
还有两个细节。第一,纵轴从0开始。不从0开始的条形图,会把3%的差异画成三倍。第二,同一份报告里的图,配色和字号要一致,不然读者每翻一页都要重新适应。
银发那份报告在结构上做对了一件事:每个发现下面都有一个明确的小标题,小标题本身就是结论。比如"超半数银发用户存在弹窗误触行为"。读者只看标题,也能拿到主干。
我建议你写报告时先写小标题,全部写完再配图和正文。如果小标题连不起来,说明你的分析还没有形成链条。
问卷数据分析方法里,开放题编码别急着数词频
然后是开放题,这一块最需要耐心。
开放题是问卷里最贵的一题,也最容易被浪费。多数人拿到之后,把高频词数一遍就交差,以为那是分析。数词频能告诉你大家提到了什么,但不能告诉你他们为什么提。而后者才是分析该做的事。
我的编码流程是四步。第一步,先随机读50条,不做任何标注,只求有感觉。第二步,从这50条里归纳出5到8个类目。
第三步,拿这5到8个类目去编全部答案,编不下去的,归到"其他",但"其他"超过15%就要回头改类目。
第四步,给每个类目挑三条最有代表性的原话,直接写进报告。
第四步最容易被跳过,也最能提升报告的说服力。一句原话的力量比一个百分比大得多。
银发那份报告在背景和问题描述里,就用了不少这类原话式的场景:常遇到"红包弹窗""看剧领金币""测运势""免费领"这类界面,一旦误触便跳转第三方页面,页面上的按钮进一步诱导点击"领取""确认""下一步"。
这些不是统计结果,是场景还原。但读者一看就懂,因为它跟自己的经验对得上。好的报告里,数字负责说服,场景负责让人相信。
结论提炼:把发现写成一句能被反驳的话
最后是结论,也是最容易写成套话的地方。
我判断一条结论写得好不好,只有一个标准:它能不能被反驳,而且反驳它需要动脑子。能反驳,说明它有具体内容;不能反驳,说明它是废话。"用户对隐私比较关注"反驳不了,因为它对谁都成立。
"60岁以上用户里,会主动去设置里关权限的不到一半,但同一批人里有六成感知到自己信息被泄露过"——这条能被反驳,因为它给了两个具体的行为与感知,还能拿去验证。
写结论的顺序我建议倒着来:先写你想要的那句话,再回头找能支撑它的数据。找不到,就换一句话。
不要反过来,先摆一堆数据再想能得出什么,那样得出的结论一定是四平八稳的。
结论的数量也要控制。一份报告的主结论不超过三条,每条下面最多三个支撑。超过这个数,读者记不住,你自己也讲不清。
最后是结论边界。每条结论后面加一句限定,说明它适用于谁、不适用于谁。这一句很短的,但它决定了报告会不会被误用。
银发那份报告的建议那一节分了四个主体:平台方要坚守银发用户权益底线、推进精准适老化改造;监管方要加强执法监管、完善老年维权体系;家庭与社会要提高银发用户风险防范意识、构建家庭与社会守护体系;行业协会要制定相关行业标准、推动行业自律。
四个主体各自对应一类发现。这是结论边界的另一种写法:不给一个笼统的建议,而是把建议分给能执行它的人。
一份可以直接照着走的七步流程
前面说的这些,落成流程就是七步。我每次做调研都按这个顺序走,跳过任何一步都会返工。
第一步,把问卷原题和所有选项导出来,逐题写下这道题要回答什么。第二步,按六条规则做清洗,同时记清洗日志。
第三步,细化变量口径清单,把每个分类的边界钉死。第四步,先出总体的描述统计,看分布有没有异常。
第五步,做三维交叉,按差异、方向、反预期三条筛。第六步,为每条结论找图和原话,图一图一问,原话三条以内。
来源:2026年印尼人造植物市场调查报告-潮域展览(第2页)
第七步,写结论边界,把建议分给对应的执行主体,一个主体一条,不混着写。
七步里,第二步和第三步最枯燥,也最决定成败。这两步省下来的时间,后面一定会用三倍的时间补回去。
预算有限的时候,我的建议是把有限的钱花在清洗规则和交叉设计上,不要花在花哨的图表上。一张朴素的条形图配一个真实的交叉结论,比十张漂亮的图有用。
下一步你可以先做一件最小的事:把手上那份数据按六条规则过一遍,记录每一类删了多少。
删完之后如果总数没变,那说明你的数据很干净;如果删掉超过两成,先别急着往下分析,回头改问卷。调查报告的可信度,八成来自这两步做没做。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。







