AI语料是什么?42页报告拆中文语料规模与两类榜单
 广告
本文解读:《2026中国语料市场发展及榜单报告》 · 共 42 页 · 原文
这份报告最硬的一句话是:通用语料已经够用,真正卡住模型上限的是只有万亿量级的垂直语料。
《2026中国语料市场发展及榜单报告》由亿欧智库与上海库帕思科技联合发布,2026年7月,共42页,分人工智能语料发展现状、行业需求特征、语料风云榜榜单、优秀案例分析四部分。
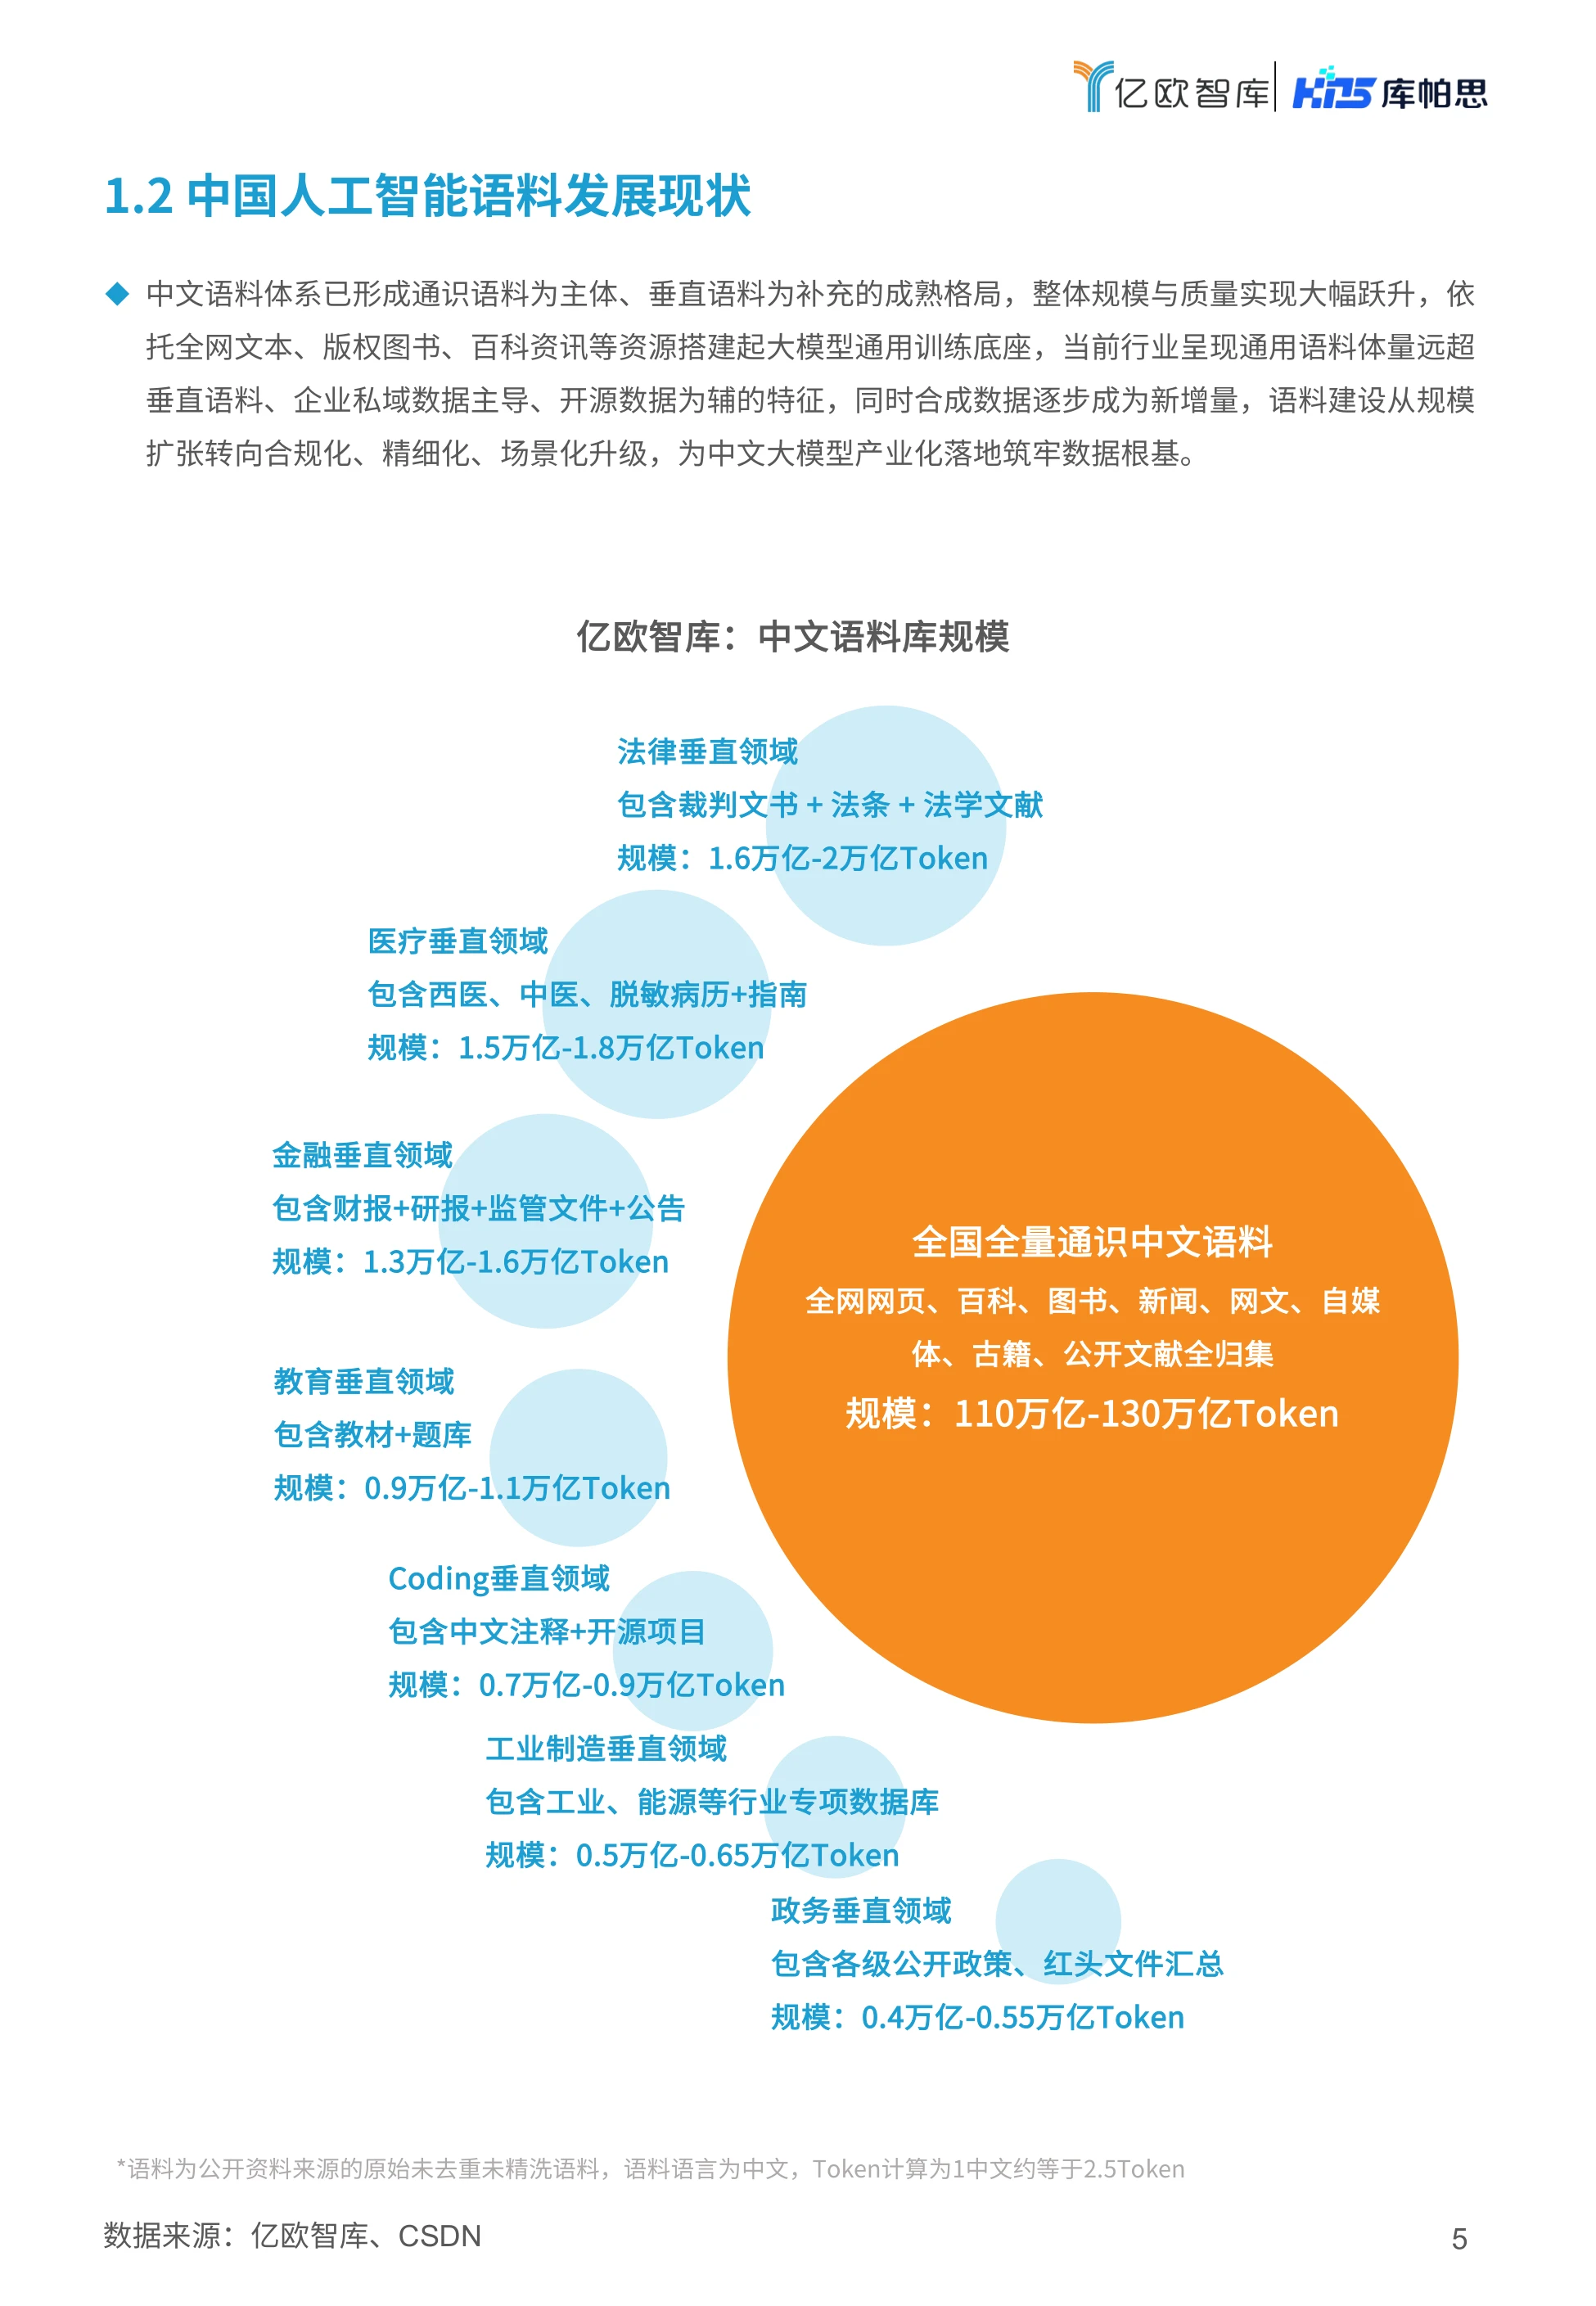
报告统计的中文语料库里,全网通识语料规模在110万亿至130万亿Token之间,按1个中文约等于2.5Token折算,体量已经相当可观。而垂直领域最大的法律也只有1.6万亿至2万亿Token,医疗1.5万亿至1.8万亿,金融1.3万亿至1.6万亿,差距接近两个数量级。
通用语料决定一个模型的下限,垂直语料决定它能进哪个行业、能干哪门活。
图源:《2026中国语料市场发展及榜单报告》(第1页)
一、需求端正在变广、变深、变真
报告把语料需求的演进压成三个字:更广、更深、更真,分别对应数据来源、加工深度和任务形态。“更广”是持续拓展网络、书籍、行业和真实场景等通用与专业数据,先把覆盖面做全,再谈质量。
“更深”是通过多模态加工和专家知识提炼,把复杂逻辑与隐性经验转化成模型可以学习的数据。“更真”是围绕代码、智能体和真实业务任务,沉淀可运行、可交互、可反馈的过程数据。
需求在升级,就会倒推生产端跟着迭代,这条链子也是贯穿报告的主逻辑。
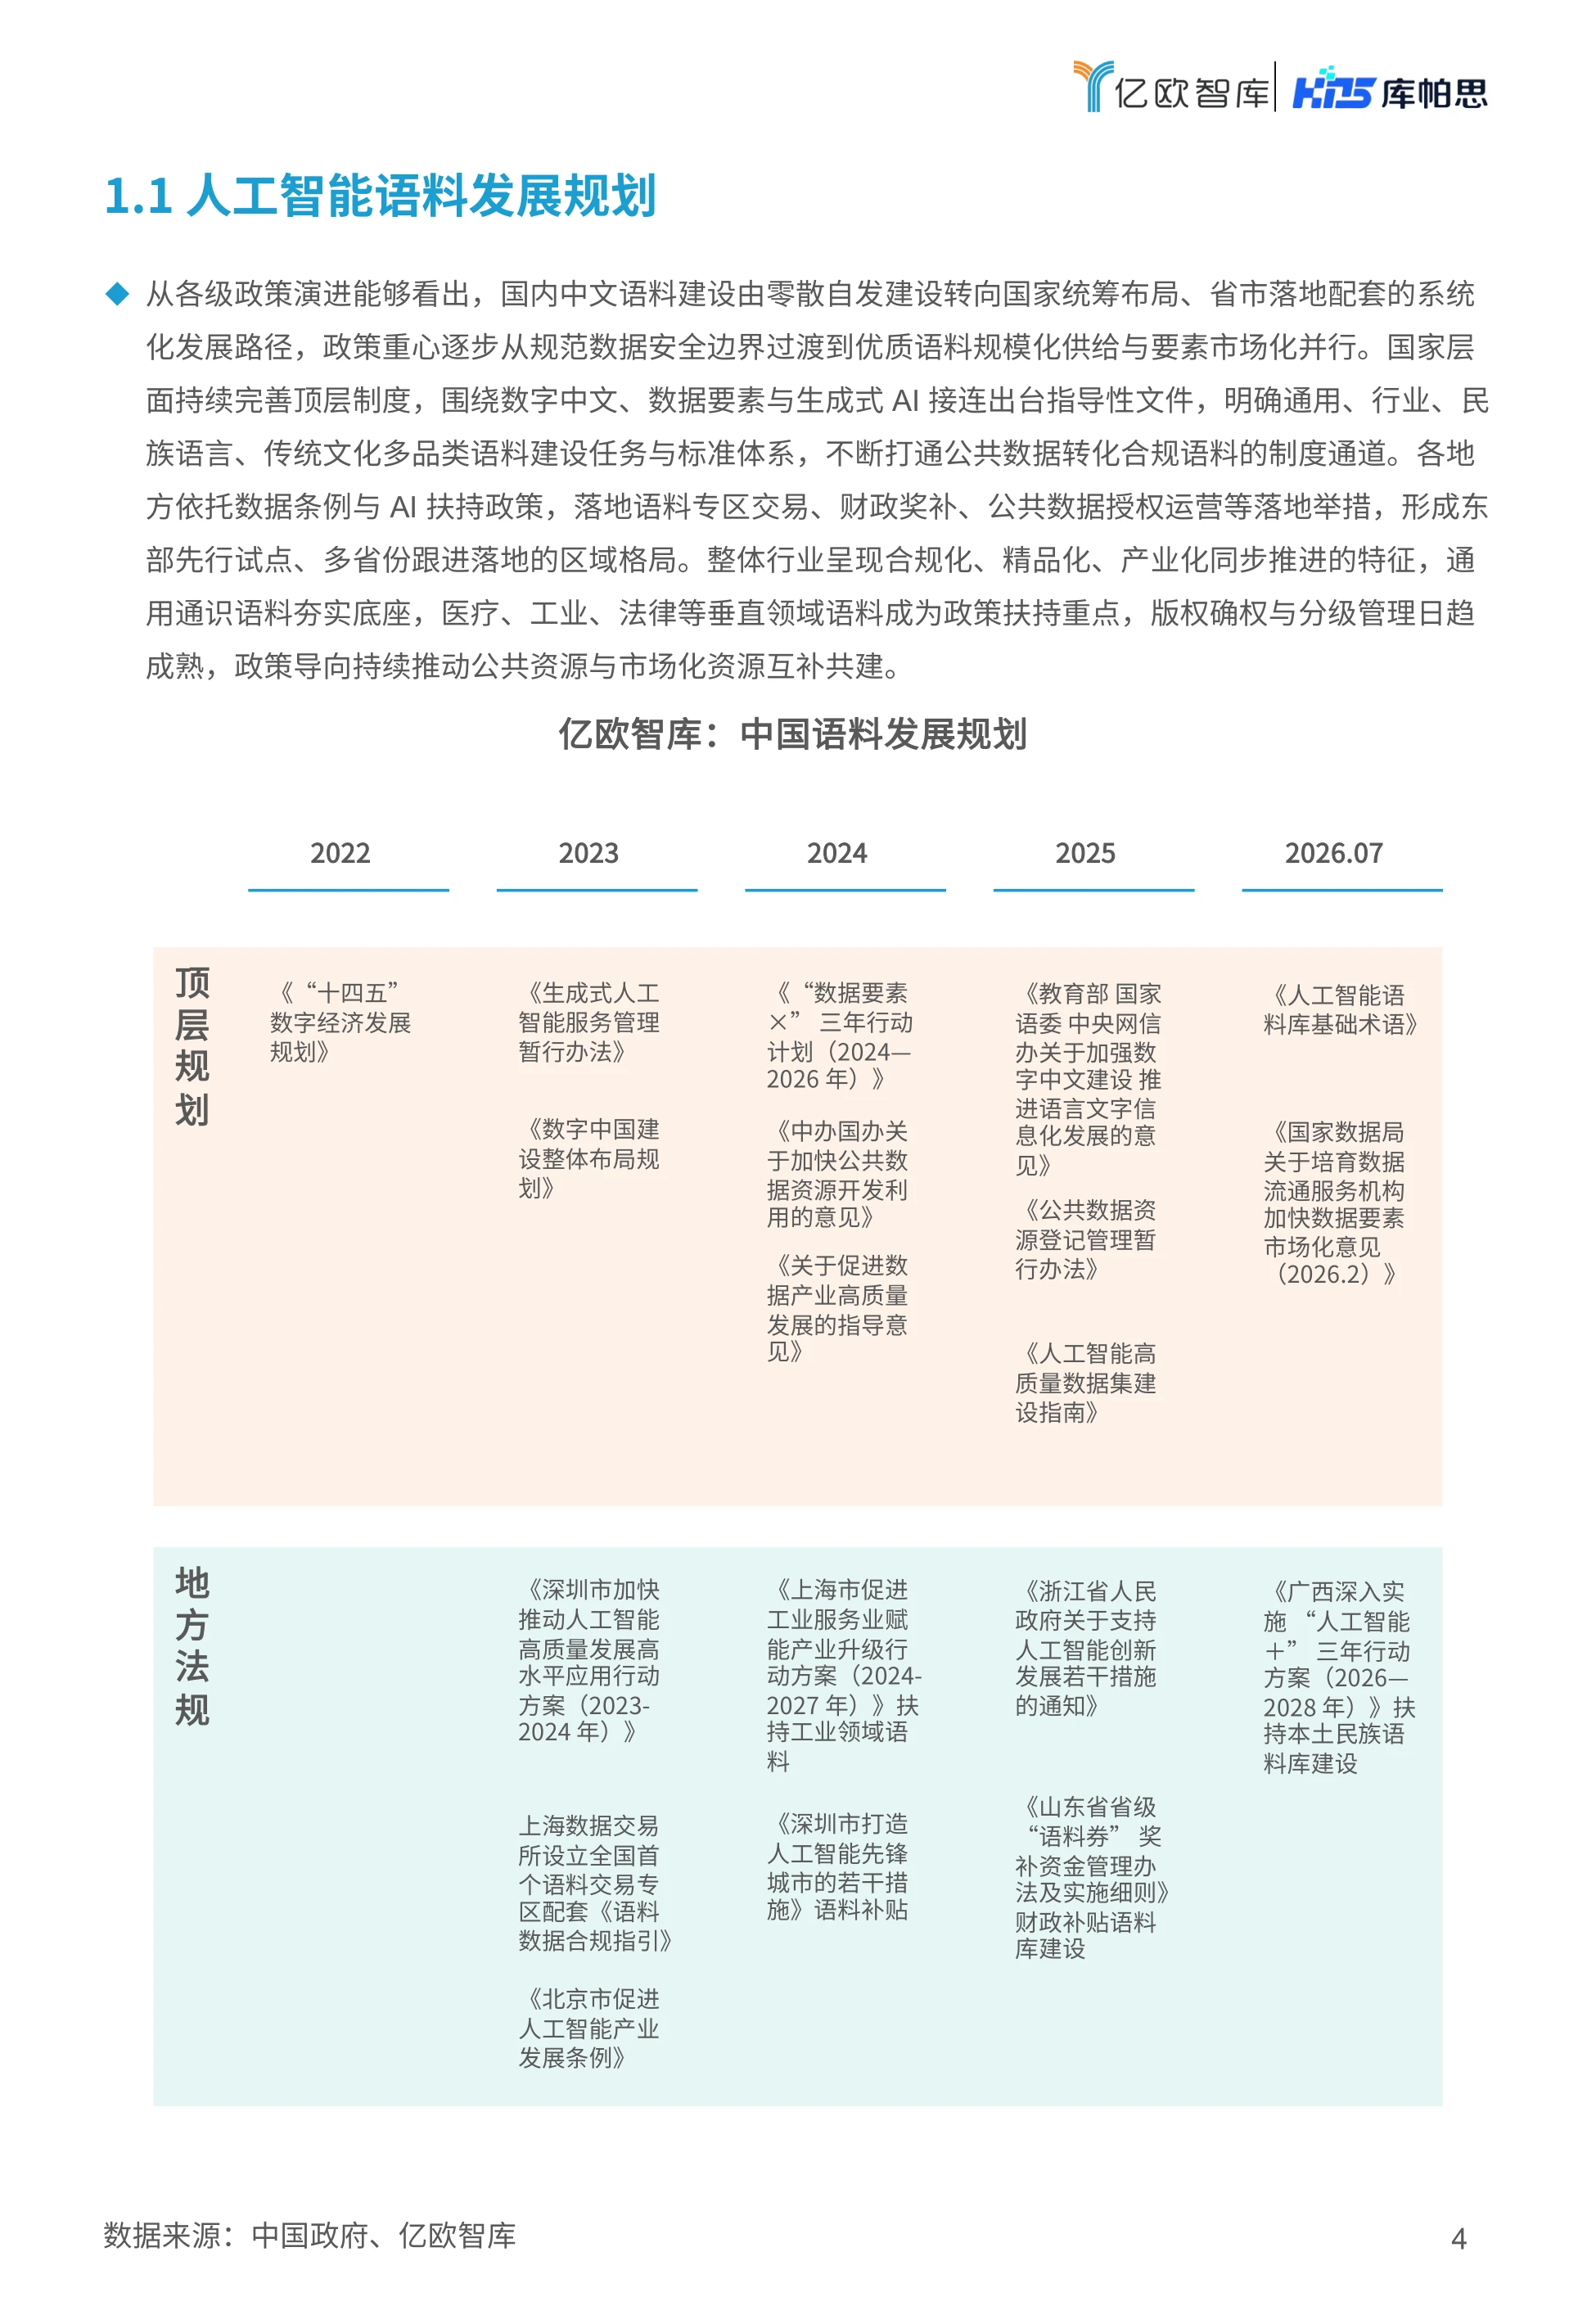
生产端也随之从传统的数据筛选,走向知识转换与环境合成这两条新路。
图源:《2026中国语料市场发展及榜单报告》(第3页)
二、中文语料家底:一个通识底座加七个垂直池
报告画了一张中文语料库规模图,通识语料是绝对主体,七个垂直领域是补充,结构相当清楚。通识部分覆盖全网网页、百科、图书、新闻、网文、自媒体、古籍和公开文献,规模为110万亿至130万亿Token。
行业整体呈现通用语料体量远超垂直语料、企业私域数据主导、开源数据为辅的特征,合成数据正成为新增量。报告特别注明统计口径:公开来源的原始语料,未去重、未精洗,Token按1个中文约等于2.5个折算。
这个口径意味着真实可用量要打不小的折扣,去重精洗之后还会再缩水。
图源:《2026中国语料市场发展及榜单报告》(第4页)
三、垂直语料差两个数量级,稀缺就稀缺在这儿
七个垂直领域里法律体量最大,1.6万亿至2万亿Token,包含裁判文书、法条和法学文献。医疗1.5万亿至1.8万亿,覆盖西医、中医和脱敏病历;金融1.3万亿至1.6万亿,来自财报、研报、监管文件和公告。
再往下是教育0.9万亿至1.1万亿、Coding 0.7万亿至0.9万亿、工业制造0.5万亿至0.65万亿、政务0.4万亿至0.55万亿。和通识语料的上百万亿相比,垂直语料差了两个数量级,而模型的专业能力恰恰只认这一层。
公共数据转语料、出版资源转语料,是目前最现实的两条供给路径,也最快见效。
图源:《2026中国语料市场发展及榜单报告》(第5页)
四、四道阻碍,卡的都是制度而不是技术
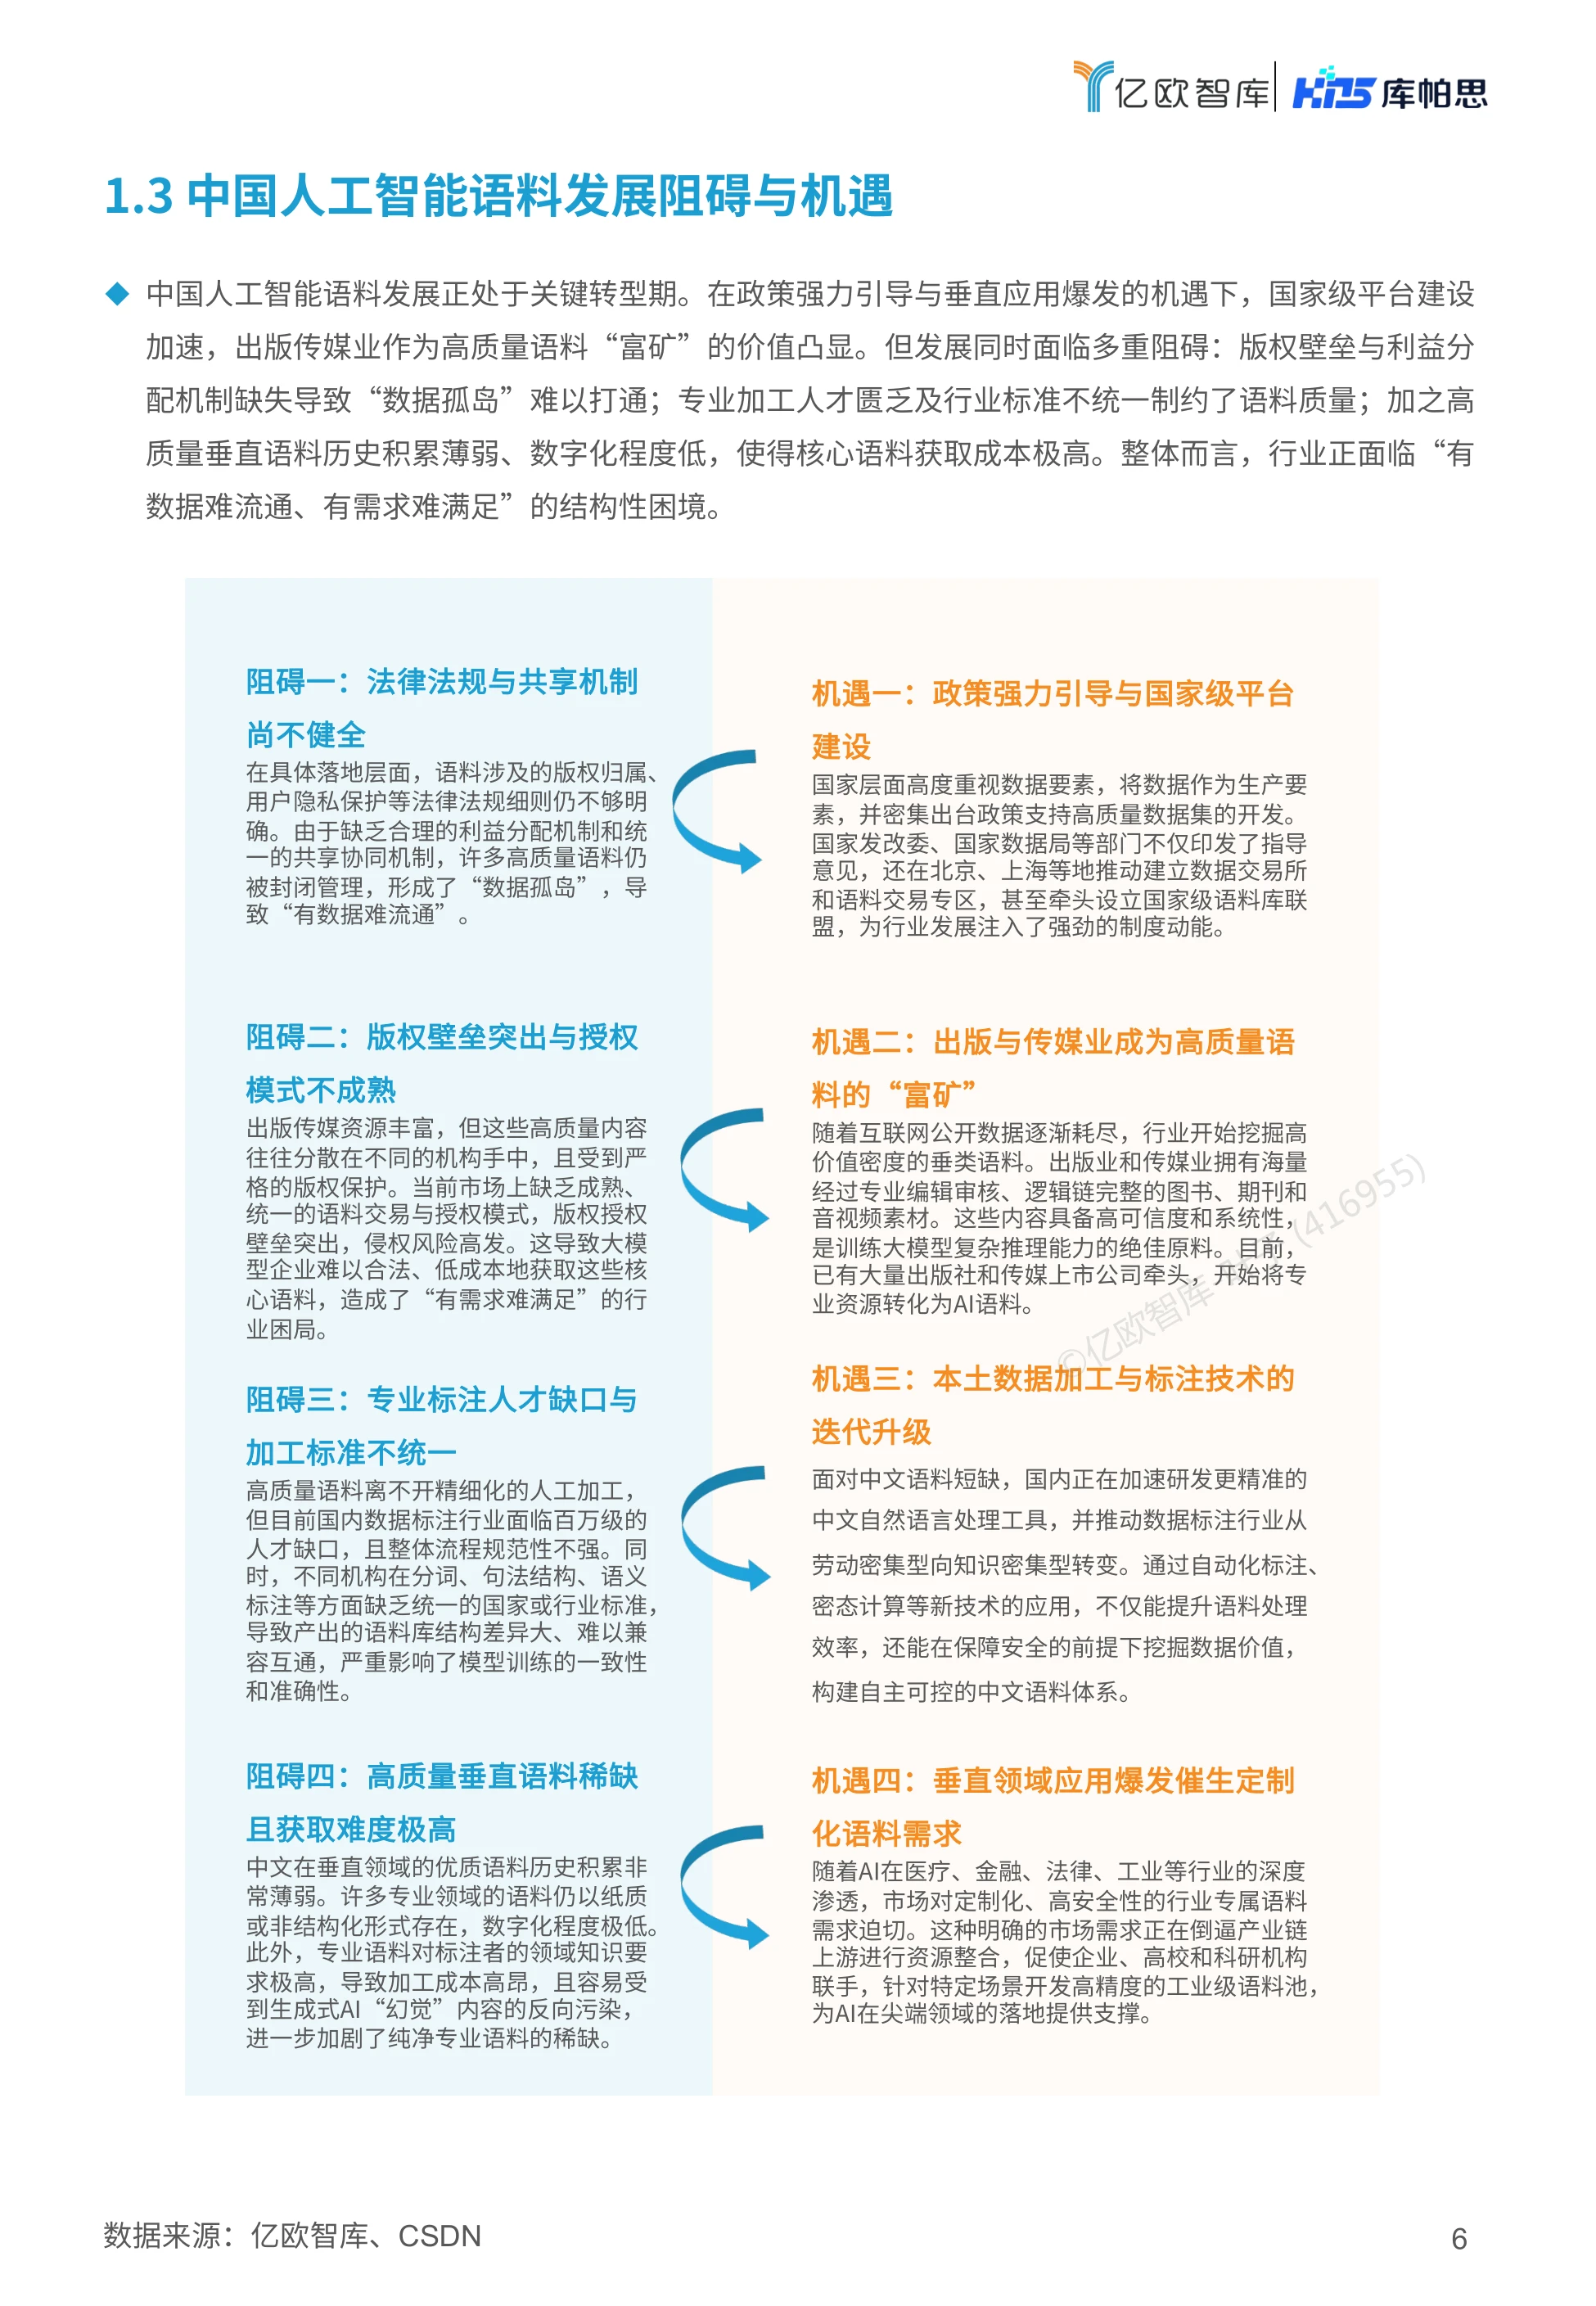
报告列了四道阻碍,指向同一个结构性困境:有数据难流通、有需求难满足。第一道是法律法规与共享机制不健全,版权归属和隐私保护细则不明确,缺少利益分配机制,高质量语料被封闭成数据孤岛。
第二道是版权壁垒与授权模式不成熟,出版传媒资源分散在不同机构手里,没有统一的交易与授权模式,侵权风险高。
第三道是专业标注人才缺口达百万级,分词、句法、语义标注缺乏统一标准,各家产出的语料库难以兼容互通。
第四道是高质量垂直语料稀缺,不少专业资料仍以纸质或非结构化形式存在,数字化程度极低,还要防生成式AI幻觉内容反向污染。
垂直语料的体量差了两个数量级,供给方式也就注定和通识语料不一样。
这四道阻碍没有一道能靠单家企业自己解决,得跨行业一起把底座搭起来。
图源:《2026中国语料市场发展及榜单报告》(第6页)
五、需求潜力打分:医疗100分,具身智能80分
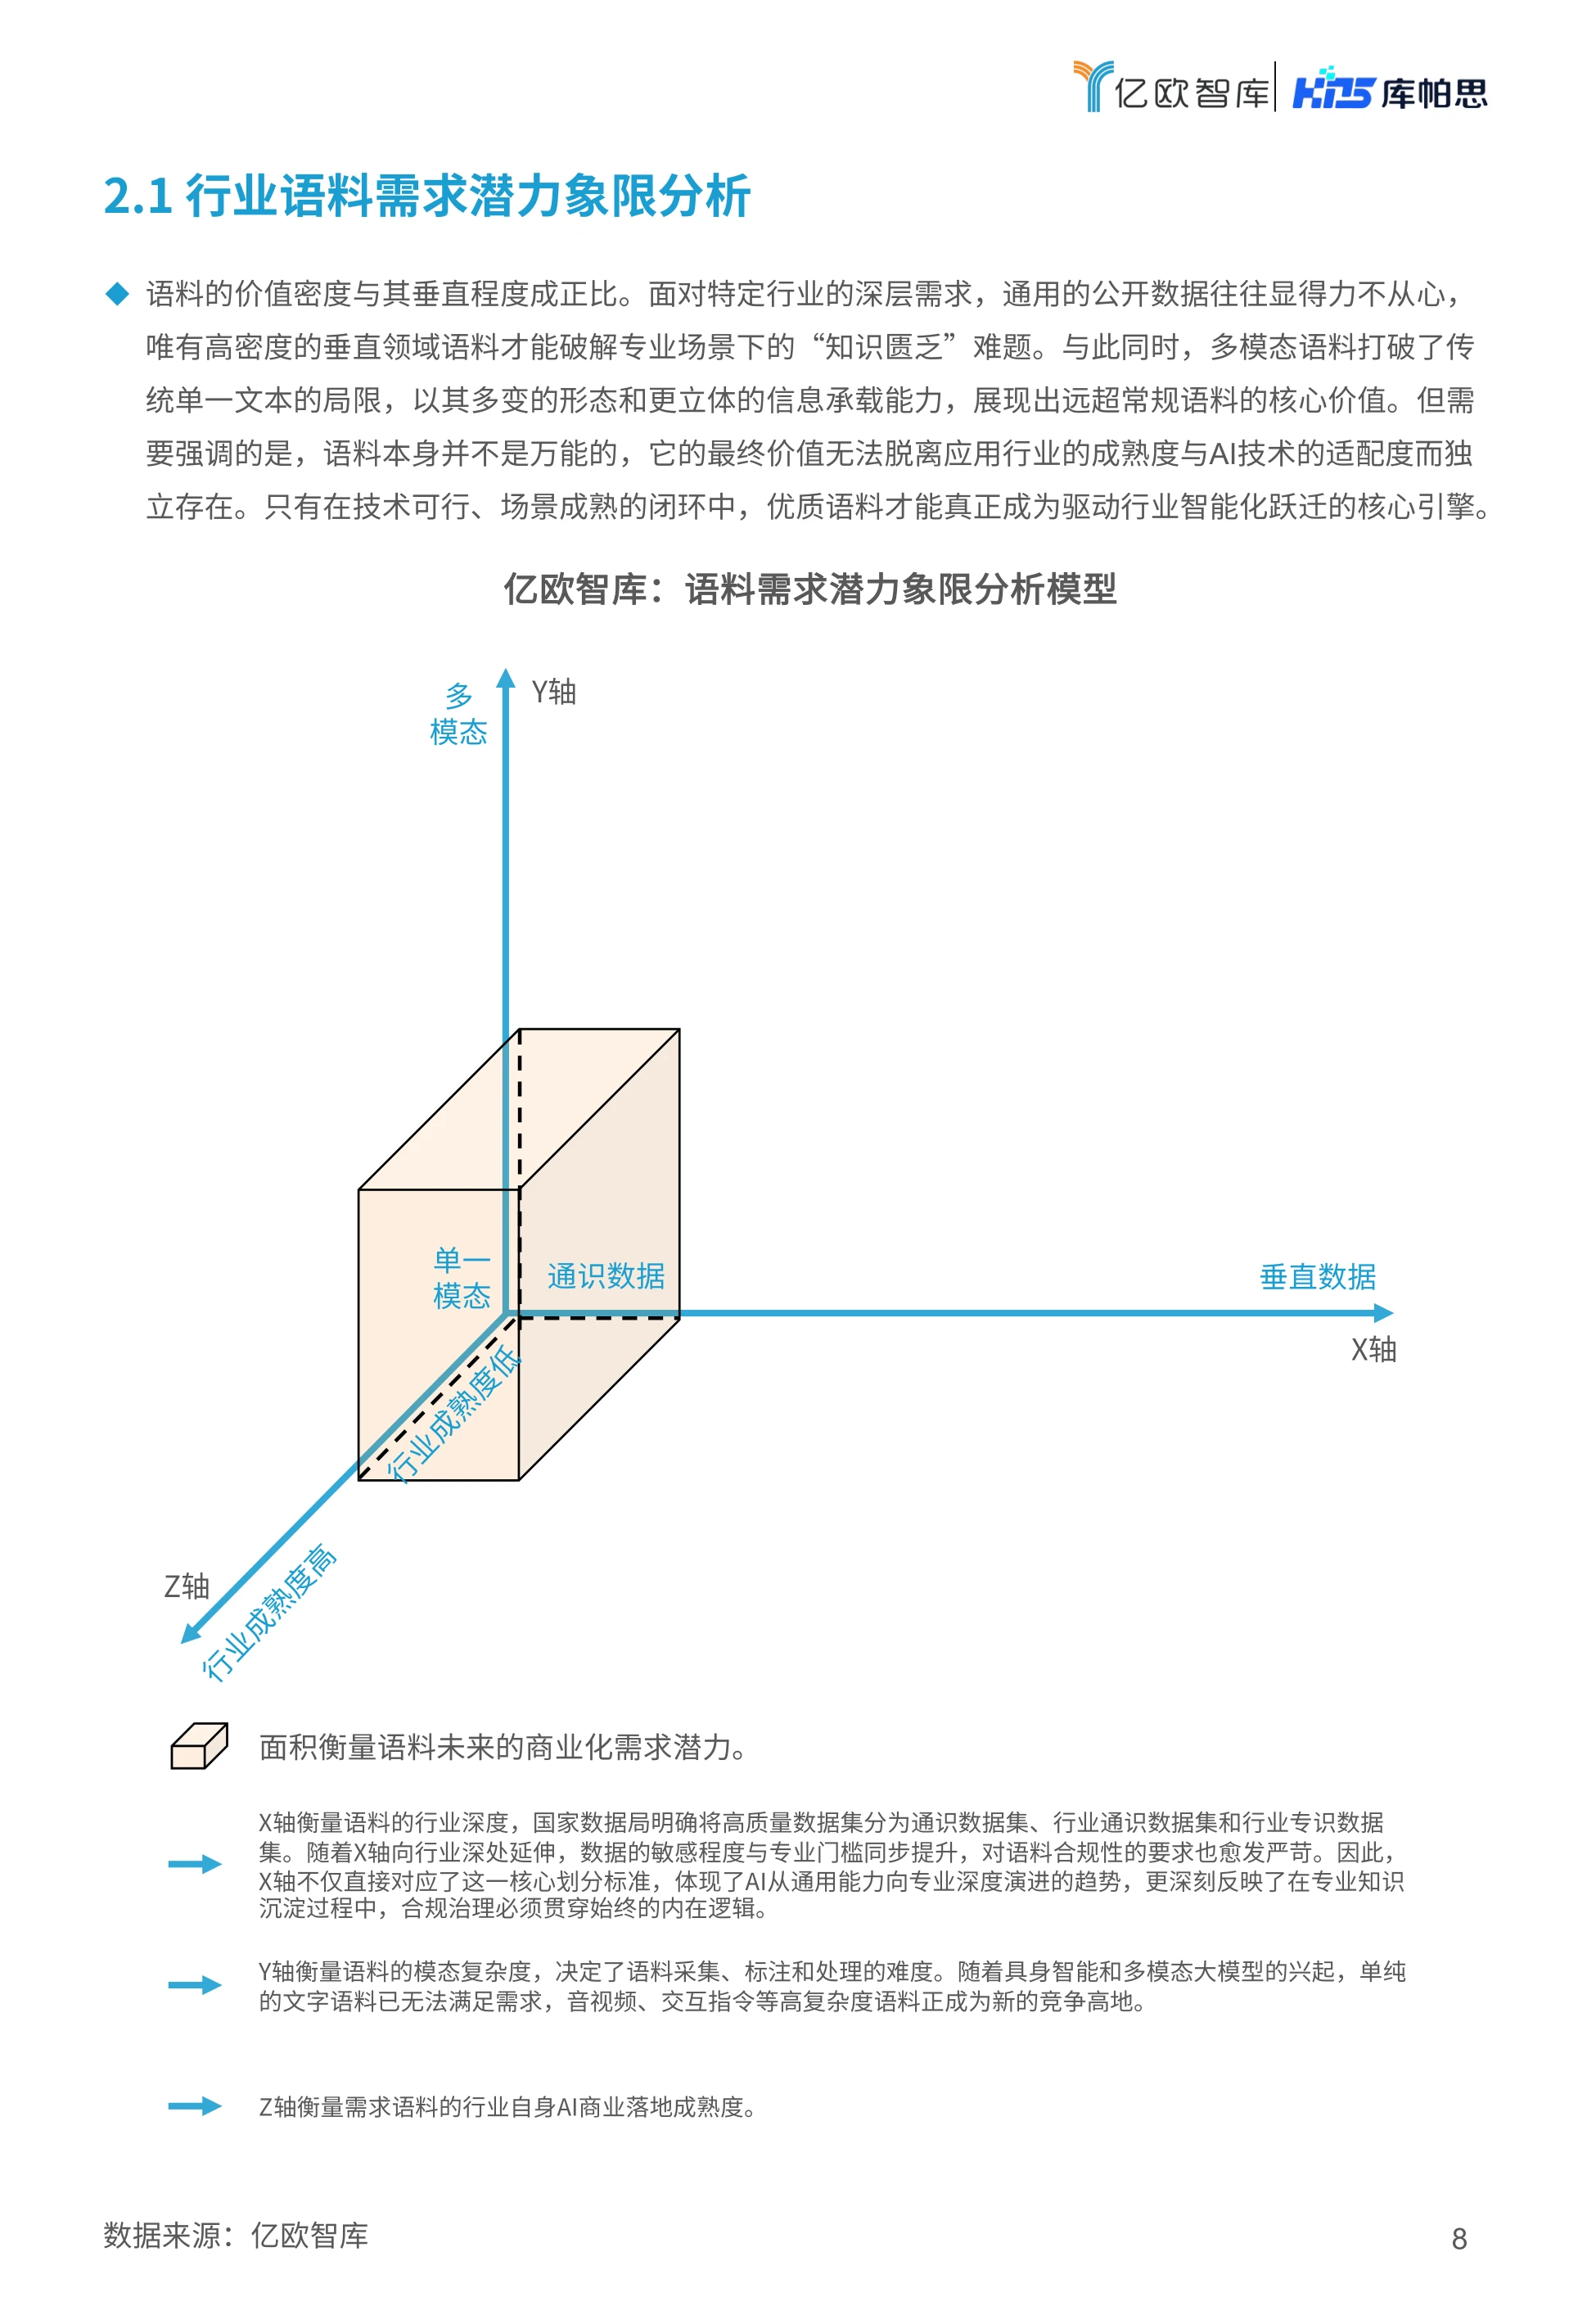
报告建了一个三维象限模型:X轴看行业深度,Y轴看模态复杂度,Z轴看行业自身AI商业落地成熟度,面积代表未来的商业化需求潜力。
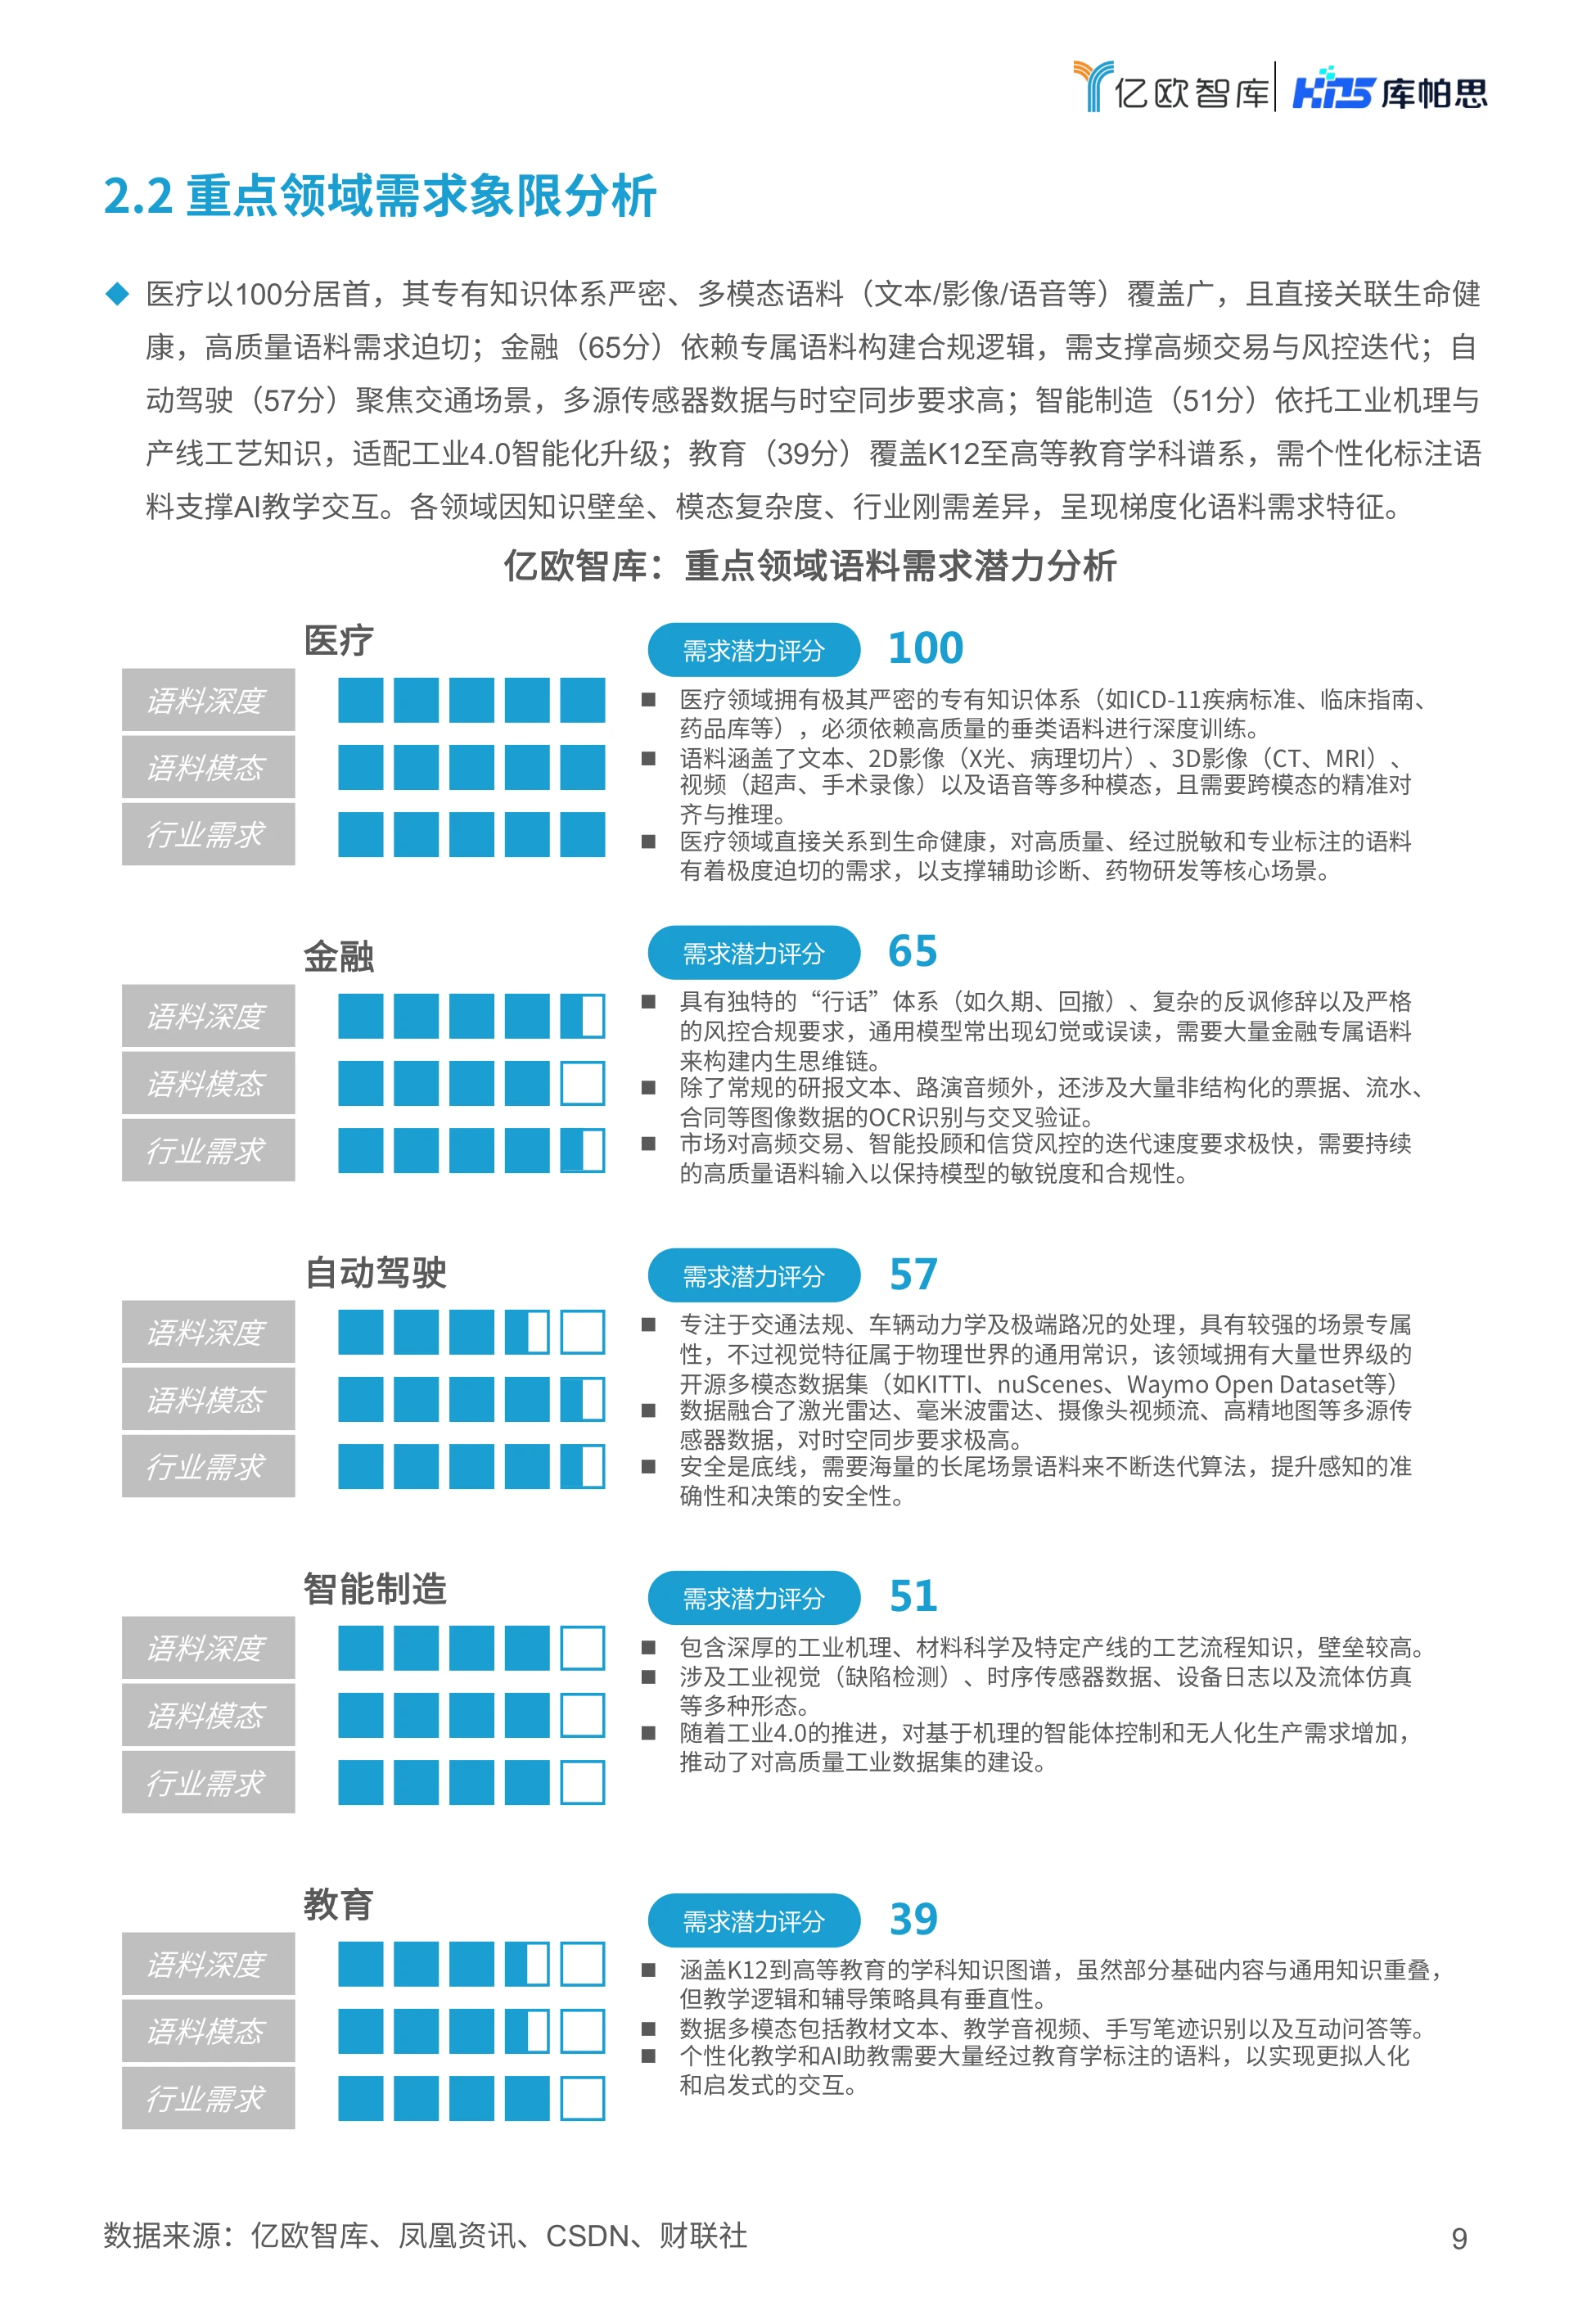
重点领域里医疗以100分居首,专有知识体系严密、多模态覆盖广,而且直接关系生命健康,需求最迫切。其后是金融65分、自动驾驶57分、智能制造51分、教育39分,梯度来自知识壁垒与模态复杂度的差异。
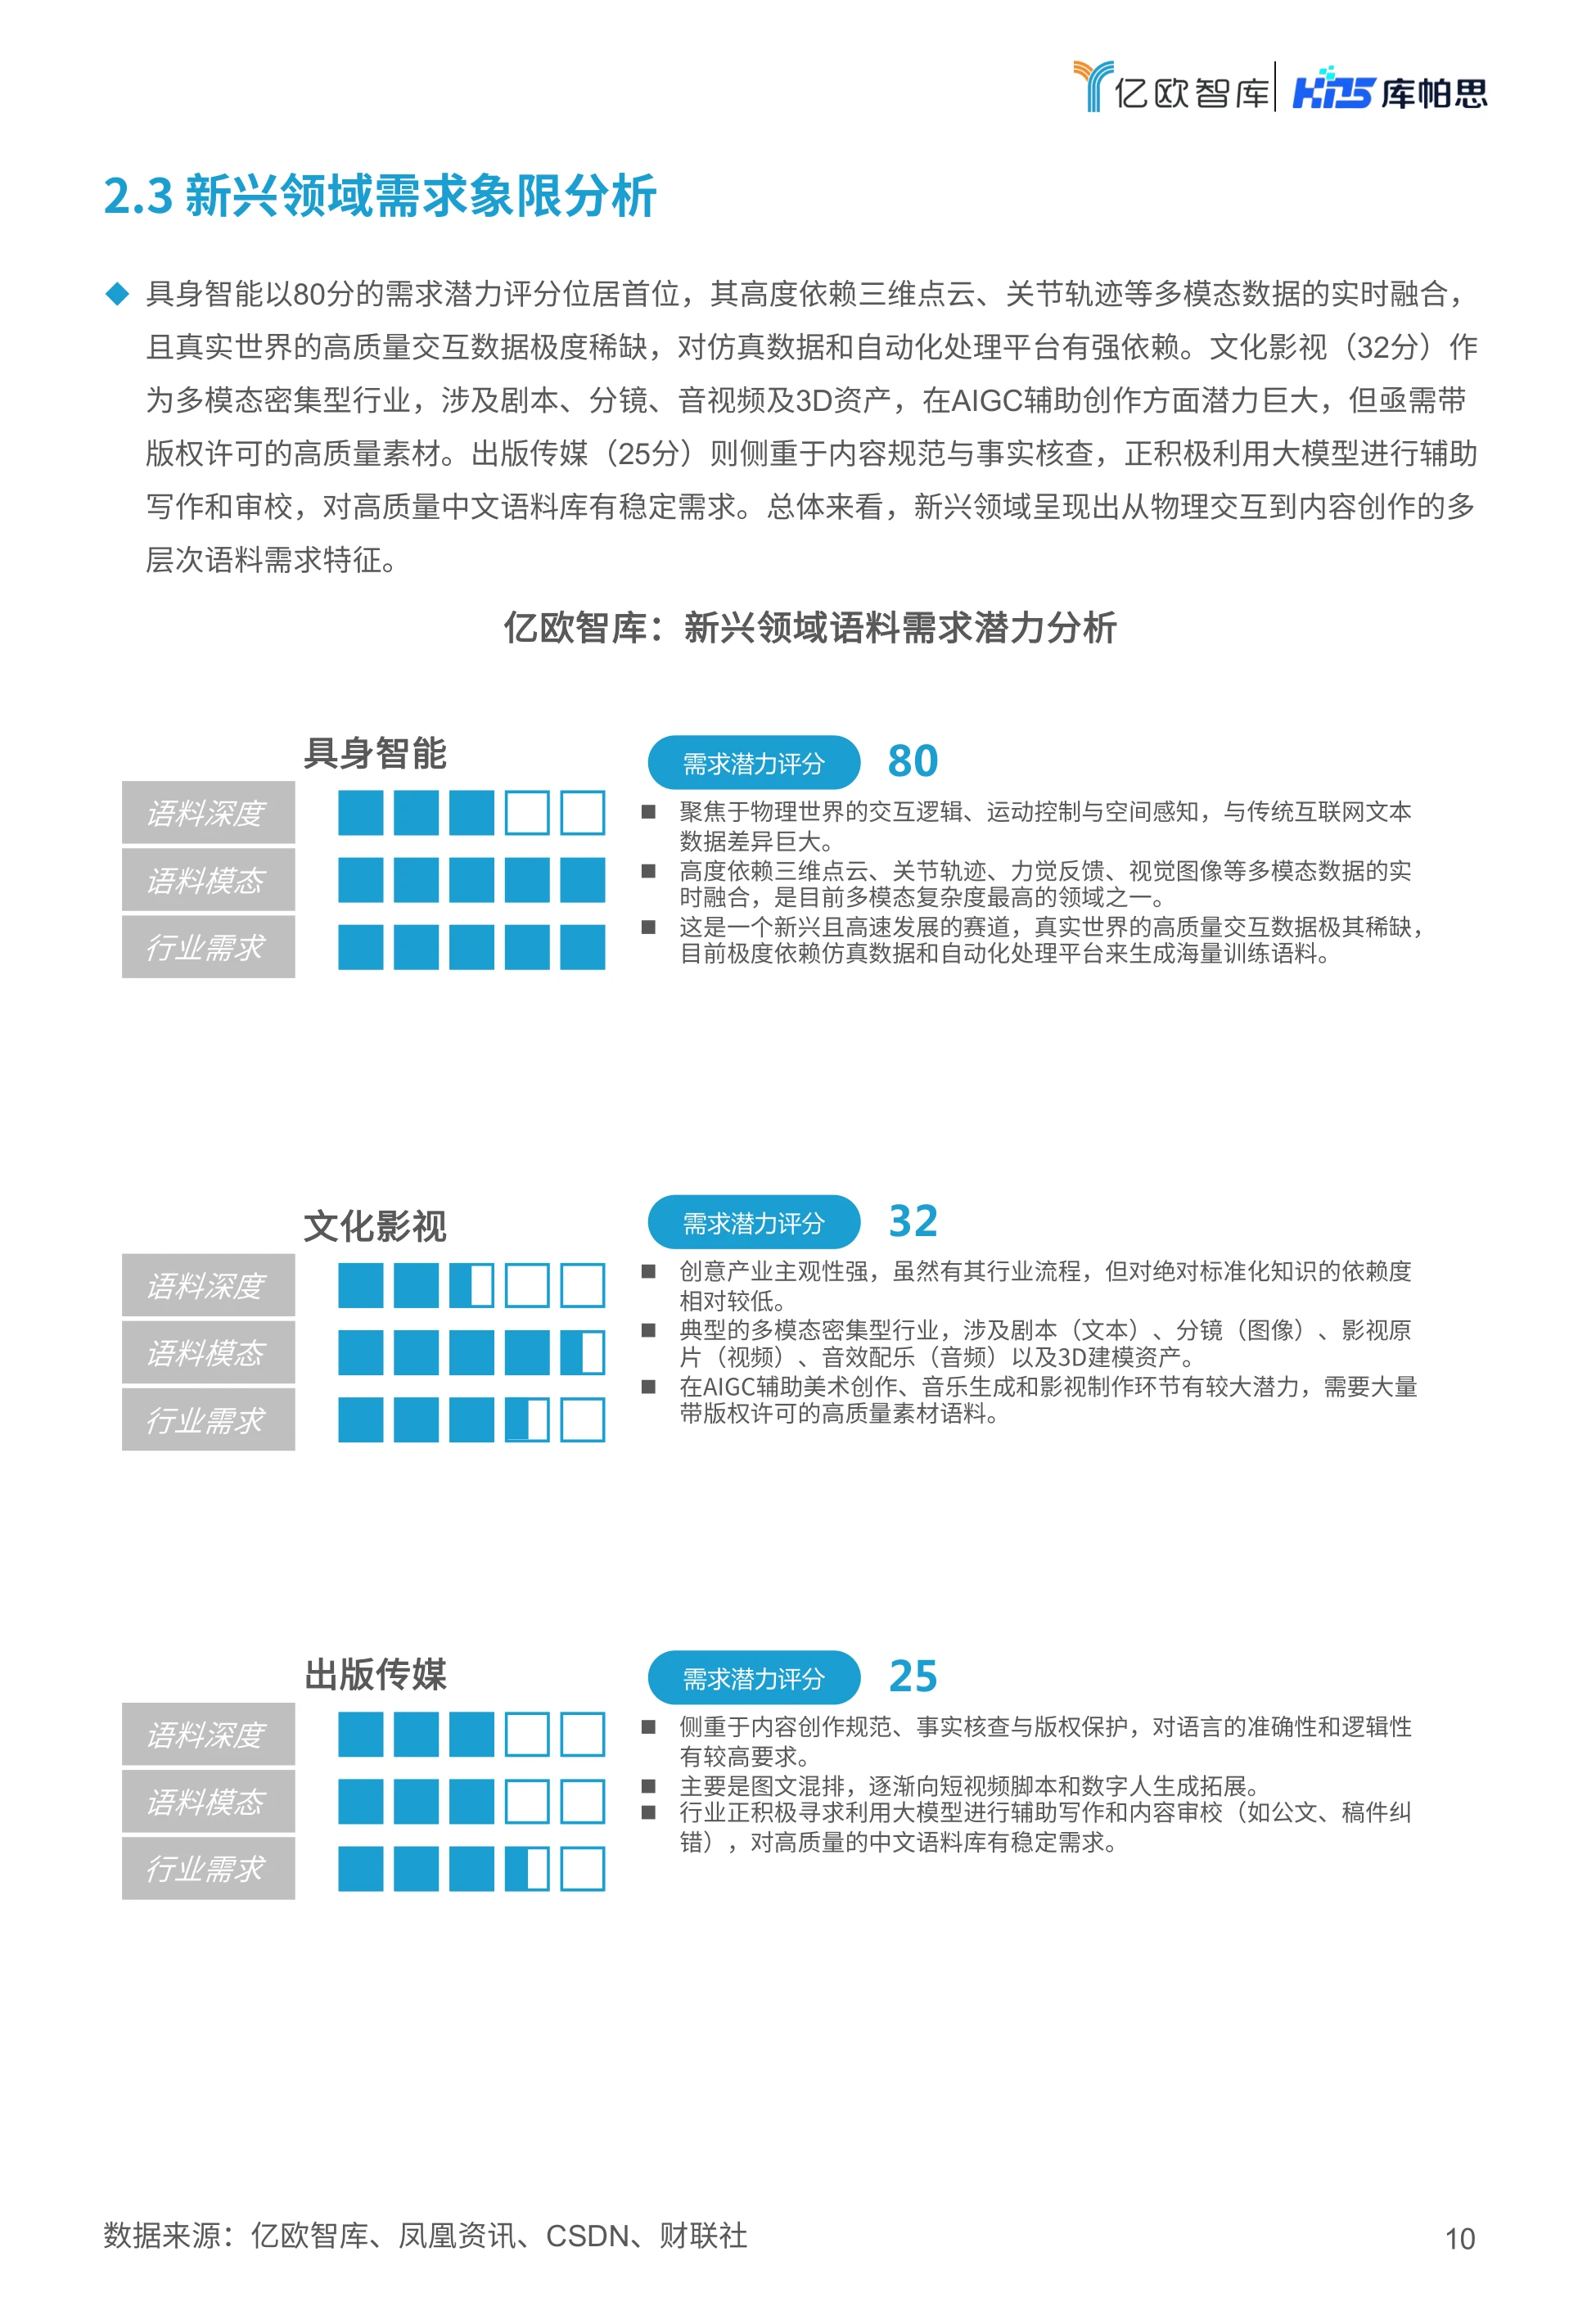
新兴领域里具身智能以80分排第一,高度依赖三维点云、关节轨迹的实时融合,真实世界的交互数据极度稀缺。文化影视32分、出版传媒25分,前者多模态程度高达9分,在视频生成等AIGC环节爆发力强,但缺带版权许可的素材。
评分不是行业热度榜,它衡量的是做语料的难度,以及这门生意能铺多宽。
分数高低说明的不是行业热度,而是这门语料生意的难度系数和天花板。
图源:《2026中国语料市场发展及榜单报告》(第8页)
六、三个梯队:第一梯队只有两个领域
报告按总分把八个领域分成三个梯队,梯队划分反映的其实是语料紧迫性与商业价值。第一梯队是医疗与具身智能,三项指标几乎没有短板,而且互相放大的效应极强。
第二梯队是金融、自动驾驶、智能制造,数字化基础好,需求务实,重点是把传感器数据、金融票据这类非结构化数据转成机器能理解的指令。
第三梯队是教育、文化影视、出版传媒,更依赖通用语言能力,但个别维度极强,比如文化影视的内容生产力,也是大模型最贴近普通用户的场景。
谁掌握了高门槛的垂直语料,谁就站在下一轮行业竞争的制高点上,难被替换。
图源:《2026中国语料市场发展及榜单报告》(第9页)
七、AI4S:决策式和生成式要的语料不是一回事
报告用了整整一页对比科研场景下的两类AI,因为它们的语料逻辑几乎相反。
同在一个科研场景里,决策式与生成式两类模型对语料的要求几乎相反。
决策式AI学条件概率分布,依赖强监督、高信噪比的金标准数据,痛点是样本少而特征维度高。它的范式是替代模型:把流体力学、量子化学这类昂贵仿真转成数据驱动预测,毫秒级完成原本需要超算数天的任务。
生成式AI学联合概率分布,能消化海量未标注文献,痛点是物理约束与有效性验证,容易产生科学幻觉。趋势上决策式AI会嵌入物理先验、走高质量小样本路线,生成式AI则靠合成数据与自动化实验形成数据飞轮。
一个要求“准”,一个要求“物理上合法”,两条路的语料加工方式因此分叉。
图源:《2026中国语料市场发展及榜单报告》(第10页)
八、语料风云榜:两个Top10是怎么评出来的
榜单在2026世界人工智能大会的语料专题论坛发布,主题是“语料筑基,智生时代”,设转型典范Top10与新锐势力Top10。流程分五步:5月21日至6月9日申报,6月10日至15日预选,6月16日至20日复评,7月15日至22日公示,7月27日颁奖。
评价体系是三级指标:经营能力、品牌能力、产品能力、创新能力、基础能力、规范能力六个一级指标,落到市场表现、语料库质量、专利与知识产权等二级指标。
转型典范名单里有国家管网、中国交通信息科技、上港集团、华建集团、上海赛西、上海市数字城市规划研究中心等。新锐势力名单包括谱蓝科技、飞数数据、数谱集团、临科智华、柏通数据、脉搏深处、快数智能等。
榜单排名不分先后,但从名单里能看出两条路线:行业龙头自建,创业公司代建。
这份报告的完整版、原始图表和数据附录,都放在运营动脉(www.yydm.cn)上,搜标题就能直接打开。
同类赛道的其他报告那里也都收了,顺着行业目录往下翻,比一份份到处找省事得多。
九、四个样本:从110条数据集到“1+4+X”
案例部分是这份报告里最实的部分,四个样本代表了四种不同的供给方式。
这四个案例的价值不在规模大小,而在它们把语料变成了可交付的产品。
国家管网的资源目录已梳理到110条数据集,覆盖规划、市场到回款、工程建设、生产运维等业务域,方法论是“归集-开发-反馈-迭代”。
上海量子城市做的是“1+4+X”:1套知识图谱分16个一级、54个二级、165个三级分类,4类核心语料成果,70余个专题库,检索召回率稳定在95%以上。
厦门供应链由3家世界500强企业联合组建,覆盖2.3万多家本地企业,走“数据供给-知识证据-企业应用”的五阶段路径。
企业侧,谱蓝科技2015年从地理信息标注起步,已沉淀1000TB自有数据集;脉搏深处2025年6月成立,在中山医院消化内科做出80例精选病例、15515个标准化实体的专病图谱,交付效率提升30倍。
语料生意的门槛,正在从“有没有数据”变成“能不能交付可核验、可追溯的知识”。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。