WorkBuddy进阶怎么用?懂5个原理,指令才不会白写
 广告
本文拆解:《2026WorkBuddy进阶手册-犀流沙》 · 共 480 页 · 原文
很多人用 WorkBuddy进阶 停在「会用」这一层:能问、能答、能出稿。但一遇到输出跑偏、格式不对、长文后半段崩掉,就开始怀疑模型不行。
有个判断值得先记住:80% 以上的输出问题是指令问题,不是模型问题。
为什么?因为指令有歧义时,模型的不同注意力头会「看到」不同的含义,输出自然偏离预期。要解决这件事,得先知道模型在底层是怎么处理的。
一、WorkBuddy进阶第一课:Token 是怎么算的
所有大模型 API 都按 Token 计费,上下文窗口也用 Token 计量。所以第一件要搞清的事就是 Token 是什么。
Token 不是字,也不是词,是模型切分文本的最小单位。「Hello, World!」会被拆成「Hello」「,」「World」「!」;
「你好世界」可能拆成「你好」「世界」,两到四个 Token 取决于模型。
关键发现有两条。
第一条,中文的 Token 效率比英文低约 30% 到 50%。同一内容的中文版本需要约英文版两倍的 Token。这意味着用中文对话比英文更贵,中文内容也更快消耗上下文窗口。
第二条,模型之间的差异不小。Qwen3 在中文脚本上做到约 0.3 Token 每字符,GPT-5.5 约 0.5,差出 40% 的成本。

来源:运营动脉文库《2026WorkBuddy进阶手册-犀流沙》
知道这两条,你就能算清每次调用的真实成本,而不是月底被账单吓一跳。
二、WorkBuddy的温度参数到底控制什么
第二个高频误区是把温度当成「聪明程度」的调节。它不控制能力,只控制随机性。
温度作用在 Softmax 之前,通过缩放 logits 改变概率分布形状:低温让分布更尖锐(更倾向选最高概率的词),高温让分布更平缓(给低概率词更多机会)。
另外两个参数也常用。Top-K 是固定保留概率最高的 K 个候选,缺点是不随置信度调整——模型很自信时 K=50 会引入大量噪声,模型不确定时 K=50 又会截断好选项。
Top-P 是保留最小候选集合,使其累计概率超过阈值 p,能自适应分布形状,所以成为多数生产系统的默认策略。
实操建议可以按任务直接套:
代码和事实性任务,温度 0.0 到 0.3、Top-P 0.9;日常聊天和内容 0.5 到 0.7、Top-P 0.9 到 0.95;
创意写作和头脑风暴 0.8 到 1.0、Top-P 0.95。
温度别超过 1.5,幻觉风险极高。还有一条经验:Claude 对温度不敏感,Gemini 对温度敏感。
调参的原则是从低温开始往上试。先设 0.0 看输出是否够用,不行再逐步调到 0.3、0.5、0.7,每次测 5 到 10 次,一旦出现幻觉或不稳定就退回上一个值。
这类拆解运营动脉(www.yydm.cn)上还有不少,站内 7 万+ 份方案、报告和课件,每月更新一千多份,搜关键词基本都能找到。
三、上下文越大越好?这是个代价很高的错觉
现在动辄百万 Token 的上下文窗口,很容易让人把所有资料都塞进去。但这里有三笔账要算。
第一笔是注意力质量。200K 的窗口不代表模型对 20 万个 Token 给予同等关注,对于超过约 5 万 Token 的文档,推理质量会下降。
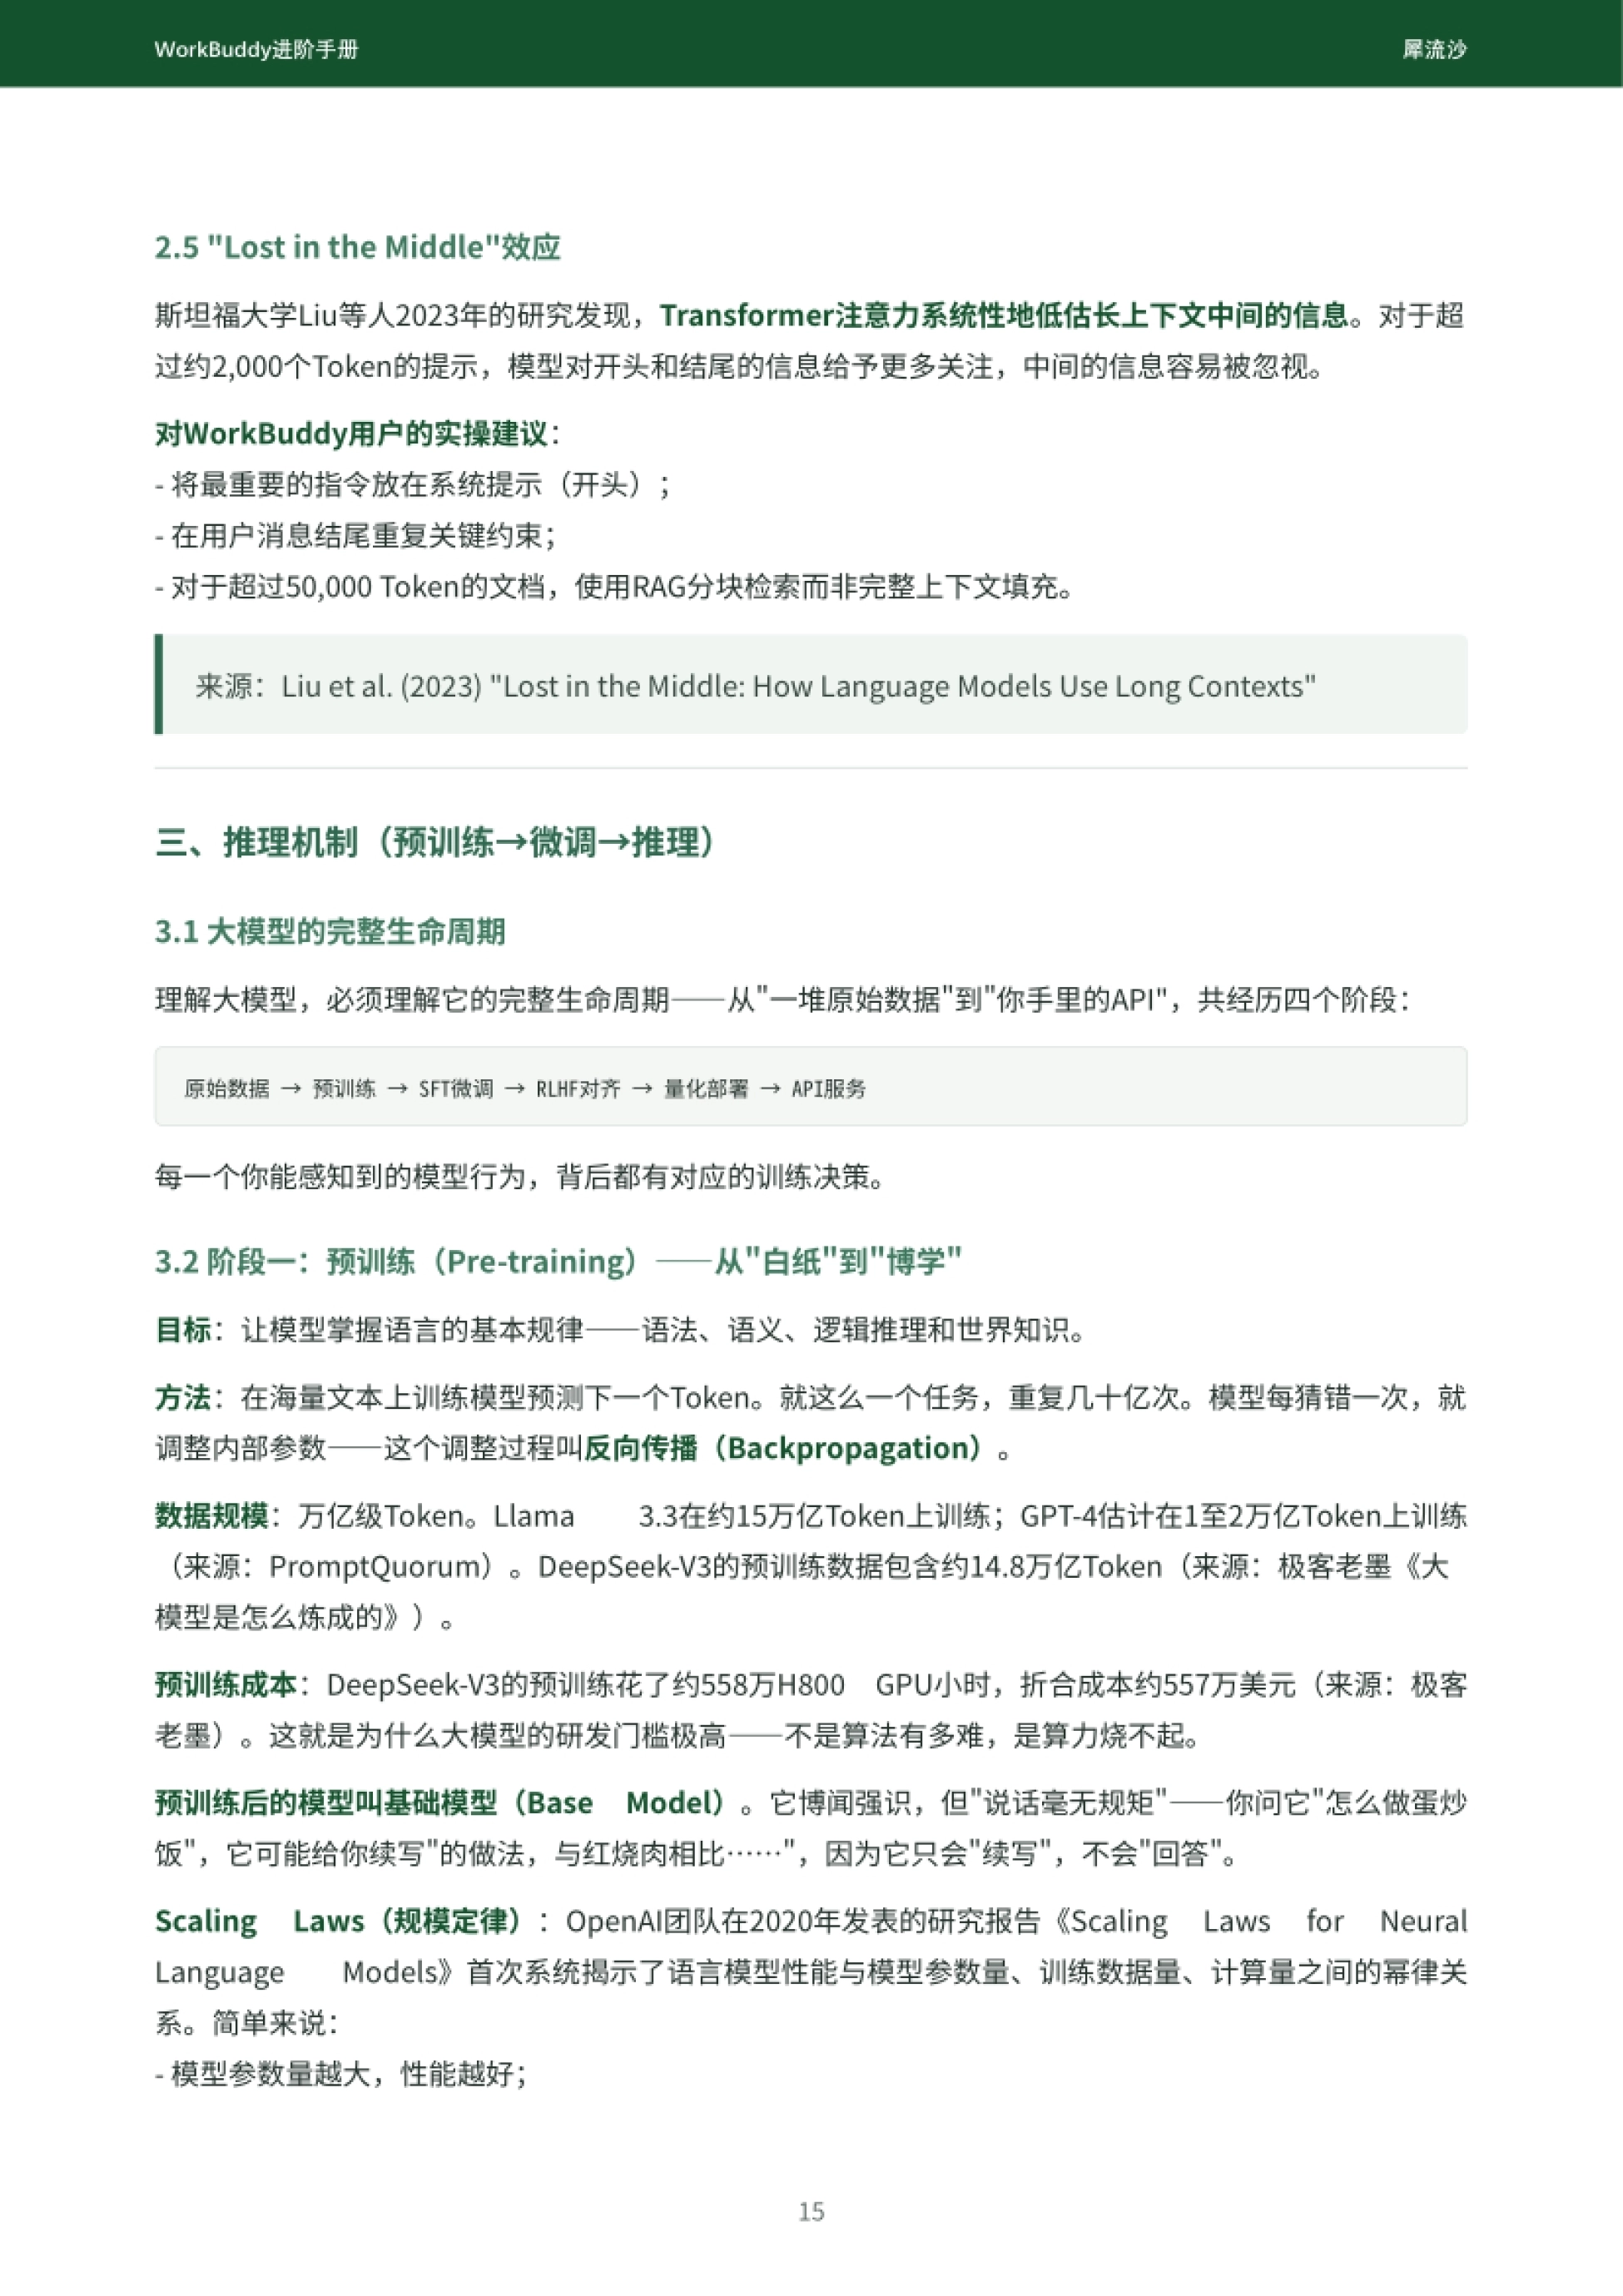
第二笔是「Lost in the Middle」效应。斯坦福 2023 年的研究发现,Transformer 注意力会系统性低估长上下文中间的信息。
对超过约 2000 Token 的提示,模型对开头和结尾关注更多,中间容易被忽视。
第三笔是计算成本。自注意力的复杂度是 O(n²),Token 数量翻倍、计算量翻四倍。
来源:运营动脉文库《2026WorkBuddy进阶手册-犀流沙》
对应的做法很具体:最重要的指令放开头(系统提示、角色定义、核心约束),次要上下文放中间,关键约束在结尾再重复一次。
文档按长度分档处理:1 万 Token 以内的直接贴;1 万到 5 万的分章节处理、提取关键信息再汇总;超过 5 万用 RAG 分块检索,别硬塞。
多轮对话每 10 到 15 轮做一次摘要,用摘要替代历史。
四、模型怎么选:四条判断就够了
选型的第一个原则是别听人推荐,按任务特征匹配。
代码和 Agent 场景首推 Claude Opus 4.7,它在 SWE-bench 上达到 64.3%,缺点是价格昂贵、多模态能力弱于 Gemini。
数学推理看 DeepSeek V4-Pro,MATH-500 上 96.8%,性价比高、支持私有化部署,代价是日常对话体验一般、响应较慢。
中文场景看 GLM-5.1 和 Qwen3-Max,两者在 SuperCLUE 中文评测中都超过 71.5 分。
长文档和日常开发看 GPT-5.5,综合能力第一、生态最完善,但国内访问受限、有数据隐私风险。
选之前先过四个约束:数据是否必须留境内(要就选国产)、是否要私有化部署(要就选开源的 DeepSeek 或 GLM)、预算多少、是否需要实时响应。
选完一定要用真实任务验证:测试 5 到 10 次看准确性,看相同输入的输出是否稳定,看 Token 消耗是否在预算内,看响应时间是否达标。不满意就换一个再试。
五、长文后半段崩掉,是自回归的必然
这条能解释很多「明明前面写得挺好,后面就跑偏」的情况。
模型是自回归生成的:每一步只预测下一个 Token,没有全局规划。所以写长文时它并不知道全文该往哪走,只能一步步往下接。
解决办法是在指令里提前给出结构框架。先让模型把提纲列出来、确认之后再逐节展开,比一次性要它写完整篇稳得多。
另外两个相关的现象也值得知道。模型会「一本正经地胡说八道」,因为它的目标是生成「看起来最可能的」文本,而不是「事实正确的」文本。
模型也无法可靠地做字符计数,因为 Token 边界是子词单元,精确计数不是它的原生能力。
还有个常被忽略的细节:模型不知道今天的日期。该在系统提示里插入当前日期。
六、五条检查清单,写完指令过一遍
把这些原理落成可执行的动作,就是下面五条。
指令自查:消除歧义(不说「帮我处理一下」,说「把这批 JSON 转成 CSV」)、给出 1 到 2 个输入输出示例、把隐含约束显式写出来、关键任务必须验证输出。
Token 自查:设置 max_tokens 避免输出过长、超过 10 轮对话就做摘要、系统提示保持精简。
温度自查:先确认任务类型、从低温调起、大多数任务设 Top-P 0.9 到 0.95、不同时设 Top-K 和 Top-P、不把温度当智商旋钮。
上下文自查:算清可用 Token(窗口减去系统提示再减预期输出)、关键指令放开头、关键约束在结尾重复、不在一个对话里混多个项目。
选型自查:确认是否需境内合规、是否需私有化、预算档位、延迟要求。
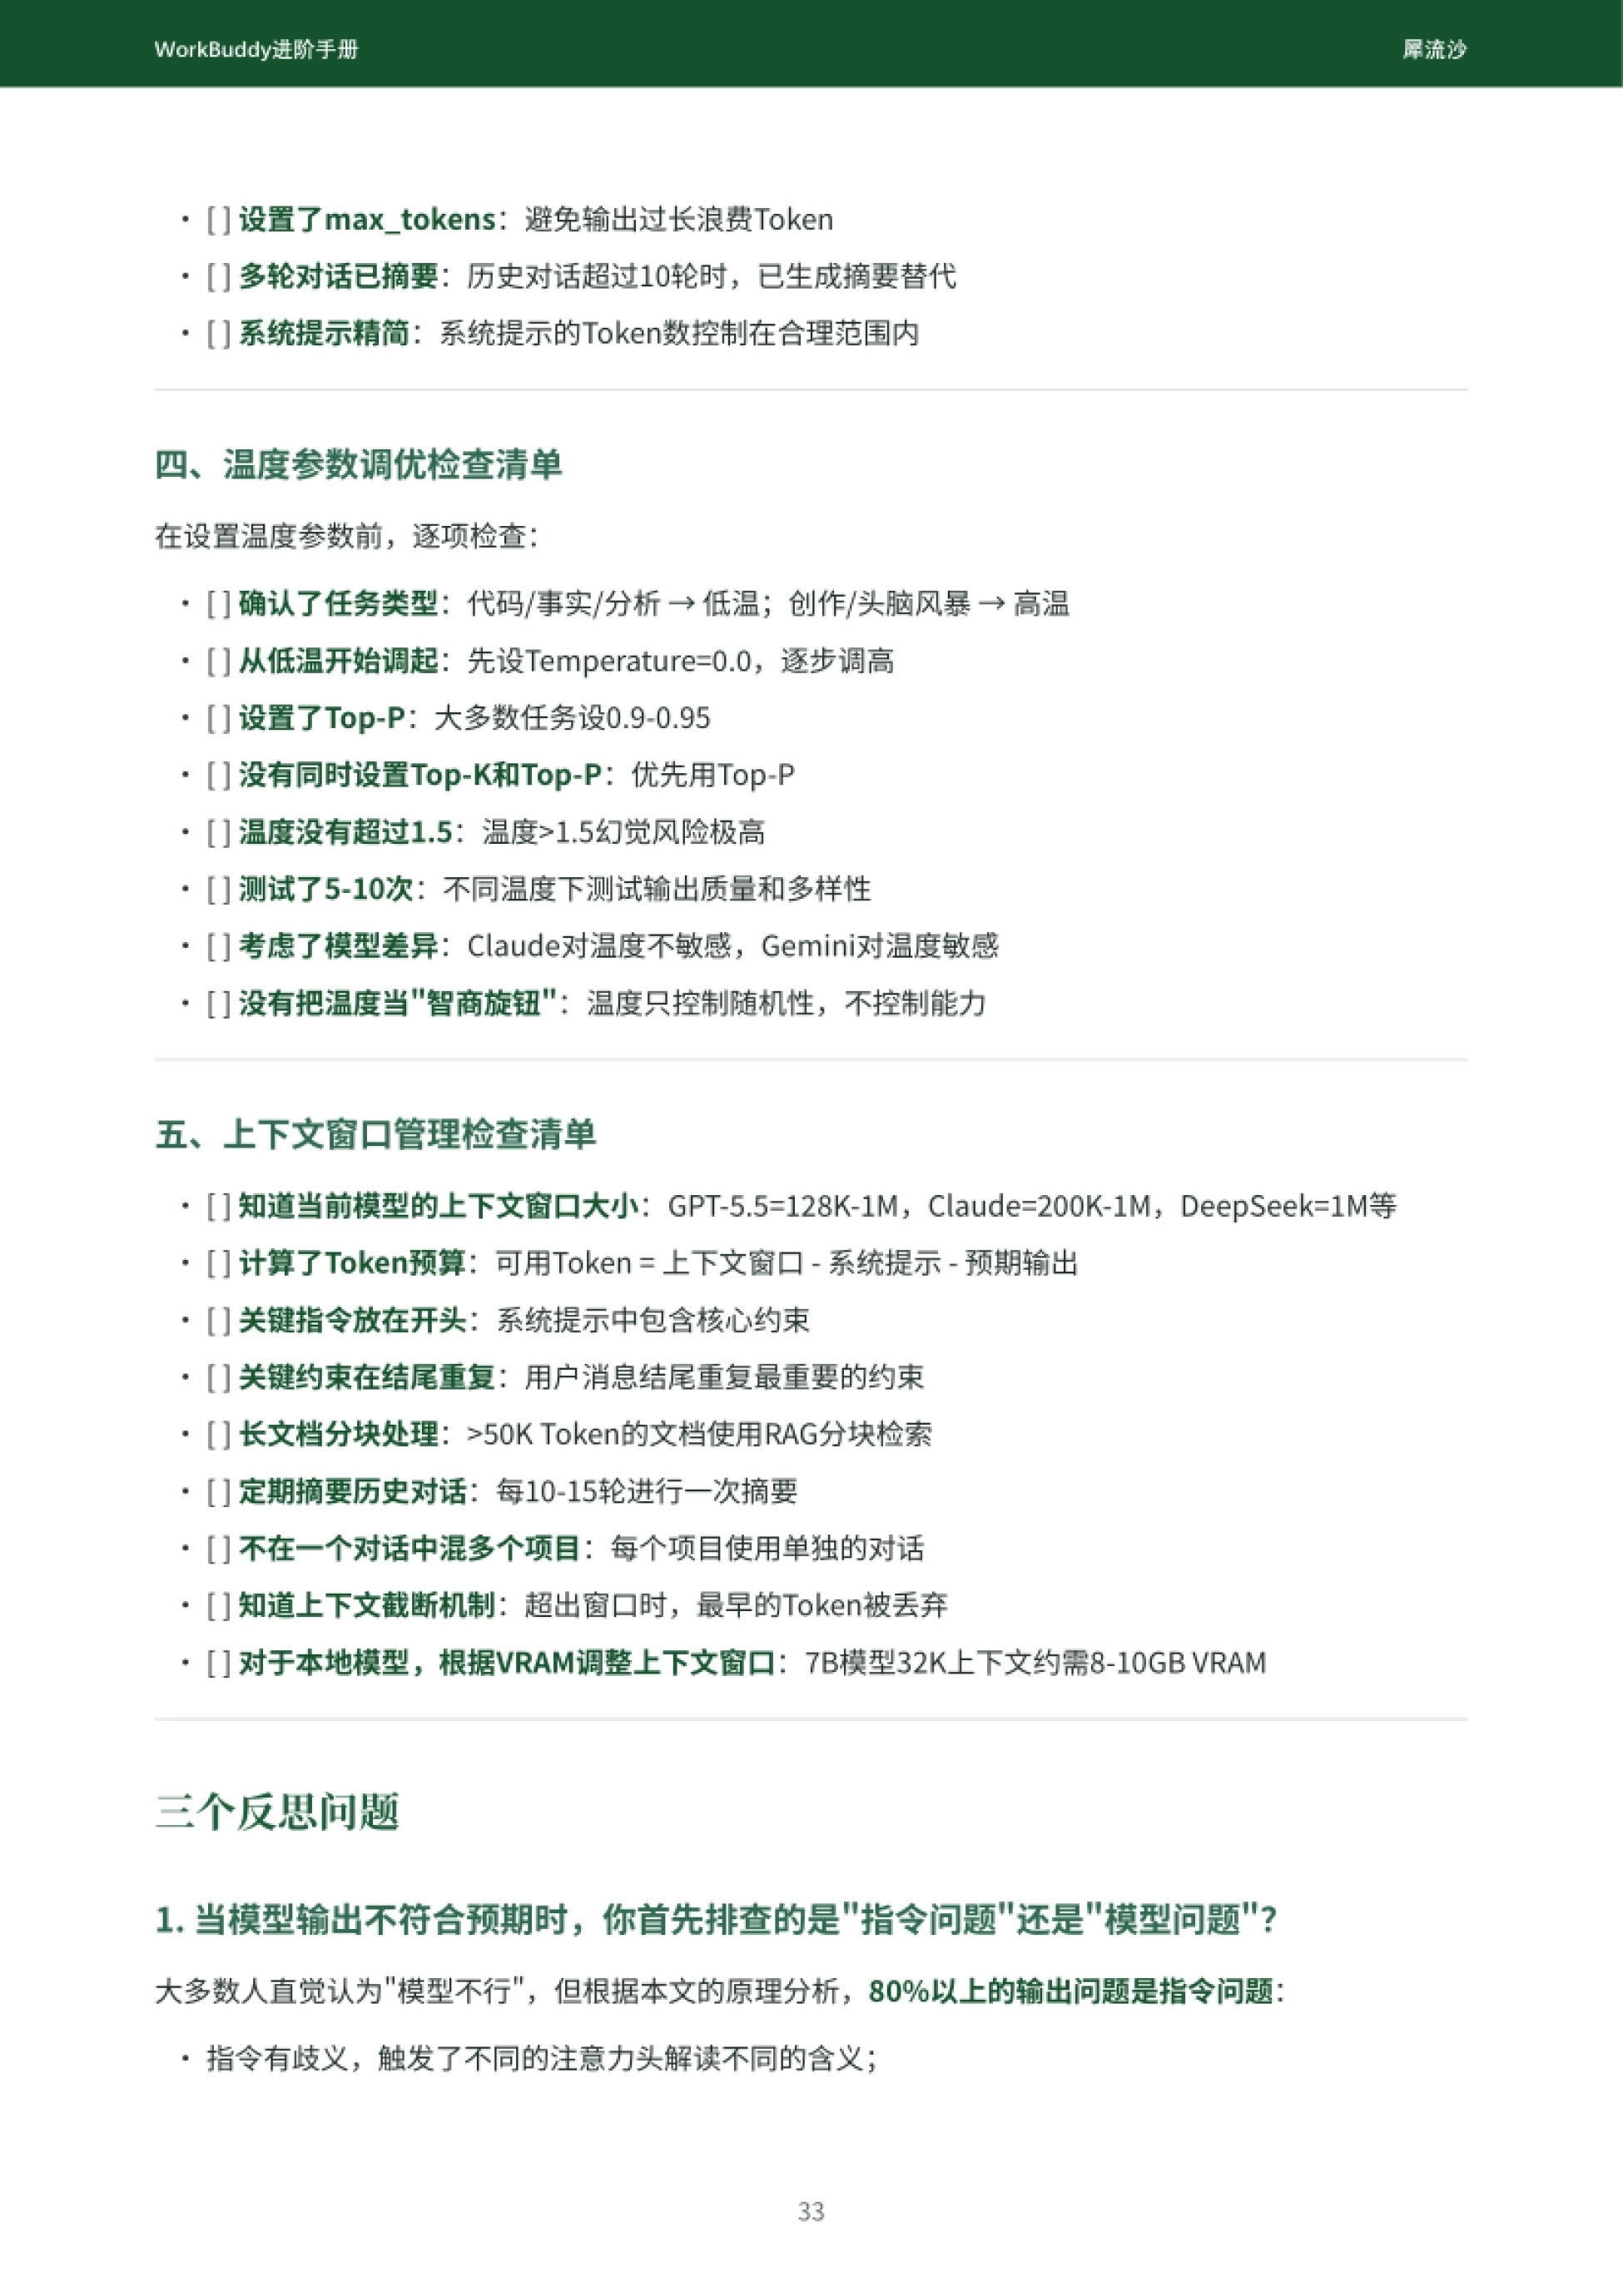
来源:运营动脉文库《2026WorkBuddy进阶手册-犀流沙》
最后留一个反思问题:当输出不符合预期时,你首先排查的是「指令问题」还是「模型问题」?
如果答案总是后者,那大概率的真实情况是前者。懂原理的意义,就是把「和 AI 猜谜」变成「和 AI 下棋」——你知道它每一步是怎么走的,才知道该怎么出招。
如果你想把完整的原理章节、各模型的参数对照表、以及五份检查清单的原文找出来对照着用,运营动脉文库收录了这份手册的完整版,可以找来看原文。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。