智能体时代AI基础设施:2185EFLOPS与推理占80%
 广告
这份《智能体时代AI基础设施发展研究报告(2026)》由中国电信研究院天翼智库发布,共72页,编制时间为2026年9月。
报告要回答的问题很直接:当AI从"聊天"走向"干活",底层基础设施要被改成什么样?
它给出的判断是,AI基础设施的竞争焦点已经变了。过去比的是"算力"和"模型"两个单项,现在比的是"算力—模型—智能体—应用"的系统性全栈布局。
三组数字可以先立住框架。截至2026年6月底,我国智能算力规模达2185EFLOPS,同比增长177%;全球活跃智能体数量预计2030年达22.16亿个,2025—2030年复合增速139%;预计2029年我国推理算力市场占比将达80%。
报告最有价值的部分,是它把"智能体"当成一个会反向改造基础设施的变量。
传统云负载的资源曲线是平的,智能体的资源曲线是尖的——内存峰值可达平均值的15.4倍,CPU利用率在13%到175%之间波动。
这意味着按传统云思路建的资源池,在智能体场景下要么浪费、要么不够用,架构必须重做。
这才是"智能体重塑基础设施"的真实含义。
一、全球政策焦点:主权AI与资本加码
报告开篇盘点了主要经济体的AI政策走向。
一个共同变化是:政策焦点从"发展AI应用"转向"建设主权AI基础设施"。
美国走的是规则管控路线。2026年2月,美国国家标准与技术研究院发布《AI智能体标准倡议》,制定自主智能体的互操作性、安全边界、身份认证等标准。
3月,众议院推动《芯片安全法案》,建立高端芯片全生命周期溯源机制;随后又出台《远程访问安全法案》《云安全法案》。
要注意后两个法案的意义:管制范围从实体硬件延伸到了云端,目的是封堵通过云服务获取先进算力的渠道。
6月,美国总统签署行政令,要求前沿AI模型发布前向政府开放最长30天的网络安全测试窗口。
欧盟走的是"规则+产业"双线。6月发布《技术主权一揽子方案》,首次把云、AI、芯片、软件、能源设为独立政策框架。
7月,欧盟发起"AI超级工厂"建设招标,计划设立最多7个AI超级工厂,覆盖高端AI芯片、配套软件与云架构、高速互联网络、绿色节能数据中心。
日韩则是重资产攻坚。日本由软银、日本电气、本田、索尼等4家财团成立"日本AI基础模型开发公司",主导1万亿日元国家级AI计划。
韩国1月公布《国家AI战略》,2026年AI年度预算提升至10万亿韩元,计划撬动公私合计30万亿韩元投资。
到6月,韩国进一步确立半导体、物理AI、AI数据中心三大支柱,三星电子与SK集团本土合计投资规模达4700万亿韩元。
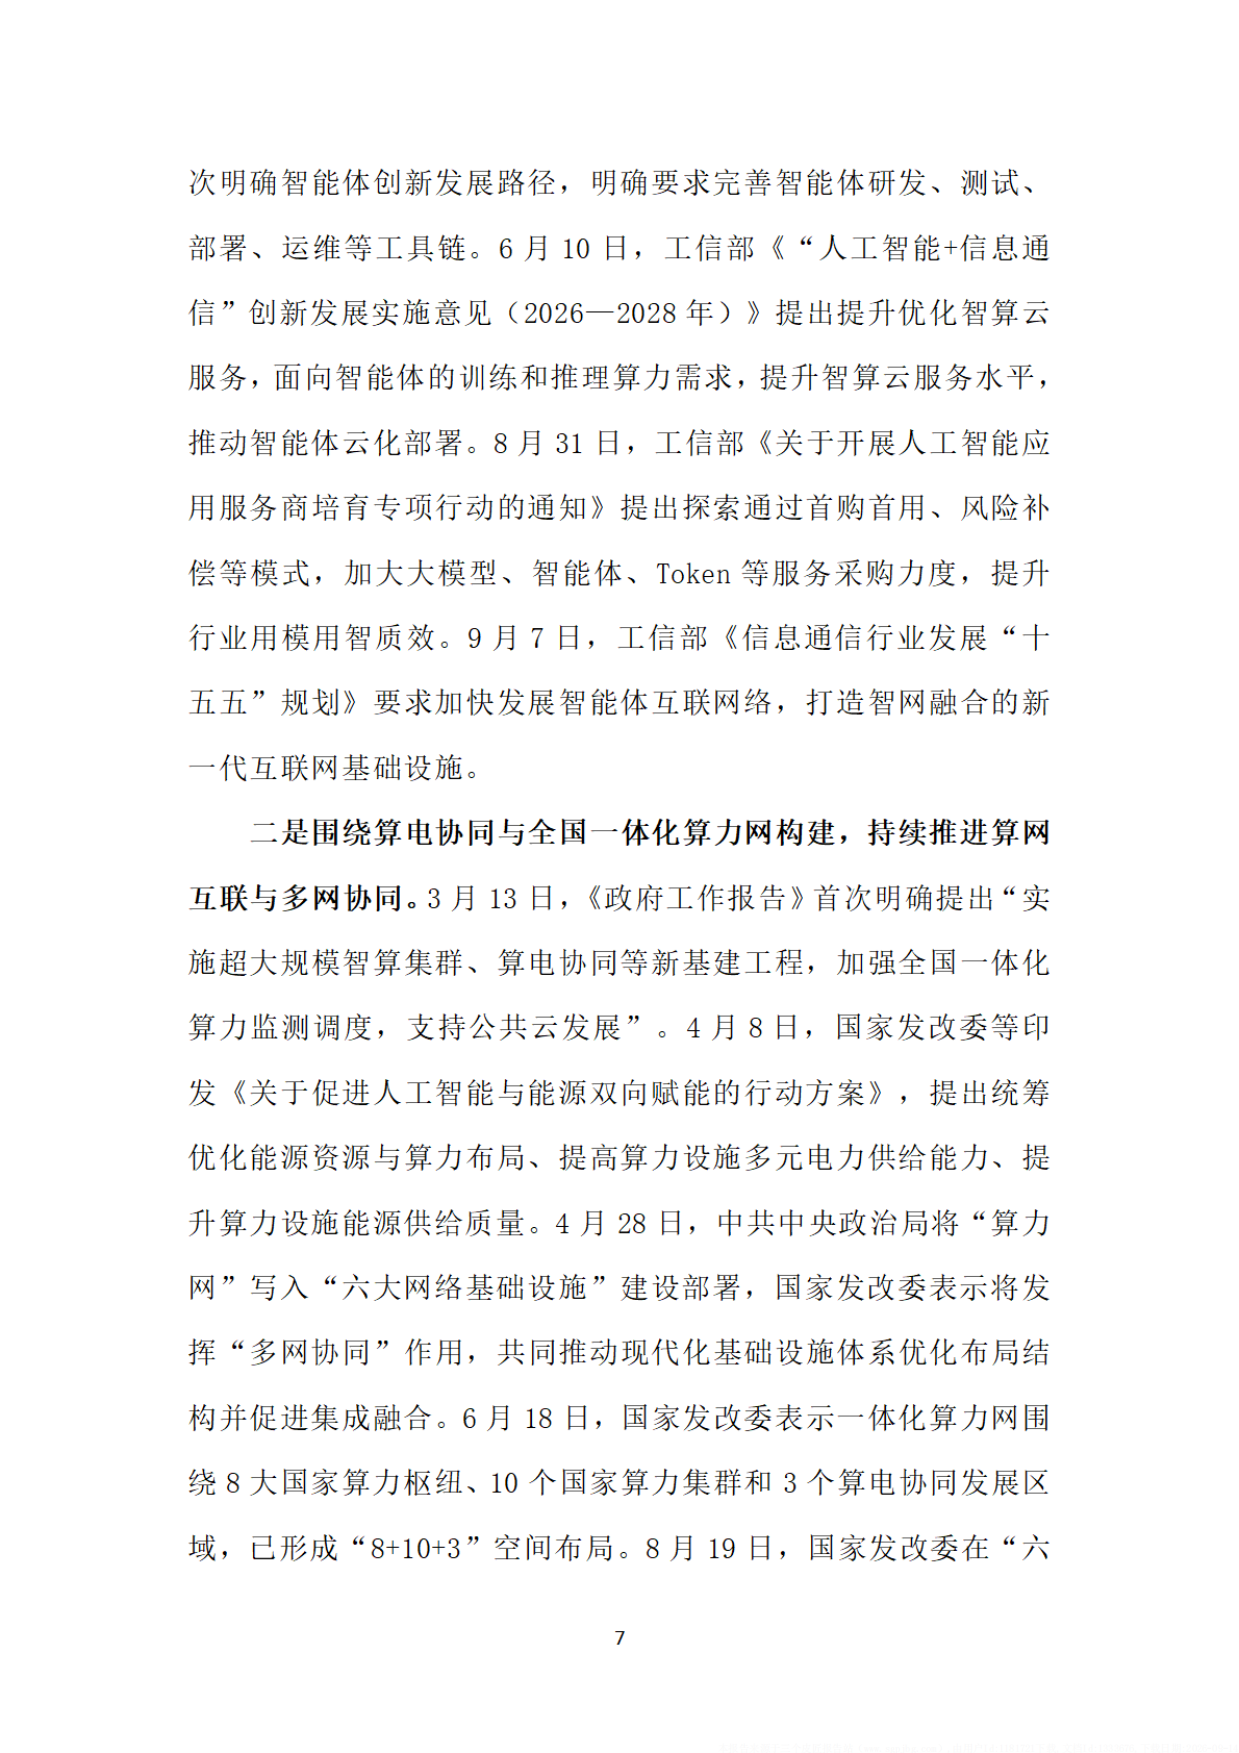
我国的路径是"以应用牵引基础设施"。报告认为,我国以智能体应用为抓手,同步升级算力基础设施的能力与服务水平。
这份政策盘点里最值得琢磨的是中美欧的分歧点。
美国用出口管制和测试窗口把风险挡在外面,欧盟用规则和补贴把能力建在里面,日韩直接砸重资产抢产能。
三条路都指向同一个结论——AI基础设施已经不是纯商业投资,而是被当作战略资产来配置。
对企业来说,这意味着供应链的"可获得性"会越来越受政策影响,选型时不能只看性能和价格。
二、需求侧:Agentic AI 把Token需求推上台阶
第二章讲需求,核心变量是AI从"生成式"迈入"代理式"。
报告把这轮跃迁称为Agentic AI阶段。区别在于,生成式AI输出的是内容,代理式AI输出的是任务结果。
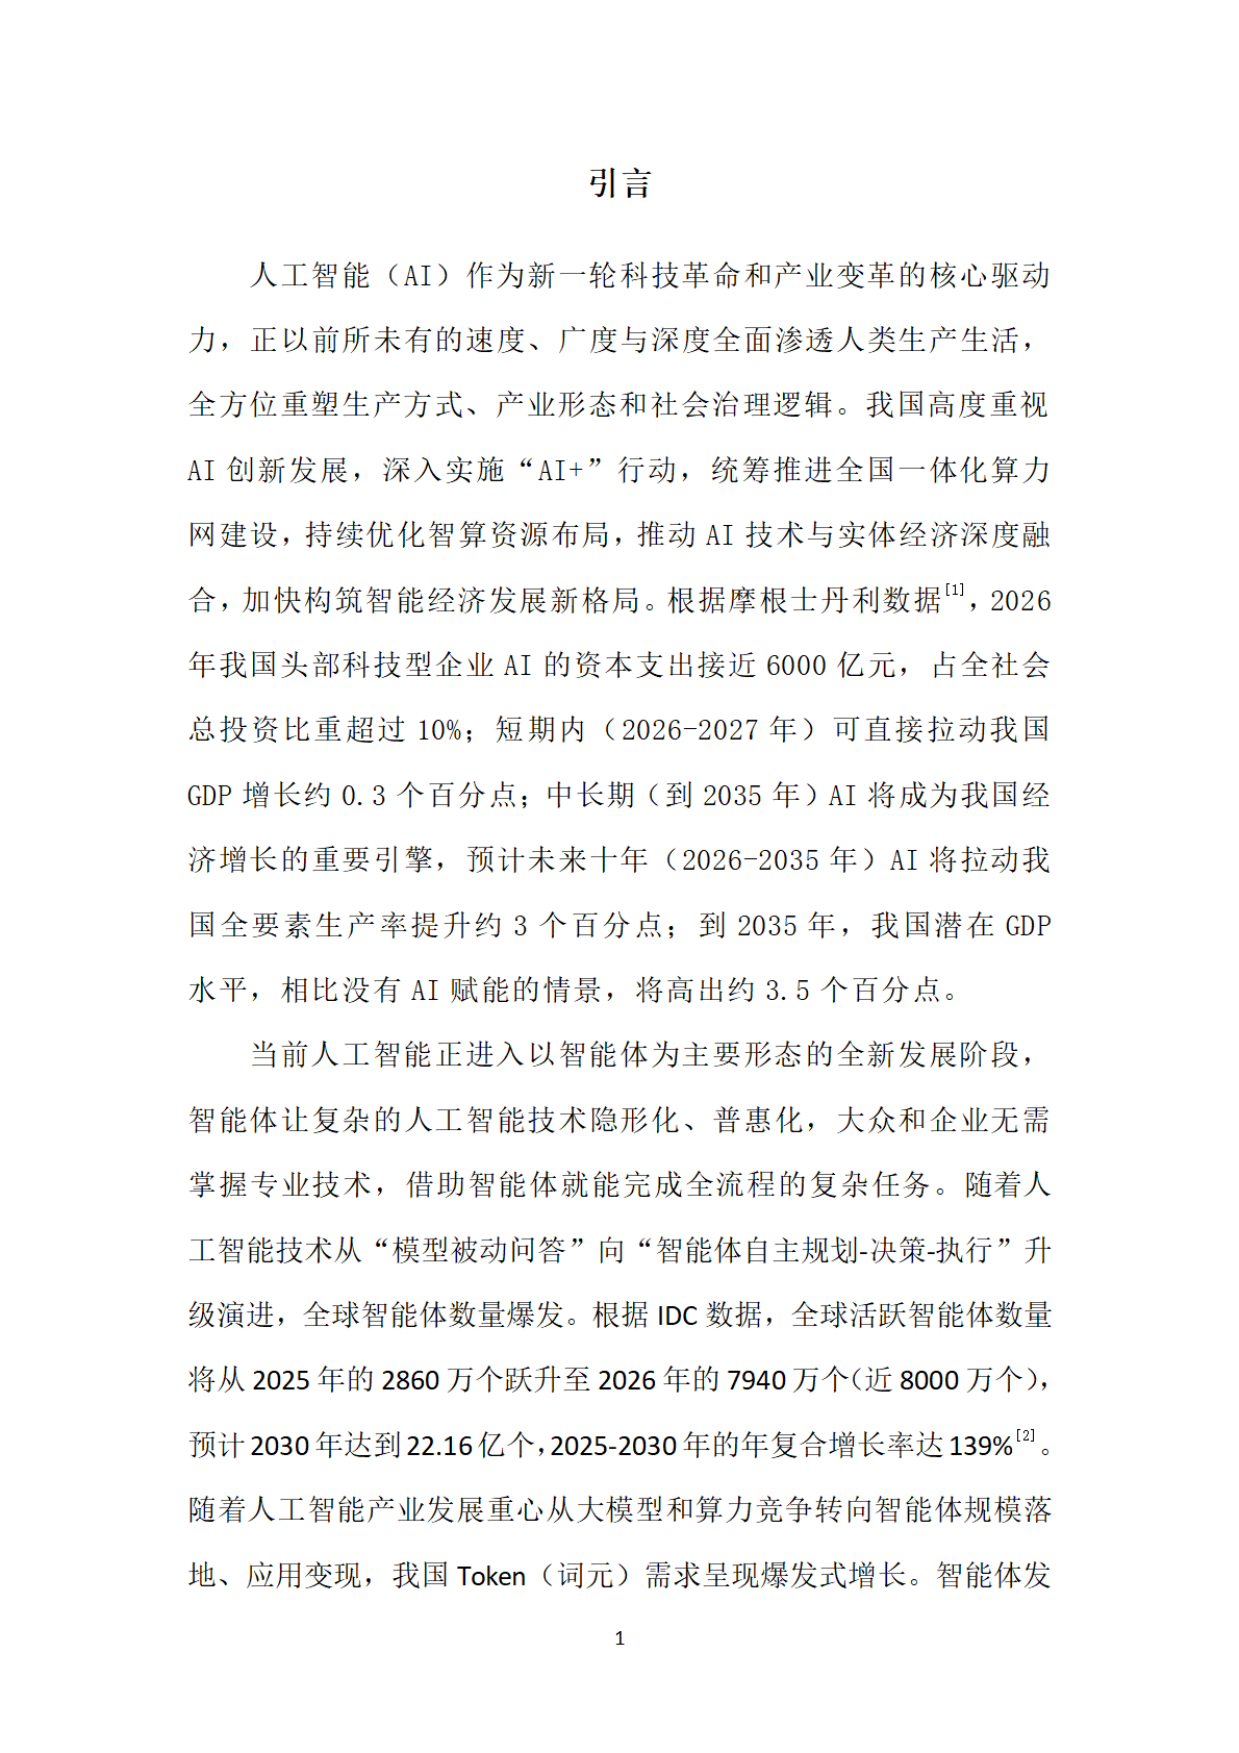
任务的算力消耗量级完全不同。据IDC数据,全球活跃智能体数量2030年将达22.16亿个,2025—2030年复合增长率139%。
需求量怎么体现?看Token。
报告引摩根士丹利数据,2026年我国头部科技型企业AI资本支出接近6000亿元,占全社会总投资比重超过10%。
宏观拉动上,报告给出两段测算:短期内(2026—2027年)可直接拉动GDP增长约0.3个百分点;到2035年,我国潜在GDP水平相比没有AI赋能的情景将高出约3.5个百分点。
未来十年,AI预计拉动我国全要素生产率提升约3个百分点。
需求结构上,报告给了一个明确判断:推理算力需求将远超训练算力,预计2029年我国推理算力市场占比达到80%。
另一个被单独提出的场景是AI Coding。IDC数据显示,2025年中国AI编程市场规模为3.99亿元,预计2026年底增至11.73亿元,增长约194%。
其中阿里Qoder以47.6%的份额居首。全球市场同步加速,OpenAI Codex周活跃用户已超400万。
推理占比到80%这个判断,会直接改写硬件采购清单。
训练看重的是峰值算力和互联带宽,推理看重的是每瓦吞吐和单Token成本——两者的最优解不是同一套配置。
报告后面提到英伟达新平台每瓦推理吞吐提升10倍、单Token成本降至1/10,正是冲着这个结构变化去的。
谁先按"推理为主"重构资源池,谁的长期成本曲线就更好看。
三、云与市场:竞争转向全栈,空间有多大
第三章把市场盘子摆出来,并解释竞争格局的变化。
先看全球。据Synergy Research Group数据,2026年第一季度企业云基础设施服务支出达1290亿美元,同比增速35%,已连续第九个季度上升。
高盛预测,全球AI基础设施(含计算、数据中心及电力投资)2026—2031年累计投入将达7.6万亿美元,其中2026年支出约7650亿美元。如果你关心的正是IDC高通白皮书,《IDC高通白皮书:AI终端渗透率74%》值得一起读。
再看国内。IDC数据显示,我国公有云IaaS市场同比增速恢复至20.0%,公有云整体市场2025下半年总值突破2000亿元。
其中GPU、MaaS等AI相关领域贡献显著提升。
更值得关注的是生成式AI的I+M(Infrastructure+MaaS)市场:报告预计2029年底规模达2180亿元,年复合增长率72%。
这个市场在公有云中的占比也在快速抬升,从6%升至39%。
同一条线索,我们在《浙商证券《2026国产GPU芯片行业深度》》里做过更细的拆解,可以对照着看。
格局方面,报告指出竞争已由"算力/模型"单维能力比拼,转向"算力—模型—智能体—应用"的系统性全栈布局。
同时市场竞争主体多元,但份额持续向头部厂商集中。
报告援引Omdia的判断:2026年AI云架构被重新定义为基础设施、MaaS、AaaS三个独立层级。
智能体平台与模型分离,已成为产业共识。
"智能体平台与模型解耦"这个判断,对采购方的意义比看上去大。
过去企业选云,很大程度上是在选模型;现在模型可以被替换、被调度,真正难迁移的是智能体平台上的流程、记忆和工具链。
换句话说,锁定风险从"模型层"下移到了"平台层"。谈合同时该盯的条款,也随之变了。
四、算力:CPU成为约束,集群向十万卡级演进
第四章进入硬件,报告提了两个容易被忽略的变化。
第一个变化是架构。算力架构正转向"CPU+GPU"协同主导,而CPU成为系统核心约束。
依据来自佐治亚理工学院与英特尔的研究:在主流智能体框架任务测试中,CPU侧处理时延占比达40%—90%。
在Haystack RAG(检索增强生成)任务中,这一比例甚至超过90%。
对应地,英特尔、AMD相继于3月、4月启动涨价,服务器CPU涨幅达10%—15%,交货周期拉长至8—12周,部分型号长达6个月。
第二个变化是布局。算力布局转向推理优先,推理基础设施持续朝高效率、低成本演进。
芯片层面已经出现分工。2026年4月,谷歌发布第八代TPU,首次将训练与推理任务拆分至独立芯片,即专为训练打造的TPU 8t和专为推理打造的TPU 8i。
其每瓦计算性能比第七代TPU提升了一倍。
英伟达Vera Rubin依托NVLink 6高速互联、HBM4高带宽内存,较上一代Blackwell每瓦推理吞吐量提高10倍,单Token成本降至1/10。
报告还提到,与Groq LPX推理加速机架(含256个LPU)协同后,每兆瓦推理吞吐量最高可提升35倍。
集群规模上,报告确认超大规模高密度智算集群仍是刚需。2026年1月,xAI投运Colossus 2,拥有超55万颗英伟达GPU,功耗达1吉瓦。
4月,微软Fairwater AI数据中心提前上线,单个集群内整合数十万颗GB200 GPU。
国内方面,2026年7月中科曙光发布我国首台全国产10万卡AI超算集群曙光8000,同步接入国家超算互联网郑州核心节点。
"CPU成为核心约束"是这份报告里最反直觉、也最实用的一条。
产业界讨论算力瓶颈时几乎默认瓶颈在GPU,但报告给出的测试数据显示,智能体框架下CPU侧时延占比可以高到90%。
这解释了两件事:一是服务器CPU为什么涨价、交期为什么拉长;二是为什么单纯堆GPU卡数,端到端任务效率未必同比例提升。
五、网络:光进铜退与光纤供需失衡
第五章讲网络,结论是算力需求正在把光网络推到关键位置。
第一个驱动是超节点规模扩大。随着超节点持续扩大,铜缆逐渐逼近距离、带宽等物理极限,"光进铜退"成为高密互联的技术刚需。
技术路线上,LPO、NPO、CPO多路线并行推进。
消耗量可以量化。以英伟达H100/H200 SuperPOD集群为例,单机柜光纤消耗量约是传统机柜的5—10倍以上。
第二个驱动是多数据中心协同。头部企业已把大模型训练从一个站点扩展到多个数据中心园区。
例如微软通过高速光纤网络,把分布在不同州、相距超过1100公里的2个十万卡级AI数据中心连接成一个"虚拟的超级计算机"。
国内案例是:中国电信完成千亿参数大模型跨500公里、2个智算中心的分布式训练试商用,性能达集中式的99%以上。
谷歌自Gemini 1.0开始,也已实现多个数据中心(最远距离几十公里)协同训练模型。
第三个后果是供需失衡。据英国商品研究所(CRU)预测,全球AIDC光纤需求占比预计从2024年不足5%升至2027年30%—35%。
而供给端扩产周期长:上游光纤预制棒扩产周期长达18—24个月,且全球产能高度集中于我国。
主流厂商因此加速锁产能。2026年5月,英伟达与康宁达成长期合作,康宁承诺将其在美国的光连接制造能力提升10倍,光纤产能提升50%以上。
英伟达同时投资5亿美元换取康宁认股权证。
多数据中心协同训练这条路,本质上是拿网络换电力。
单个园区做到十万卡之后,供电、散热、土地都会撞天花板,把集群拆到多地再用光网络粘起来,是绕开物理约束的现实选择。
这也意味着光网络的战略地位从"配套"变成"瓶颈"——500公里跨域训练性能保持99%以上,这个数字背后是光纤、光模块和调度系统的共同功劳。
六、Harness工程:智能体落地的真正门槛
第六章是报告的理论亮点,讲AI工程范式的三阶段演进。
报告把范式演进分为三段:提示词工程、上下文工程、Harness工程。
Harness指的是包裹在大模型外面的那一层——工具调用、流程编排、风险约束、状态管理。
它的价值在于弥补大模型原生能力无法实现的风险约束与流程治理短板。
效果差距可以用两组对照说明。Anthropic的对比实验中,同一个模型、同一句提示词,以简单方式运行20分钟耗费9美元,核心功能完全无效。
而以完整Harness运行6小时耗费200美元,却交付了真正可用的产品。
据Nate B Jones研究,同一模型不变,仅优化Harness,编程任务成功率从42%提升至78%。
生产案例上,Notion集成后将原型制作时长从12小时缩短至20分钟,可同时启动30余个智能体处理编码、生成幻灯片等任务。
记忆管理是Harness的关键组件。阿里云基于Tair的分层记忆架构使其成本降低81.5%、延迟降低80%。
在LoCoMo和LongMemEval基准测试中,Memora相比全上下文推理可节省高达98%的Token消耗。
我们在整理《甲子光年工业AI智能体报告:千亿市场启动》时也碰到过类似的分歧,那里的结论可以拿来对照。
另有插件形态的验证:作为OpenClaw插件接入后,最高可节省61.38%的Token消耗,任务通过率相对提升51.52%,长期记忆准确率从48%提升至76%。
资源特征上,报告也给了具体数字:智能体所需资源波动明显,内存峰值可达平均值的15.4倍,CPU利用率在13%—175%波动。
而传统云负载内存峰值只是平均值的1—3倍,CPU利用率相对平稳。
41%到78%这个跨度说明,智能体的产出上限不完全由模型决定。
同一颗模型,换个外壳就能把成功率翻近一倍,那么企业在智能体上的投入分配就该重新算账——买更强的模型是一次性支出,建更好的Harness是持续收益。
这也解释了为什么头部厂商都在抢着把Harness工程产品化,做面向生产环境的Agent托管服务。
七、应用与区域:场景决定节奏,31省梯度分化
最后两章分别讲落地节奏和区域格局。
应用侧,报告的核心判断是"业务价值优先,场景决定落地节奏",智能体将优先落地高价值、可闭环的数字化场景。
数据支撑来自麦肯锡2025年全球调查:23%的受访企业已在至少一个职能中规模化部署智能体,另有39%处于试验阶段。
但要注意后半句——在任一具体职能中,规模化部署比例均未超过10%。
这说明企业仍主要围绕少数价值明确的流程集中投入,而非全面铺开。
治理与成本核算正在成为生产准入的硬门槛。IBM联合牛津经济研究院对2000名技术高管的调查显示,77%的受访机构认为AI应用速度已超过现有治理能力。
受访机构过去一年平均发生54起需要人工纠正的智能体事件,其中17%属于高严重度事件。
另有Gartner预测,到2026年,缺乏AI就绪数据支撑的AI项目中约60%将被放弃。
区域侧,报告构建了智能体产业发展潜力评估模型,对全国31个省做了评估。
综合结论是:我国省域智能体产业发展呈现"头部集聚与梯度分化并存"的基本格局。
分维度看,东部地区在政策治理、经济基础和创新资源方面综合优势较为突出。
基础设施维度,省域智能体基础设施已由单一算力供给转向算力、数据、网络和模型工具协同发展。
服务应用维度,能力主要集聚于AI产业基础和场景转化能力较强的地区。
报告特别强调:基础设施与服务应用的协同程度,直接决定算力资源能否转化为智能体产业能力。
据此给出的区域建议包括四点。
一是推动基础设施建设从资源扩张转向服务化和可调用化。
二是建设公共智能体平台,降低企业从试点到规模化的门槛。
三是以高价值、可验证、可闭环场景作为应用推广主线。
四是实施差异化行业布局,构建"一省一业多场景"推进体系。
想获取AI基础设施与算力产业方向的完整报告与方案,可以到运营动脉(www.yydm.cn)检索。
站点收录覆盖300+行业的研究报告与产业方案,适合做技术选型与投资决策时集中备查。
常见问题(FAQ)
这份报告是谁发布的?
由中国电信研究院天翼智库(行业与企业战略研究所)发布,全名《智能体时代AI基础设施发展研究报告(2026)》,共72页,发布时间为2026年9月。
Agentic AI和生成式AI的区别是什么?
生成式AI输出内容,代理式AI(Agentic AI)输出任务结果。区别体现在算力消耗量级上——智能体的内存峰值可达平均值的15.4倍,CPU利用率在13%—175%之间波动,而传统云负载内存峰值仅为平均值的1—3倍。
为什么说推理算力会成为主流?
报告预计2029年我国推理算力市场占比将达到80%。
驱动因素是智能体加速落地带动Token需求激增,且推理对时延敏感、调用频次远高于训练。
这直接改变了硬件选型标准——从看峰值算力转向看每瓦吞吐与单Token成本。
我国算力基础设施目前是什么水平?
截至2026年6月底,我国智能算力规模达2185EFLOPS(FP16),同比增长177%,全国算力设施整体上架率达71.4%。
Harness工程是什么,为什么重要?
Harness是包裹在大模型外面的工程层,负责工具调用、流程编排、风险约束和状态管理。
据Nate B Jones研究,同一模型仅优化Harness,编程任务成功率就能从42%提升至78%。
Anthropic的实验中,简单方式运行20分钟花9美元却完全无效,完整Harness运行6小时花200美元则交付了可用产品。
光纤需求为什么会爆发?
一是超节点扩大后铜缆逼近物理极限,需要"光进铜退";二是多数据中心协同训练成为集群扩张的关键手段。
据CRU预测,全球AIDC光纤需求占比将从2024年不足5%升至2027年30%—35%,而光纤预制棒扩产周期长达18—24个月。
企业规模化部署智能体进展如何?
麦肯锡2025年全球调查显示,23%的受访企业已在至少一个职能中规模化部署,39%处于试验阶段。
但要注意后半句——在任一具体职能中,规模化比例均未超过10%。
同时IBM调查显示,77%的机构认为AI应用速度已超过现有治理能力。
我国省域智能体产业发展格局如何?
报告对全国31个省做了潜力评估,结论是"头部集聚与梯度分化并存"。
东部地区在政策治理、经济基础和创新资源方面综合优势突出。
基础设施建设正由单一算力供给转向算力、数据、网络和模型工具协同发展,报告建议实施差异化行业布局,构建"一省一业多场景"推进体系。
接着可以看的几篇报告解读
如果这个话题跟你手上的业务有关,下面这几篇报告解读拆的是同一类问题的不同侧面,可以一起看。
《算力基础设施报告:AI竞争的下一站是水与电》——美国数据中心电力需求将从2025年31GW升至2027年66GW,冷却塔约占数据中心用水量的97%
《智算中心趋势报告:智能算力规模超1882EFLOPS》——切口是智能算力规模超1882EFLOPS
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。