具身智能卡在数据上,一小时真机数据要几百块
 广告
本文解读:《2026人形机器人系列专题之具身数据:物理AI核心资产,模型迭代孕育数据产业新蓝海-国信证券》 · 共 41 页 · 原文
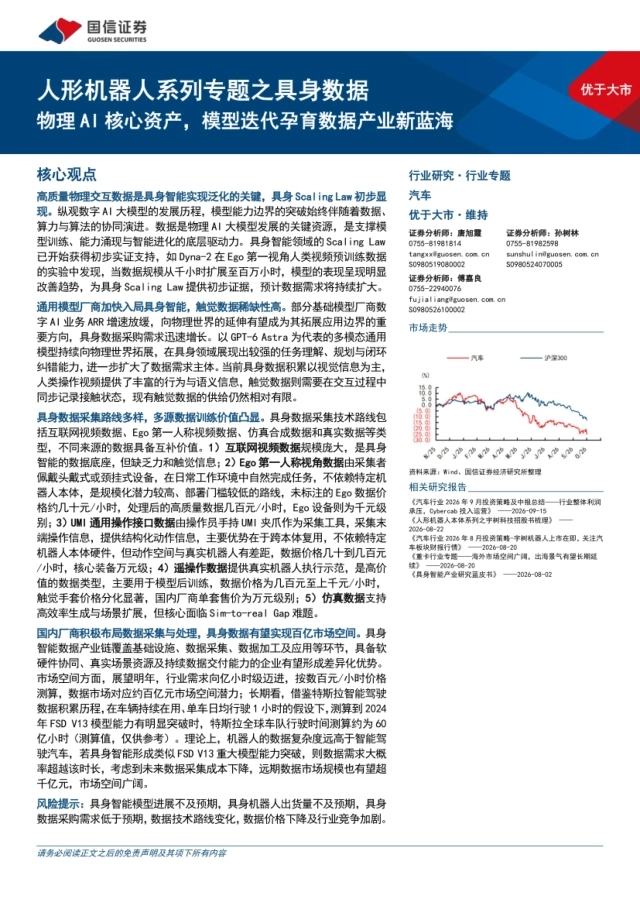
具身智能真正的卡点已经不在本体,而在数据:报告给出的口径是,行业要做到真正可用 至少需要 1000 万小时真实交互数据,而当前全行业高质量真实物理交互数据只有约 50 万小时。
国信证券这份专题把数据当成物理 AI 的核心资产拆开看,先问 Scaling Law 有没有实证, 再问数据从哪来、多少钱一小时、谁能规模化交付。
五条采集路线的价格差得很开:互联网视频几十元一小时,Ego 与 UMI 几十到几百元, 遥操作几百到上千元,仿真几乎不花钱但有 Sim-to-Real 鸿沟。
报告测算明年需求若迈向亿小时级,按数百元一小时算大约对应百亿元市场; 远期参考特斯拉 FSD V13 积累的 60 亿小时,规模有望超过千亿元。
数据不是本体的附属品,而是这门生意里最贵、也最难标准化的一段,谁先攒够谁先跑通。
图源:《物理AI核心资产,模型迭代孕育数据产业新蓝海》(第1页)
一、瓶颈从本体挪到了数据端
报告开篇的判断很直接:随着硬件本体逐步成熟,算法迭代的瓶颈逐渐转移到了数据端。 这句话在 2026 年听着已经不新鲜,但背后有具体的数字撑着。
亿欧智库的口径是,具身智能要达到真正可用至少需要 1000 万小时级别的真实场景交互数据, 而当前全行业高质量真实物理交互数据总量仅约 50 万小时,人类视频数据约 100 万小时。
缺口是结构性的。具身数据没法从互联网直接抓,只能靠采集、仿真这些高成本路径获得, 于是价格被抬到了真机有效数据 500 至 1000 元一小时,比标注语料贵出好几个量级。
报告由此把数据定义为物理 AI 的核心资产:它既是模型训练的起点, 也是机器人数据飞轮转起来的第一推动力,没有它,感知、决策、执行的闭环根本启动不了。
本体可以买、算法可以追,只有数据要一家一家场景去攒,这也是最难绕过去的一段。
图源:《物理AI核心资产,模型迭代孕育数据产业新蓝海》(第6页)
二、具身 Scaling Law 等来了第一个实证
数字 AI 的规模定律早就被验证,物理世界是否同样成立,一直是行业里最大的假设。 报告给出的第一个实证来自 Dyna Robotics 在 2026 年 8 月发布的 Dyna-2。
它用第一视角人类操作视频做预训练,当数据规模从千小时扩展到百万小时, 模型在机器人数据上的离线预测表现,以及经过真机数据后训练后的任务表现,都呈现改善趋势。
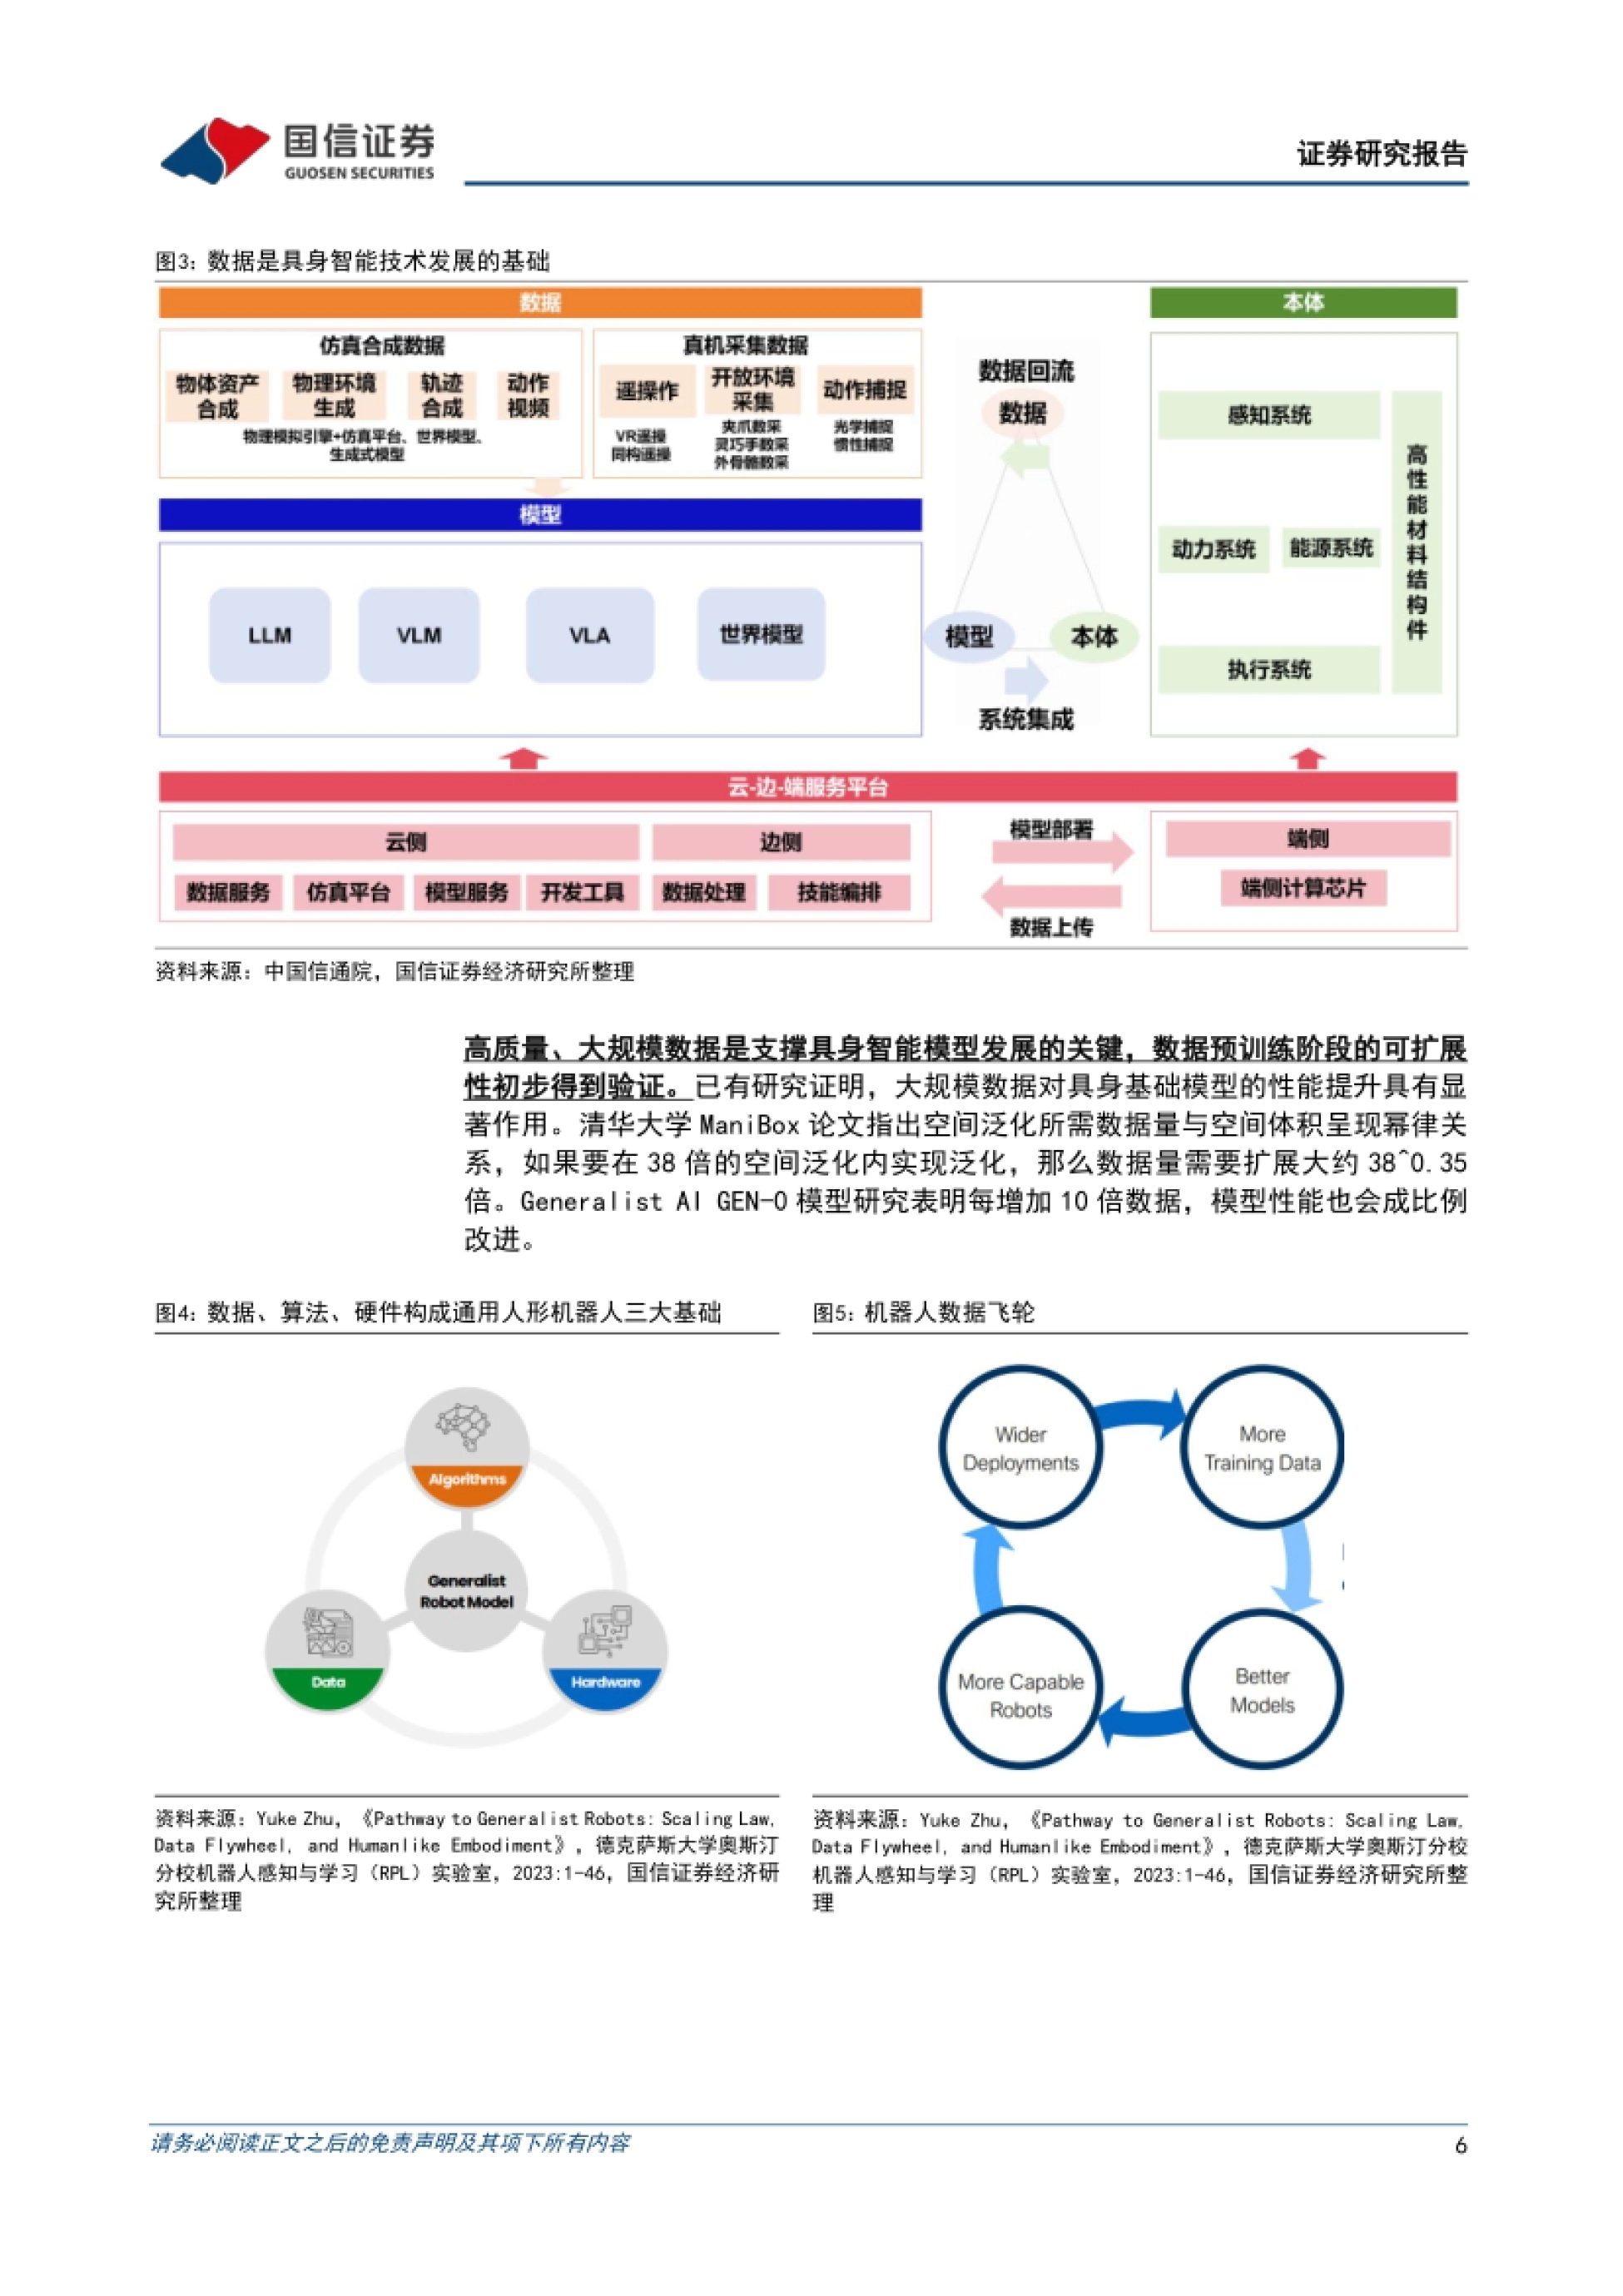
另外两组研究补上了量化关系。清华 ManiBox 指出空间泛化所需的数据量与空间体积呈幂律关系, 要在 38 倍的空间内实现泛化,数据量大约需要扩展 38 的 0.35 次方倍。
Generalist AI 的 GEN-0 模型研究更直白:每增加 10 倍数据,模型性能也成比例改进。 这类结论对产业的直接含义是,数据采购会持续放量,而不是一次性投入。
报告还画了一张数据飞轮:机器人被部署到真实场景、执行任务时收集行为数据、 高质量数据用于训练、更通用的模型再被部署到更多机器人上,如此循环。
规模定律在物理世界初步站住脚,数据就从成本项变成了可以复利的资产。
图源:《物理AI核心资产,模型迭代孕育数据产业新蓝海》(第3页)
三、需求往亿小时走,存量还停在百万小时
各家本体厂商给出的数据规划,量级已经从百万小时往亿小时抬。星海图提出百万至千万小时的 模型能力突破区间,并启动 100 万小时真实数据计划,目标三年做到千万小时规模。
银河通用计划到 2028 年把训练数据由 100 万小时提升至 1000 万小时;优必选 2026 年的收集目标是 100 万小时;智元姚卯青则估计,物理世界的「GPT 时刻」可能需要约 1 亿小时数据。
供给侧的进展可以量化。中国信通院的数据显示,2026 年 10 月全国已建成启用 70 多家具身智能 训练场,另有 40 余家在建或规划,相关数据平台已交付 150 万小时人类视频数据。
企业口径差异很大:自变量披露的操作视频规模为数万小时;Figure 的 Index 平台到 2026 年 8 月 收到超过 1600 万条用户上传视频,披露的预训练与中期训练数据接近 100 万小时。
这些数字放在一起看,缺口不在需求侧而在交付侧。谁能稳定产出百万小时级、 场景覆盖够宽的数据,谁就握住了这一轮数据定价的话语权。
需求已经在讲亿小时,供给还停在百万小时,中间这段距离就是市场空间,也是最难填的一段工程活。
四、五条路线,五个价格带
报告把采集路线拆成互联网视频、Ego 第一人称、UMI 通用操作接口、真实遥操作和仿真合成五类, 它们的成本、精度和可复用性完全不同,硬凑在一张表里比较没有意义。
互联网视频是数据底座。人类视频在互联网上已沉淀超过百亿小时,获取成本低、场景真实, 但缺了力和触觉,只能让模型看懂世界,没法支撑精准的物理交互。
Ego 数据由采集者佩戴头戴或颈挂设备,在日常环境里自然完成任务,不依赖特定本体。 未标注数据约几十元一小时,处理后几百元一小时,设备是千元级别。
UMI 靠操作员手持夹爪采集末端操作信息,几十到几百元一小时,核心装备万元级; 遥操作最贵,几百到上千元一小时,设备单套购入价超过 20 万元。
仿真数据几乎不花钱,靠物理引擎批量生成,效率高、多样性好,但 Sim-to-Real Gap 始终存在, 质量还不足以支撑可靠的行为学习和真实场景泛化。
五条路线不是替代关系,报告判断未来会走向多源融合,各管一段。

图源:《物理AI核心资产,模型迭代孕育数据产业新蓝海》(第1页)
五、Ego 是最便宜也最像人的一条
Ego 之所以被看重,是因为它便宜且规模化潜力大。特斯拉的做法很典型:数十名员工在 8 小时 轮班里重复日常动作数百次,头盔和背包上固定 5 台摄像机全程记录。
效果有研究背书。2024 年的 EgoMimic 研究显示,在 Ego、三维手部轨迹与遥操作数据联合训练下, 连续拾取入碗任务得分从 68 分升到 128 分,增幅约 88%。
同一项研究里,叠衣任务成功率从 73% 提升到 88%;拾取入碗任务中,人类示范每小时的采集数量 约为机器人遥操作的 10.4 倍,效率与效果同时占优。
2026 年英伟达的 EgoScale 研究进一步验证了扩张效应:预训练 Ego 数据从 1000 小时加到 20000 小时,真机平均任务完成度评分从 0.30 提升到 0.71,相对提高约 137%。
短板也清楚:视频数据缺精细力和触觉,还需要 SLAM 轨迹恢复、三维手部姿态估计、 逆运动学与动作重定向一整套后处理,破晓智能干脆用四目头环加触觉手套补全身模态。
便宜、快、场景真实,Ego 的代价是把最难的活全部推给了后处理,这一步做不好,数据就只是一堆视频。
六、UMI 能跨本体,遥操作最保真
UMI 的价值在于跨本体复用:一套采集数据可以适配多种机器人形态,相当于给不同本体做了一个 通用的类人操作接口,采集时也不需要机器人本体在场。
精度上它并不含糊。智在无界的 UMI 灵巧手 BeingBeyond U1 可以采视觉、动作、力、触觉数据, 动态追踪最大误差小于 1 毫米,平均误差小于 0.1 毫米。
问题是动作空间和真实机器人有差距。UMI 多为夹爪,人形机器人末端主要是灵巧手, 夹爪数据在灵巧手训练中可复用性不高,这是路线本身的错位。
遥操作是另一头。它由人通过 VR 设备或外骨骼控制本体执行真实任务,视觉、力觉、触觉同步记录, 与本体结构一致性强,主要用于模型后训练和精细作业。
代价是贵。设备购入价超过 20 万元一套,规模化运营后单小时有效数据成本约 275 元, 小规模采集可达数千元;8 小时工作平均只产出 2 到 3 小时有效数据。
要通用性就选 UMI,要保真度就上遥操作,这两条路的钱都省不掉。
图源:《物理AI核心资产,模型迭代孕育数据产业新蓝海》(第2页)
七、触觉最稀缺,也最难用
具身数据目前以视觉为主,触觉供给明显不足。触觉要在交互过程中同步记录接触状态, 采集时得把传感器集成到机器人末端、手持设备或可穿戴手套上,围绕不同物体和材质组织交互。
硬件路线还没收敛。压阻、电容、压电、霍尔、视触觉各有取舍,传统电信号方案在高空间分辨率下 会遇到布线、串扰和电磁干扰,视触觉则把接触信息直接编码成图像。
更难的是融合。2026 年 6 月发布的 T-Rex 论文发现,把单时刻指端力信号直接拼接到 π0.5 的 状态输入后,12 项接触密集型任务的平均评估得分由 17 降到 6。
同一项研究的消融实验反过来说明触觉的价值:完整模型得分 65,移除触觉后降到 42。 也就是说,触觉给的方式不对是负担,给对了才是能力。
报告因此判断,触觉数据的难点不止在采集,还在于它与其他模态的融合方式, 这决定了触觉数据能不能真正进入训练管线,而不是停在论文里。
视觉数据可以靠买,触觉数据只能靠自己搭一套采集链路,这就是为什么它的缺口一直补不上。
报告原文都放在运营动脉(www.yydm.cn)上,图表、口径说明和样本量写得清清楚楚,可以对着核。
遇到拿不准的数据,建议回原文翻一眼,比被二手解读带着走要稳妥得多。
八、数采工厂重资产,众包把成本摊薄
数采工厂是重资产生意。以天津帕西尼的具身智能超级数据工厂为例,空间达到 1.2 万平方米; 一个部署 100 台机器人的训练场,仅本体投入就上千万元。
成本结构里还有人和场地。采集员要懂产业场景、会操作设备、能做人在环的质量把控, 门槛高于普通标注员;算力与存储则要匹配数百 PB 级的容量。
众包走的是另一条路。2026 年 9 月 23 日,觅蜂科技发布众包平台觅蜂派,用户在 App 上领任务, 佩戴 MEgo 设备采集,按审核后的有效时长拿报酬。
价格已经算得很细:设备租金 39 元一天,单次任务报酬 20 到 50 元,时长 2 到 60 分钟, 完成两项任务就能覆盖当天设备租金,用户当天基本可以回本。
觅蜂自己的产能是这条路的注脚:2026 年 8 月 31 日第 20000 套 MEgo 设备下线,累计生产超过 100 万小时无本体数据,覆盖 22 大类场景、1 万余个真实环境和 500 余种细分任务。
集中式保证质量,分布式保证多样性,报告认为两者会长期并存。
九、百亿到千亿,这个数怎么算出来
近期口径比较直接。报告测算,展望明年若行业需求向亿小时级迈进,按数百元一小时的价格测算, 数据市场对应约百亿元的市场空间潜力。
远期口径借了智能驾驶的参照系。在车辆持续在用、单车日均行驶 1 小时的假设下, 特斯拉到 2024 年 FSD V13 能力明显突破时,全球车队累计行驶时间约 60 亿小时。
报告认为机器人的数据复杂度远高于汽车,若出现同等量级的能力突破,数据需求大概率超过 60 亿小时;叠加采集成本下降,远期市场规模有望超过千亿元。
商业模式仍以定制化服务为主。客户对数据类型、采集方式和交付标准的要求差异很大, 项目制是最现实的形态,数据授权、工具订阅、场景运营都还在探索阶段。
盈利能力取决于三件事:数据复用程度、生产自动化水平,以及场景资源和交付成本的控制。 靠单纯堆人力采集,很难做出可持续的毛利。
百亿是明年的账,千亿是这条赛道把采集成本打下来之后的账。

图源:《物理AI核心资产,模型迭代孕育数据产业新蓝海》(第39页)
十、产业链上的位置与几处风险
产业链分三层。上游是算力与云服务、采集硬件与传感器、训练场;中游做真机遥操作、无本体采集、 仿真合成,再经治理、标注和流通形成供给;下游对接整机、模型与行业客户。
竞争壁垒落在三个能力上:能不能持续接入真实场景,能不能做数据筛选与加工, 能不能验证模型效果。这三件事决定了客户会不会续单。
报告在上市公司层面也做了梳理,从数据平台、仿真合成到工业与家庭场景回流, 各环节都有企业在布局,但多数仍处在早期投入、产能爬坡的阶段。
风险列了六条:具身智能模型进展不及预期、机器人出货量不及预期、数据采购需求低于预期、 技术路线变化、数据价格下降,以及行业竞争加剧。
其中价格风险值得单独看。数据一旦被标准化、被众包摊薄,单价下行会比需求上行来得更快, 靠信息差赚差价的中间环节最先被挤压。
这门生意的终局不是谁采得多,而是谁的数据能被模型反复用得上。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。