桌面
添加运营动脉到电脑桌面
安装后将用独立窗口打开,并可在电脑桌面快捷访问
足迹
浏览记录
加载中...
查看更多

2026-面向具身智能的视觉 语言 动作模型研究进展-43页

2026-面向具身智能的视觉 语言 动作模型研究进展-43页 复制标题
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第1页
1/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第2页
2/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第3页
3/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第4页
4/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第5页
5/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第6页
6/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第7页
7/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第8页
8/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第9页
9/45页
2026-面向具身智能的视觉 语言 动作模型研究进展-43页_第10页
10/45页
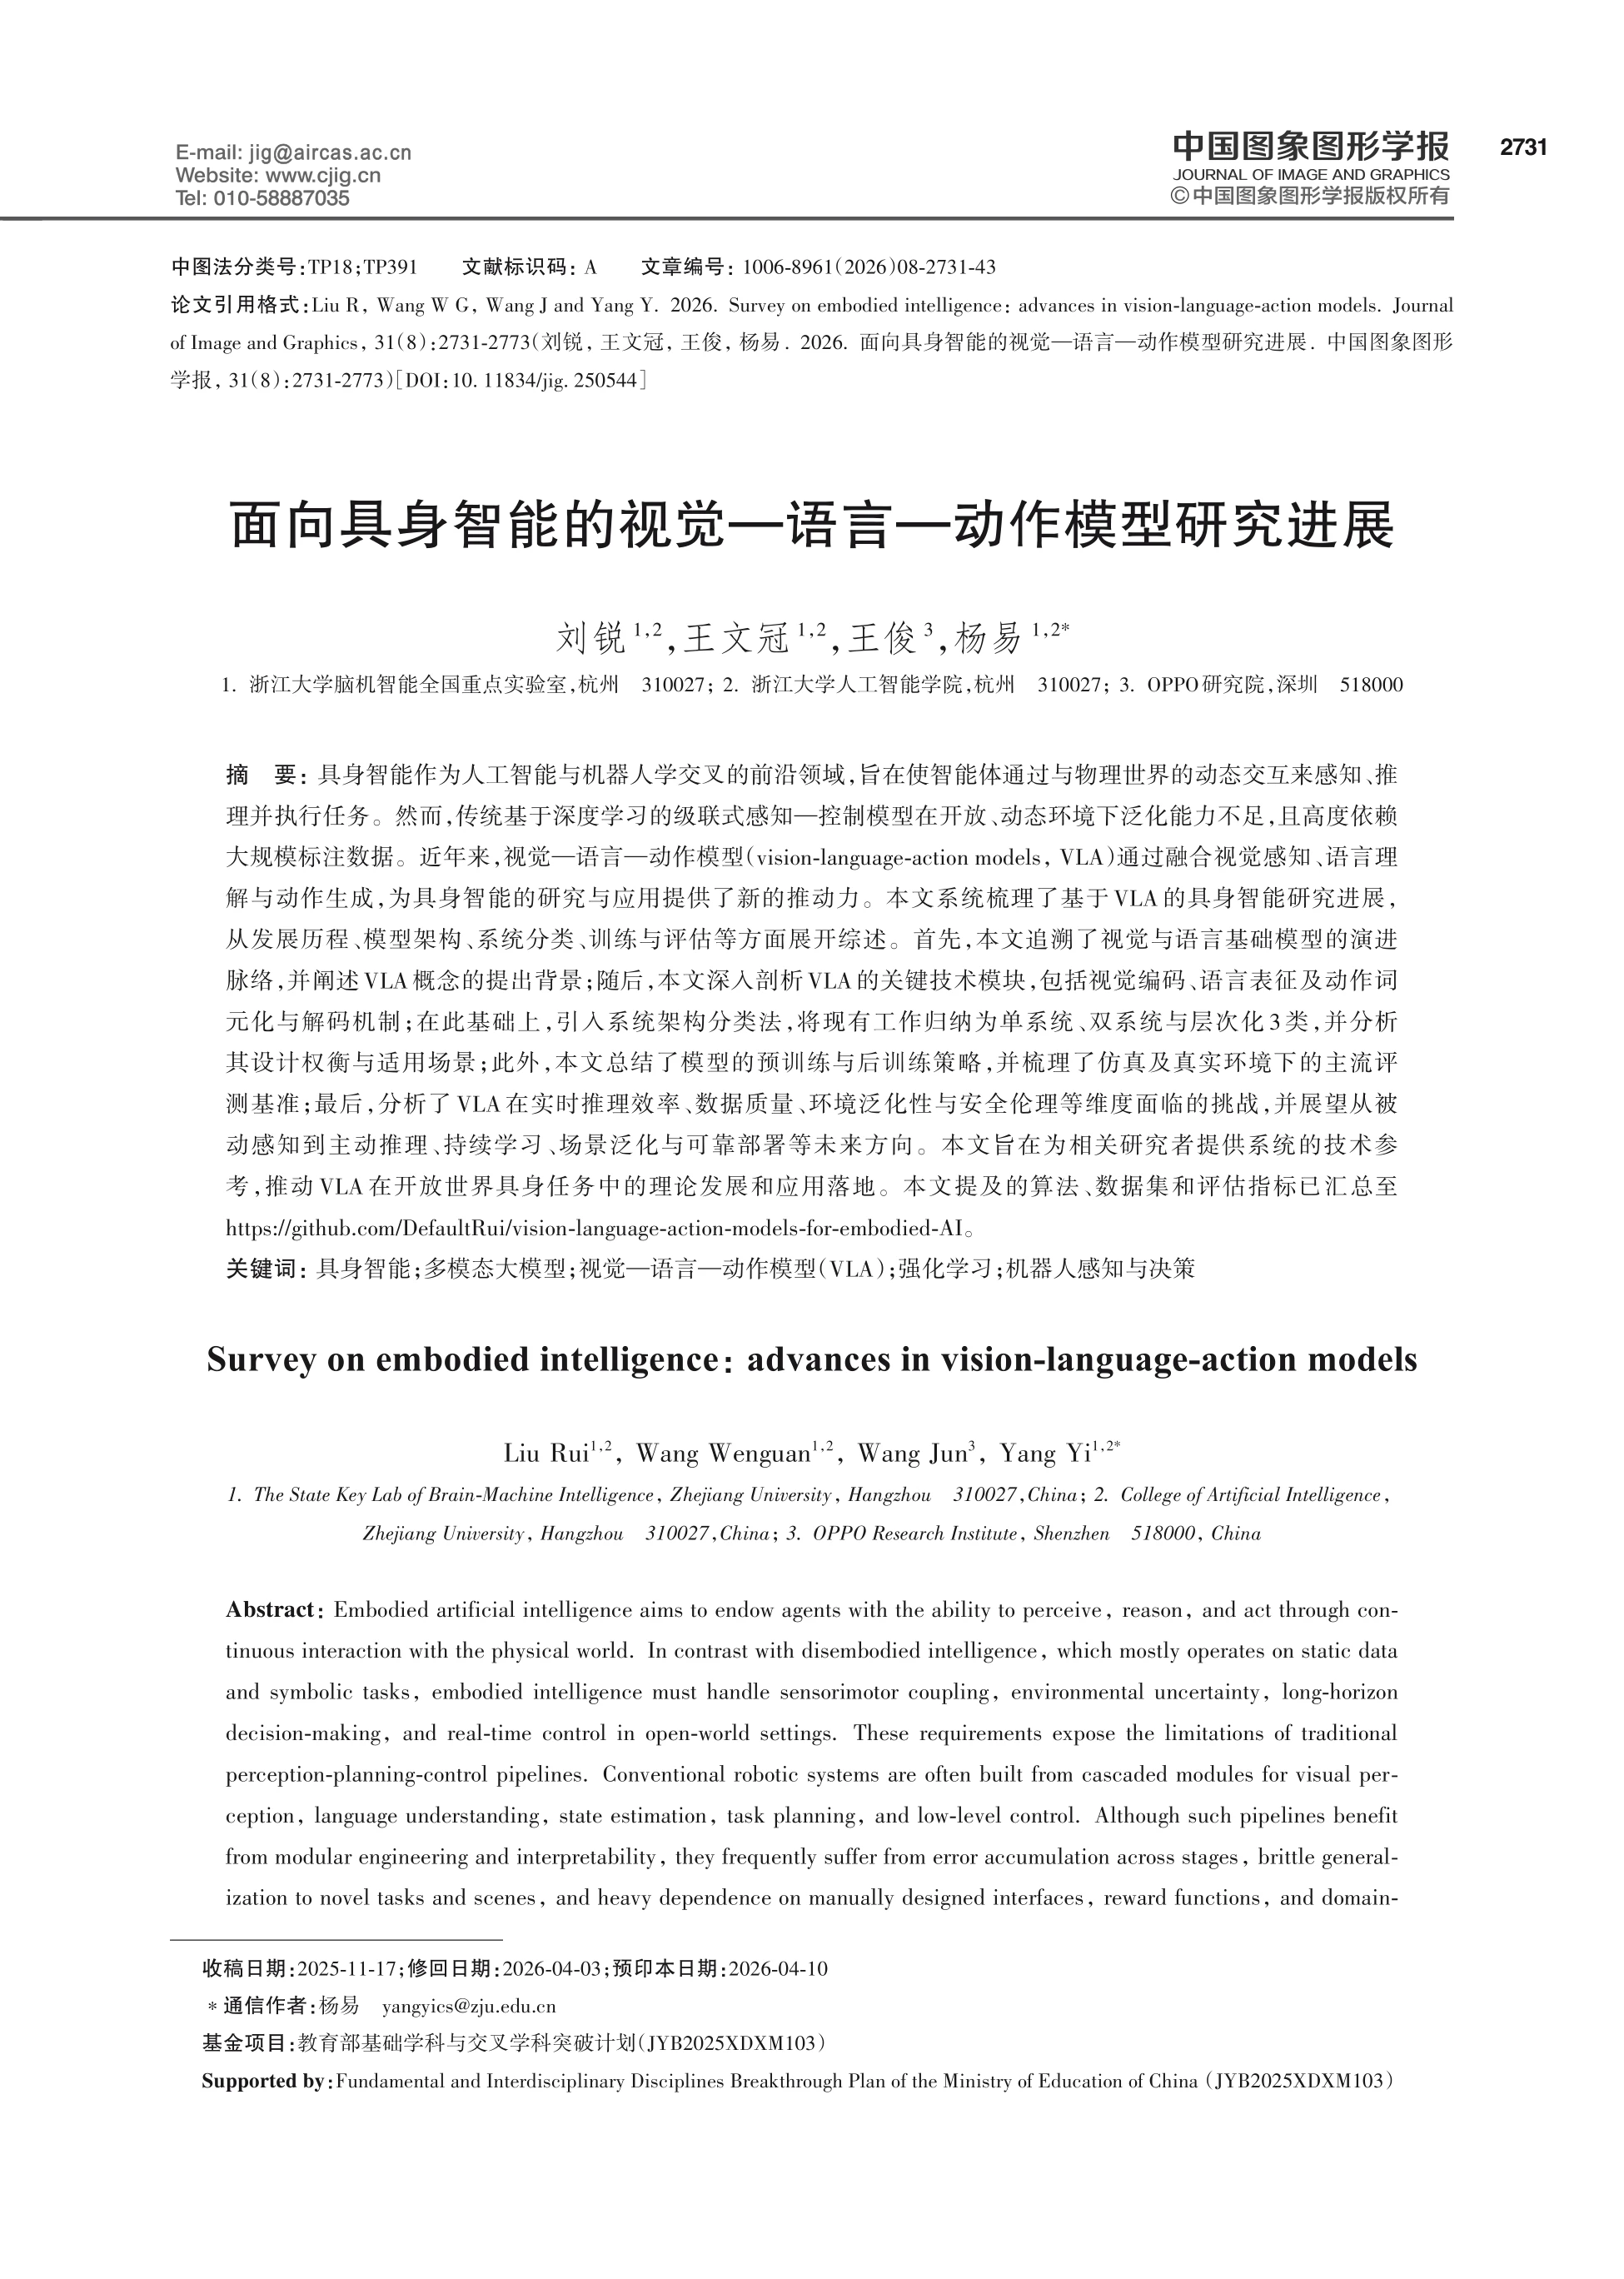
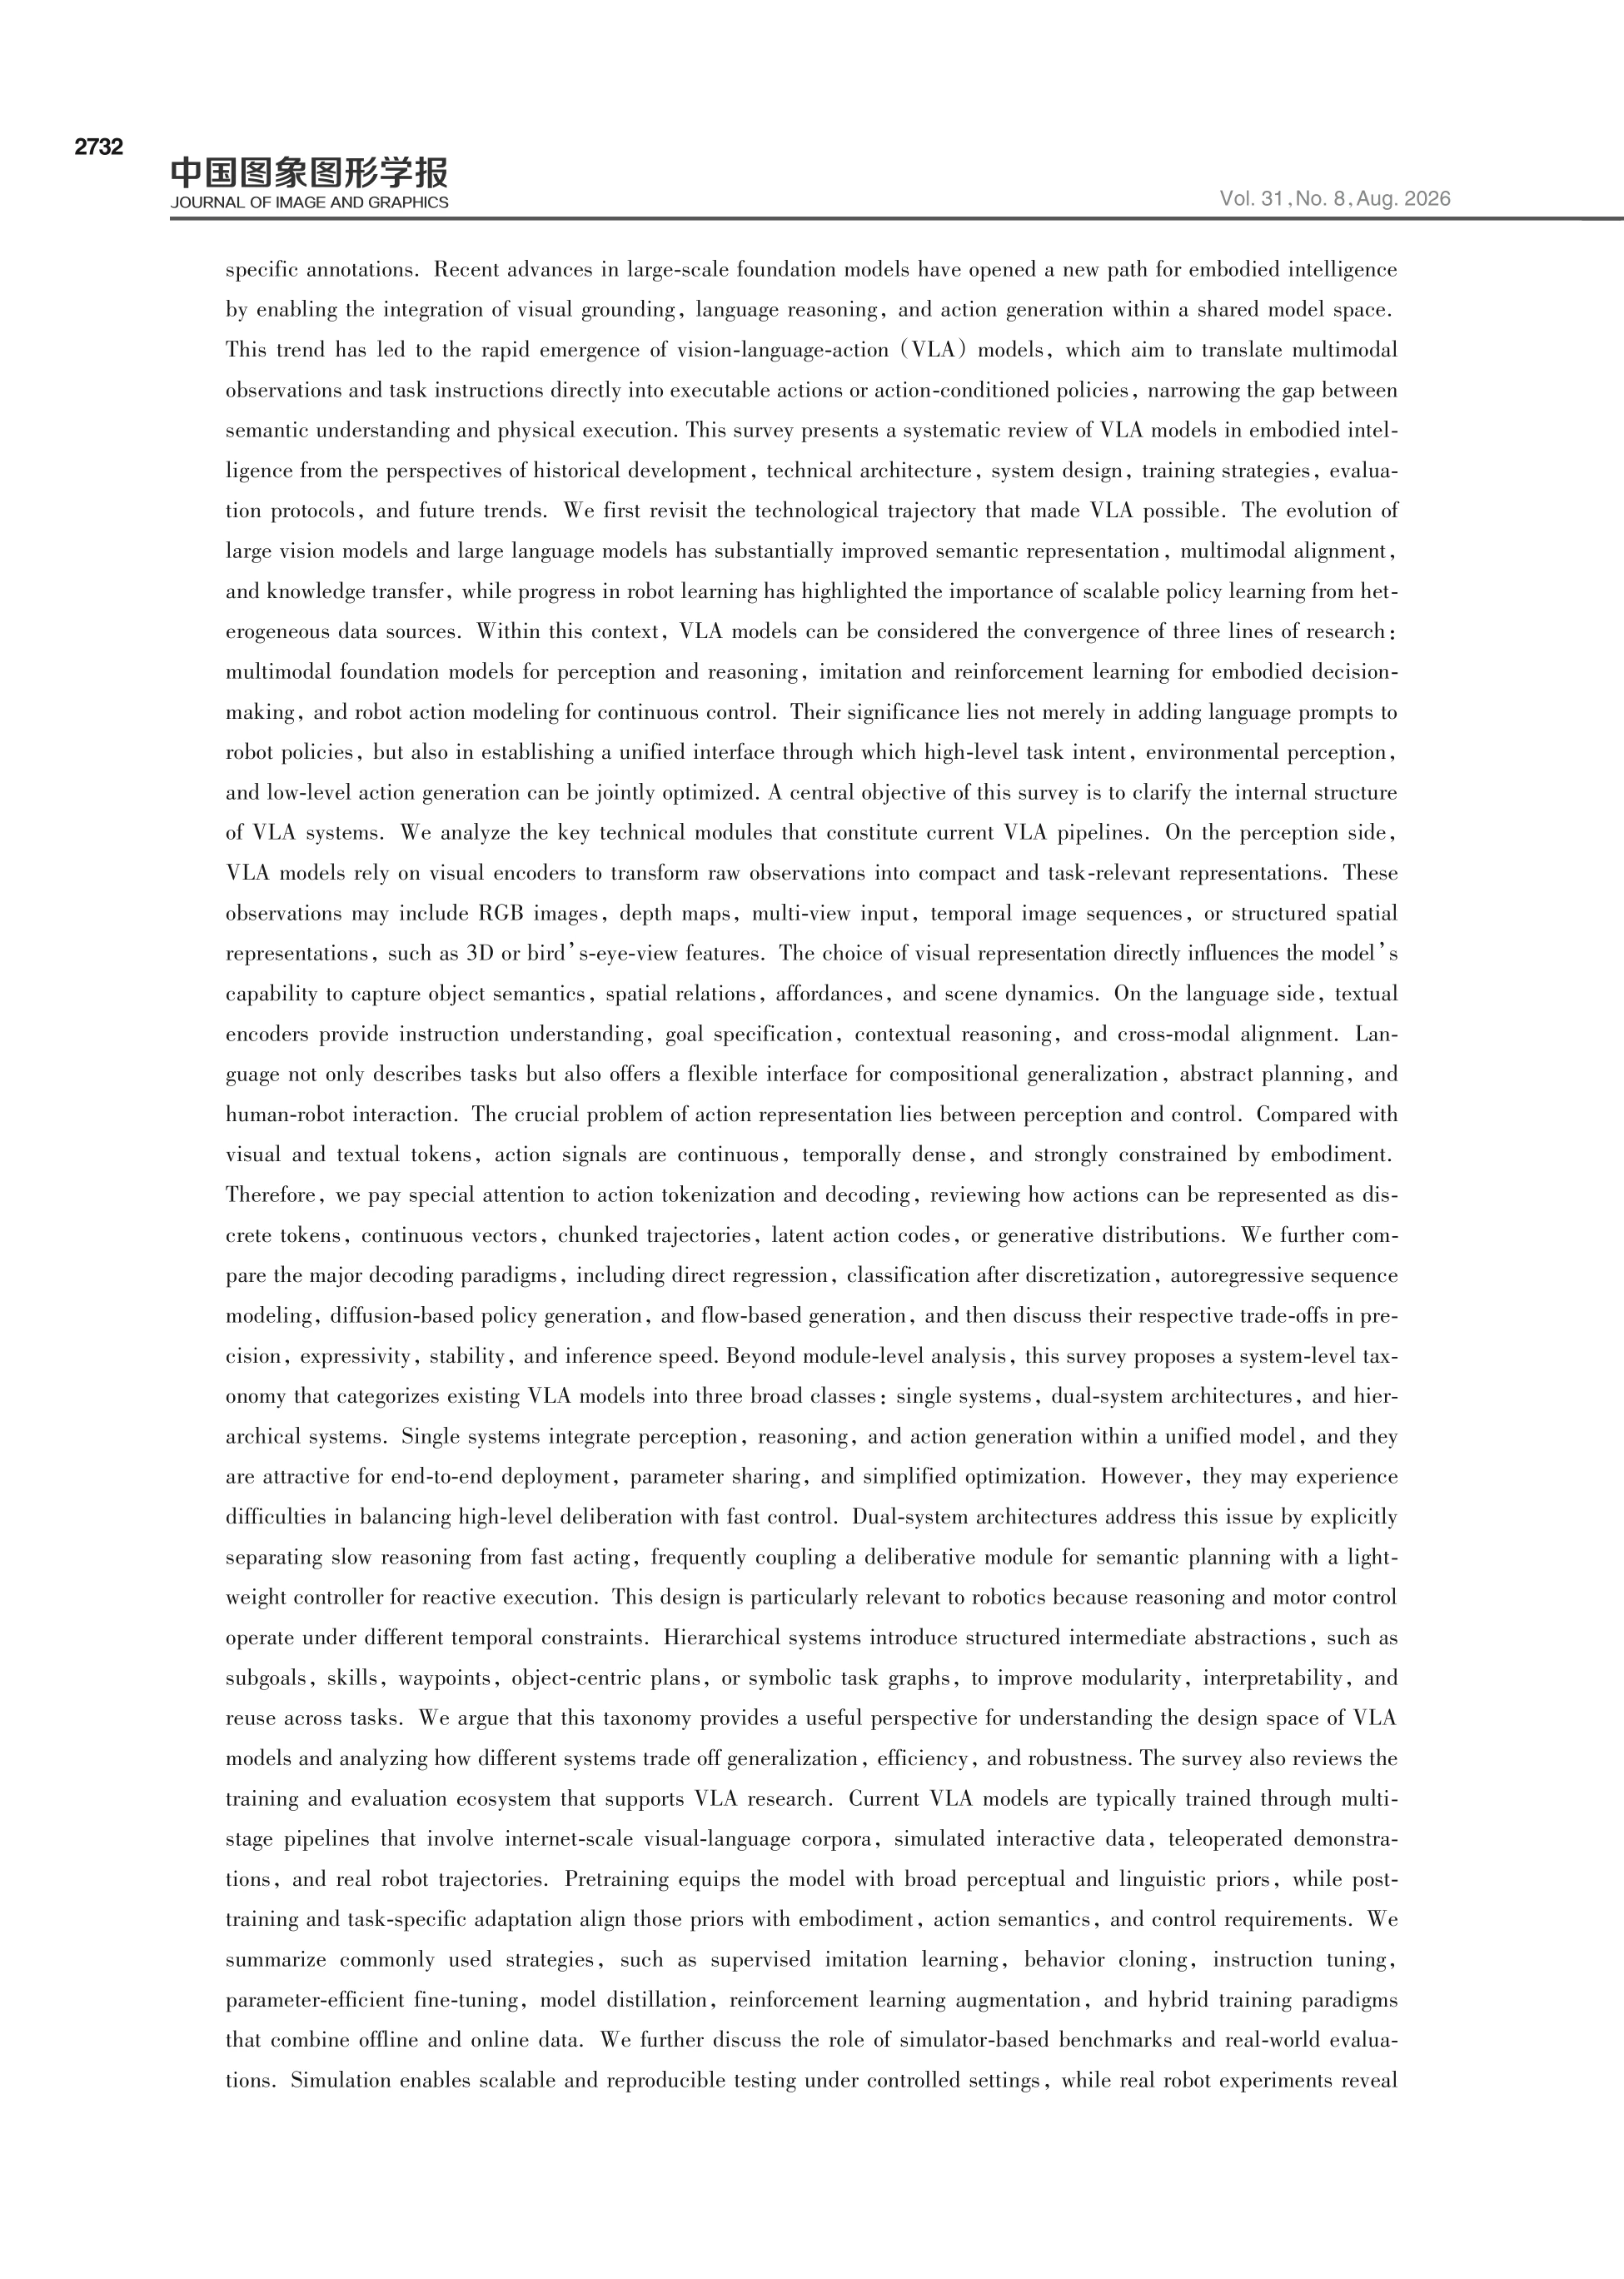
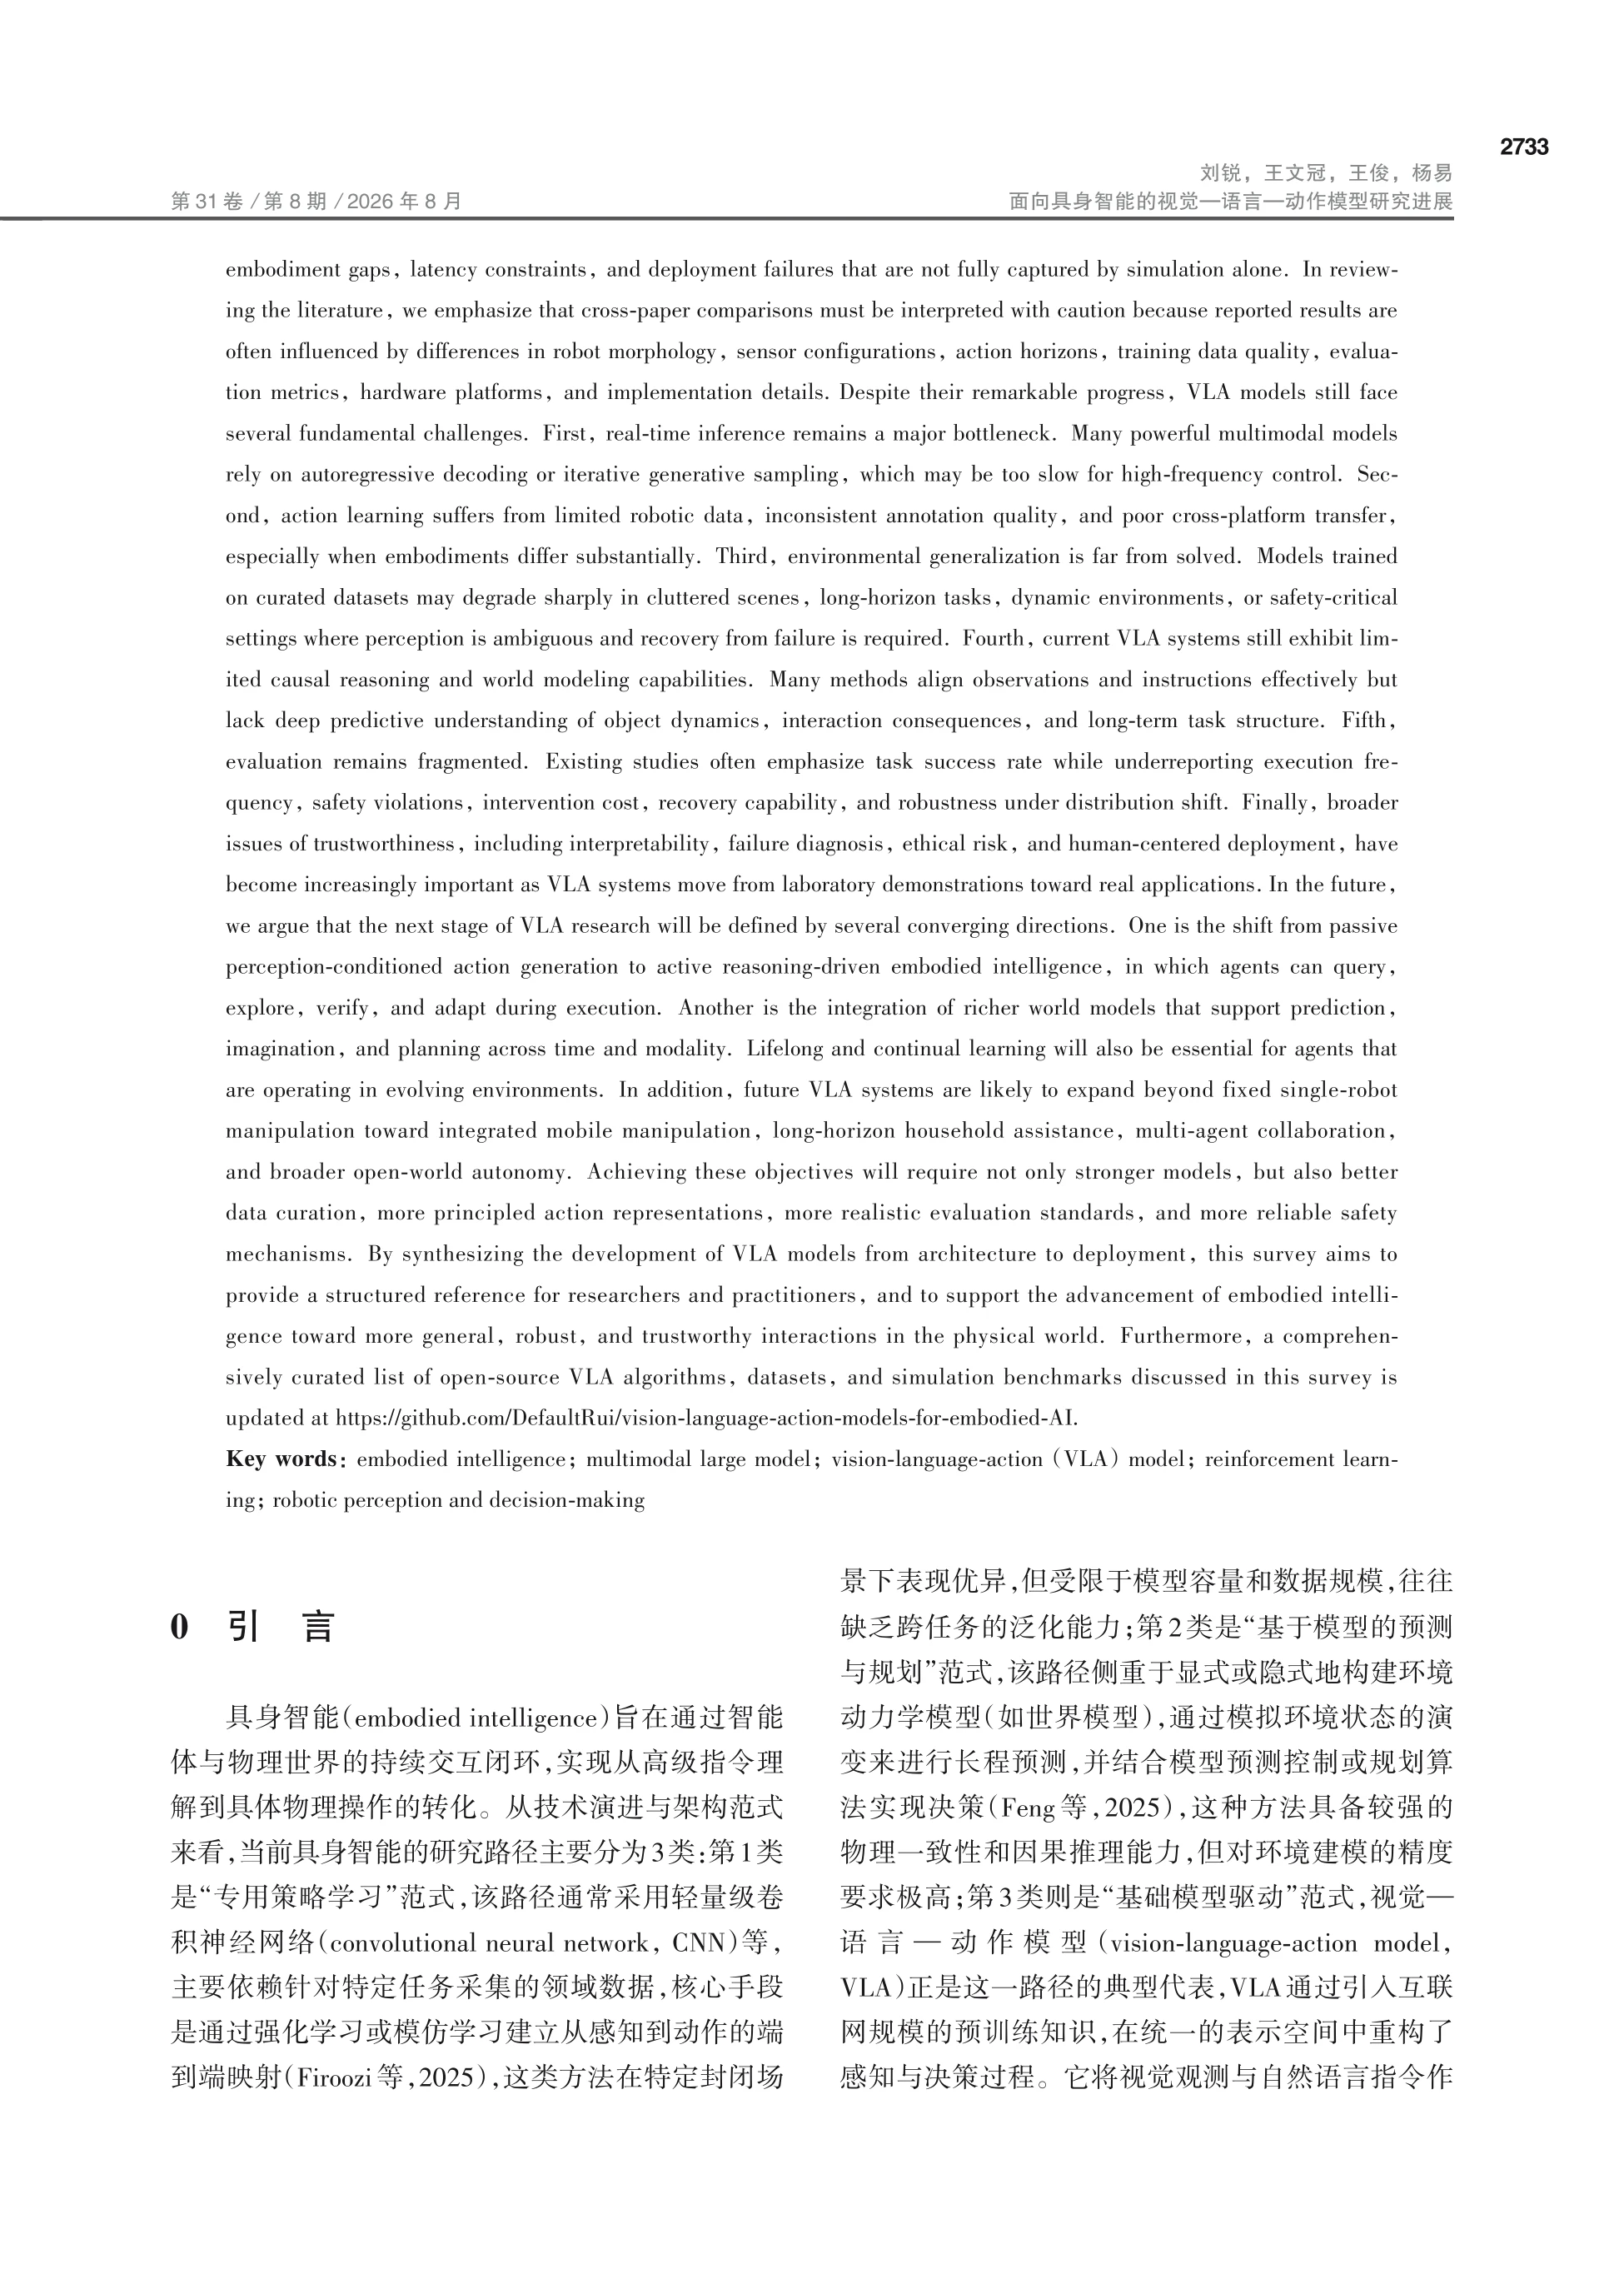
面向具身智能的视觉—语言—动作模型研究进展刘锐 1,2,王文冠 1,2,王俊 3,杨易 1,2*1. 浙江大学脑机智能全国重点实验室,杭州 310027; 2. 浙江大学人工智能学院,杭州 310027; 3. OPPO研究院,深圳 518000摘 要: 具身智能作为人工智能与机器人学交叉的前沿领域,旨在使智能体通过与物理世界的动态交互来感知、推理并执行任务。然而,传统基于深度学习的级联式感知—控制模型在开放、动态环境下泛化能力不足,且高度依赖大规模标注数据。近年来,视觉—语言—动作模型(vision-language-action models, VLA)通过融合视觉感知、语言理解与动作生成,为具身智能的研究与应用提供了新的推动力。本文系统梳理了基于 VLA 的具身智能研究进展,从发展历程、模型架构、系统分类、训练与评估等方面展开综述。首先,本文追溯了视觉与语言基础模型的演进脉络,并阐述 VLA 概念的提出背景;随后,本文深入剖析 VLA 的关键技术模块,包括视觉编码、语言表征及动作词元化与解码机制;在此基础上,引入系统架构分类法,将现有工作归纳为单系统、双系统与层次化 3 类,并分析其设计权衡与适用场景;此外,本文总结了模型的预训练与后训练策略,并梳理了仿真及真实环境下的主流评测基准;最后,分析了 VLA 在实时推理效率、数据质量、环境泛化性与安全伦理等维度面临的挑战,并展望从被动感知到主动推理、持续学习、场景泛化与可靠部署等未来方向。本文旨在为相关研究者提供系统的技术参考,推动 VLA 在开放世界具身任务中的理论发展和应用落地。本文提及的算法、数据集和评估指标已汇总至https://github.com/DefaultRui/vision-language-action-models-for-embodied-AI。关键词: 具身智能;多模态大模型;视觉—语言—动作模型(VLA);强化学习;机器人感知与决策Survey on embodied intelligence: advances in vision-language-action modelsLiu Rui1,2, Wang Wenguan1,2, Wang Jun3, Yang Yi1,2*1. The State Key Lab of Brain-Machine Intelligence, Zhejiang University, Hangzhou 310027,China; 2. College of Artificial Intelligence, Zhejiang University, Hangzhou 310027,China; 3. OPPO Research Institute, Shenzhen 518000, ChinaAbstract: Embodied artificial intelligence aims to endow agents with the ability to perceive, reason, and act through con⁃tinuous interaction with the physical world. In contrast with disembodied intelligence, which mostly operates on static data and symbolic tasks, embodied intelligence must handle sensorimotor coupling, environmental uncertainty, long-horizon decision-making, and real-time control in open-world settings. These requirements expose the limitations of traditional perception-planning-control pipelines. Conventional robotic systems are often built from cascaded modules for visual per⁃ception, language understanding, state estimation, task planning, and low-level control. Although such pipelines benefit from modular engineering and interpretability, they frequently suffer from error accumulation across stages, brittle general⁃ization to novel tasks and scenes, and heavy dependence on manually designed interfaces, reward functions, and domain-中图法分类号:TP18;TP391 文献标识码: A 文章编号: 1006-8961(2026)08-2731-43论文引用格式:Liu R, Wang W G, Wang J and Yang Y. 2026. Survey on embodied intelligence: advances in vision-language-action models. Journal of Image and Graphics, 31(8):2731-2773(刘锐, 王文冠, 王俊, 杨易 . 2026...

1、当您付费下载文档后,您只拥有了使用权限,并不意味着购买了版权,文档只能用于自身使用,不得用于其他商业用途(如 [转卖]进行直接盈利或[编辑后售卖]进行间接盈利)。
2、本站所有内容均由合作方或网友上传,本站不对文档的完整性、权威性及其观点立场正确性做任何保证或承诺!文档内容仅供研究参考,付费前请自行鉴别。
3、如文档内容存在违规,或者侵犯商业秘密、侵犯著作权等,请点击“违规举报”。

查找下载文件的指引

一、电脑端

- Windows 系统:按下键盘快捷键 `Ctrl + J`,即可打开下载列表。  

- Mac 系统:按下键盘快捷键 `⌘ + J`,即可打开下载列表。  

二、手机端

1. 打开手机浏览器,点击浏览器右下角的 “≡”(或“更多”)图标。  

2. 在弹出的菜单中找到并点击 “下载内容”(或类似选项),即可查看已下载的文件。  

提示:不同浏览器界面略有差异,若未找到“下载”入口,可尝试在浏览器设置中搜索“下载”关键词。


2026-面向具身智能的视觉 语言 动作模型研究进展-43页

¥9.9
会员免费
下载本文档
安全支付  |  可重复下载
格式pdf
大小4.8 MB
页数约45页
下载16 次
古玉白 + 关注
实名认证
确认删除?
会员
教程
联系
  • 站长微信
顶部