具身智能卡在数据上:要百万小时,现在攒了不到 5%
 广告
本文解读:《2026中国具身智能数据产业分析报告-易观分析》 · 共 30 页 · 原文
硬件不是瓶颈了,数据才是。易观分析这份报告的判断很直接:机器人已经解决了能不能动,接下来卡在能不能喂饱模型。
它引用国际先进技术应用推进中心的测算:要实现具身智能能力的涌现,至少需要百万小时级来自真实世界的' 物理互动数据,而目前行业积累不到需求的 5%。
数据缺口不止是总量。报告把它拆成三层:量不足,质不够,异构不通。真机数据质量最高但单小时成本 500 到 1000 元,' 仿真数据无限却有迁移偏差,互联网视频规模大却没有动作标签。
最刺眼的一组数字来自斯坦福 HAI《AI Index Report 2026》:机器人操控在仿真中的成功率 89.4%,' 到真实家庭场景降到 12%,中间是 77 个百分点的鸿沟。报告给出的答案不是某一项技术,而是造、治、用、通协同推进的系统工程,把数据从企业私产变成行业基础设施。
当采集一小时的代价高于一个部件的毛利,数据就成了比硬件更贵的门槛。

图源:《2026中国具身智能数据产业分析报告》(第1页)
一、2026 年进入市场验证期,游戏规则变了
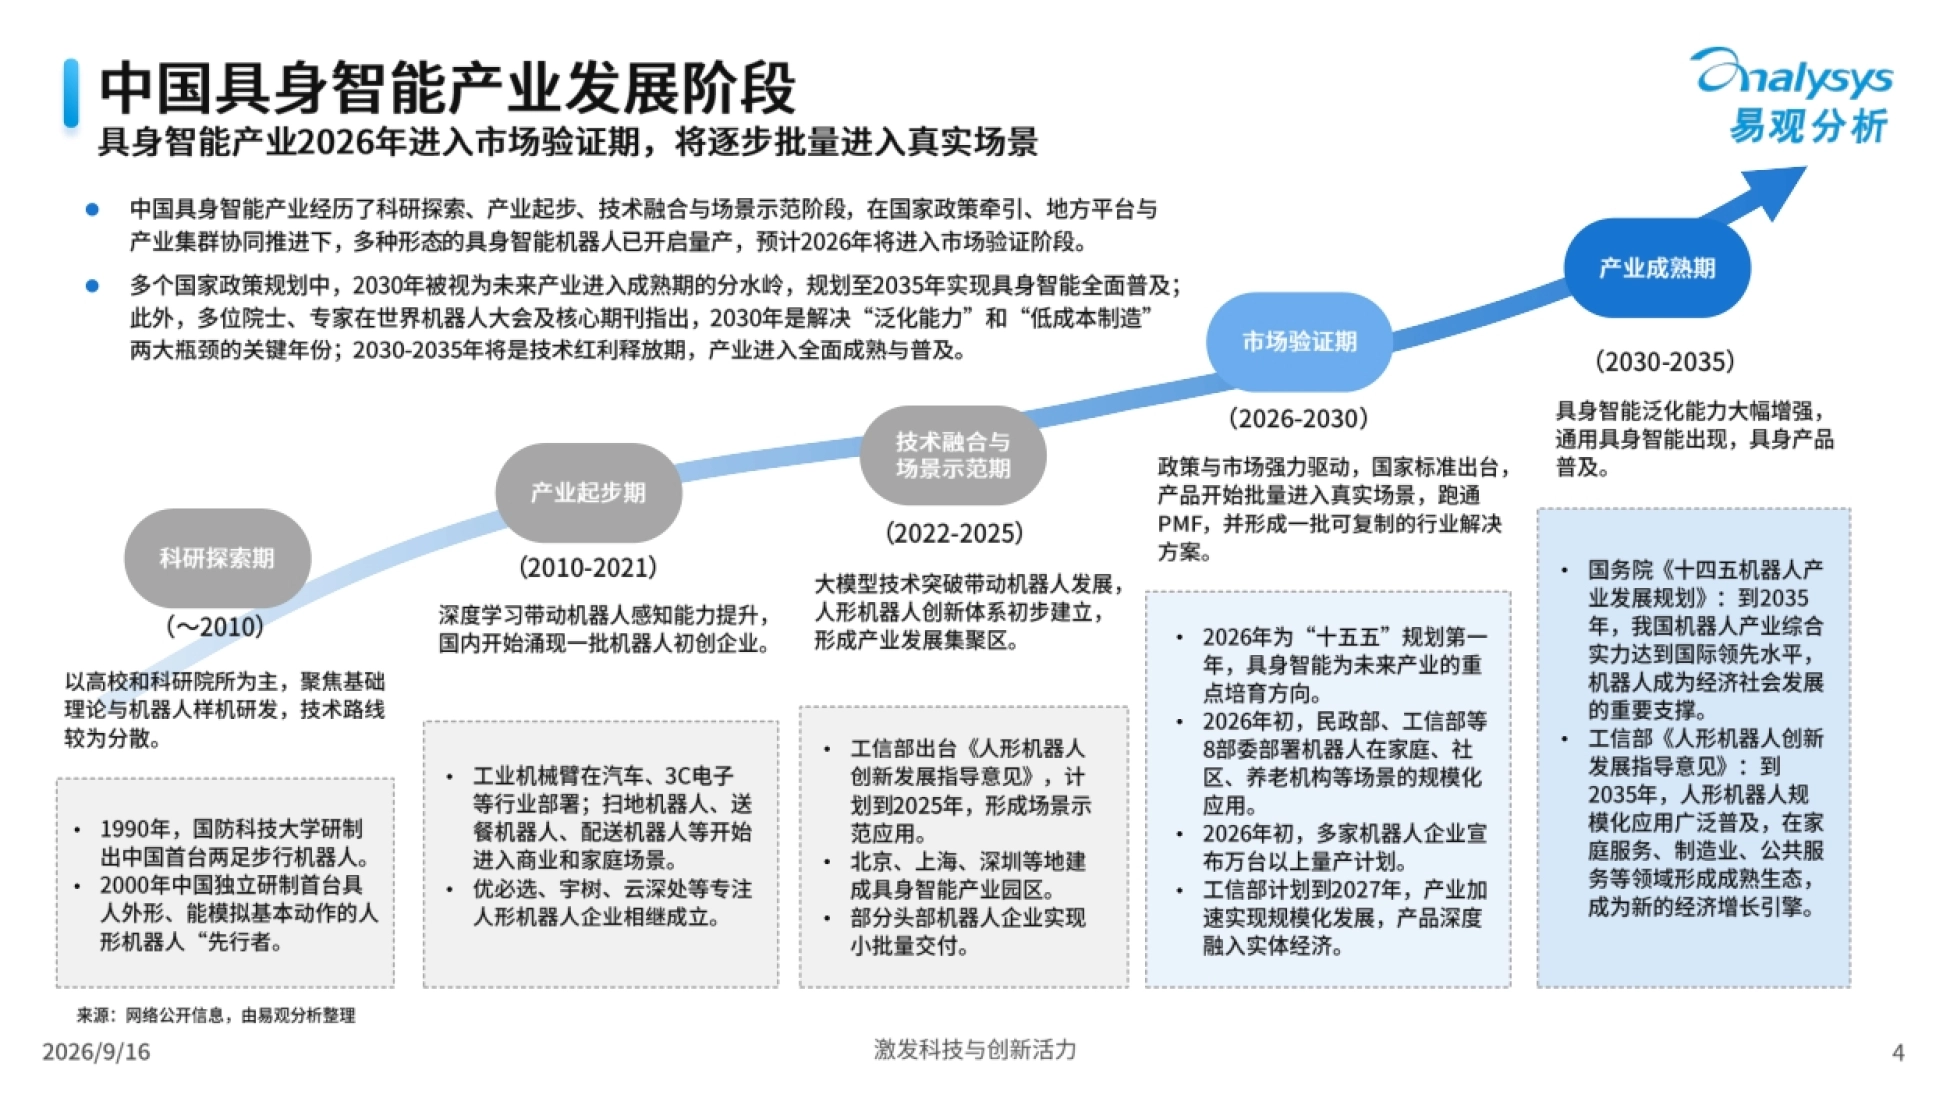
报告把中国具身智能产业划成五个阶段:科研探索期,产业起步期,技术融合与场景示范期,2026 到 2030 年的市场验证期,' 以及 2030 到 2035 年的产业成熟期。
市场验证期的定义是:政策与市场强力驱动,国家标准出台,产品开始批量进入真实场景,跑通产品市场匹配,' 并形成一批可复制的行业解决方案。2026 年又是十五五规划第一年,具身智能被列为未来产业的重点培育方向。
报告列了几个时间点:2026 年初民政部、工信部等 8 部委部署机器人在家庭、社区、养老机构等场景规模化应用;' 多家机器人企业宣布万台以上量产计划;工信部计划到 2027 年产业加速实现规模化发展。
值得注意的是报告的清醒:多位院士与专家在世界机器人大会上指出,2030 年是解决泛化能力与低成本制造两大瓶颈的关键年份,' 2030 到 2035 年才是技术红利释放期。
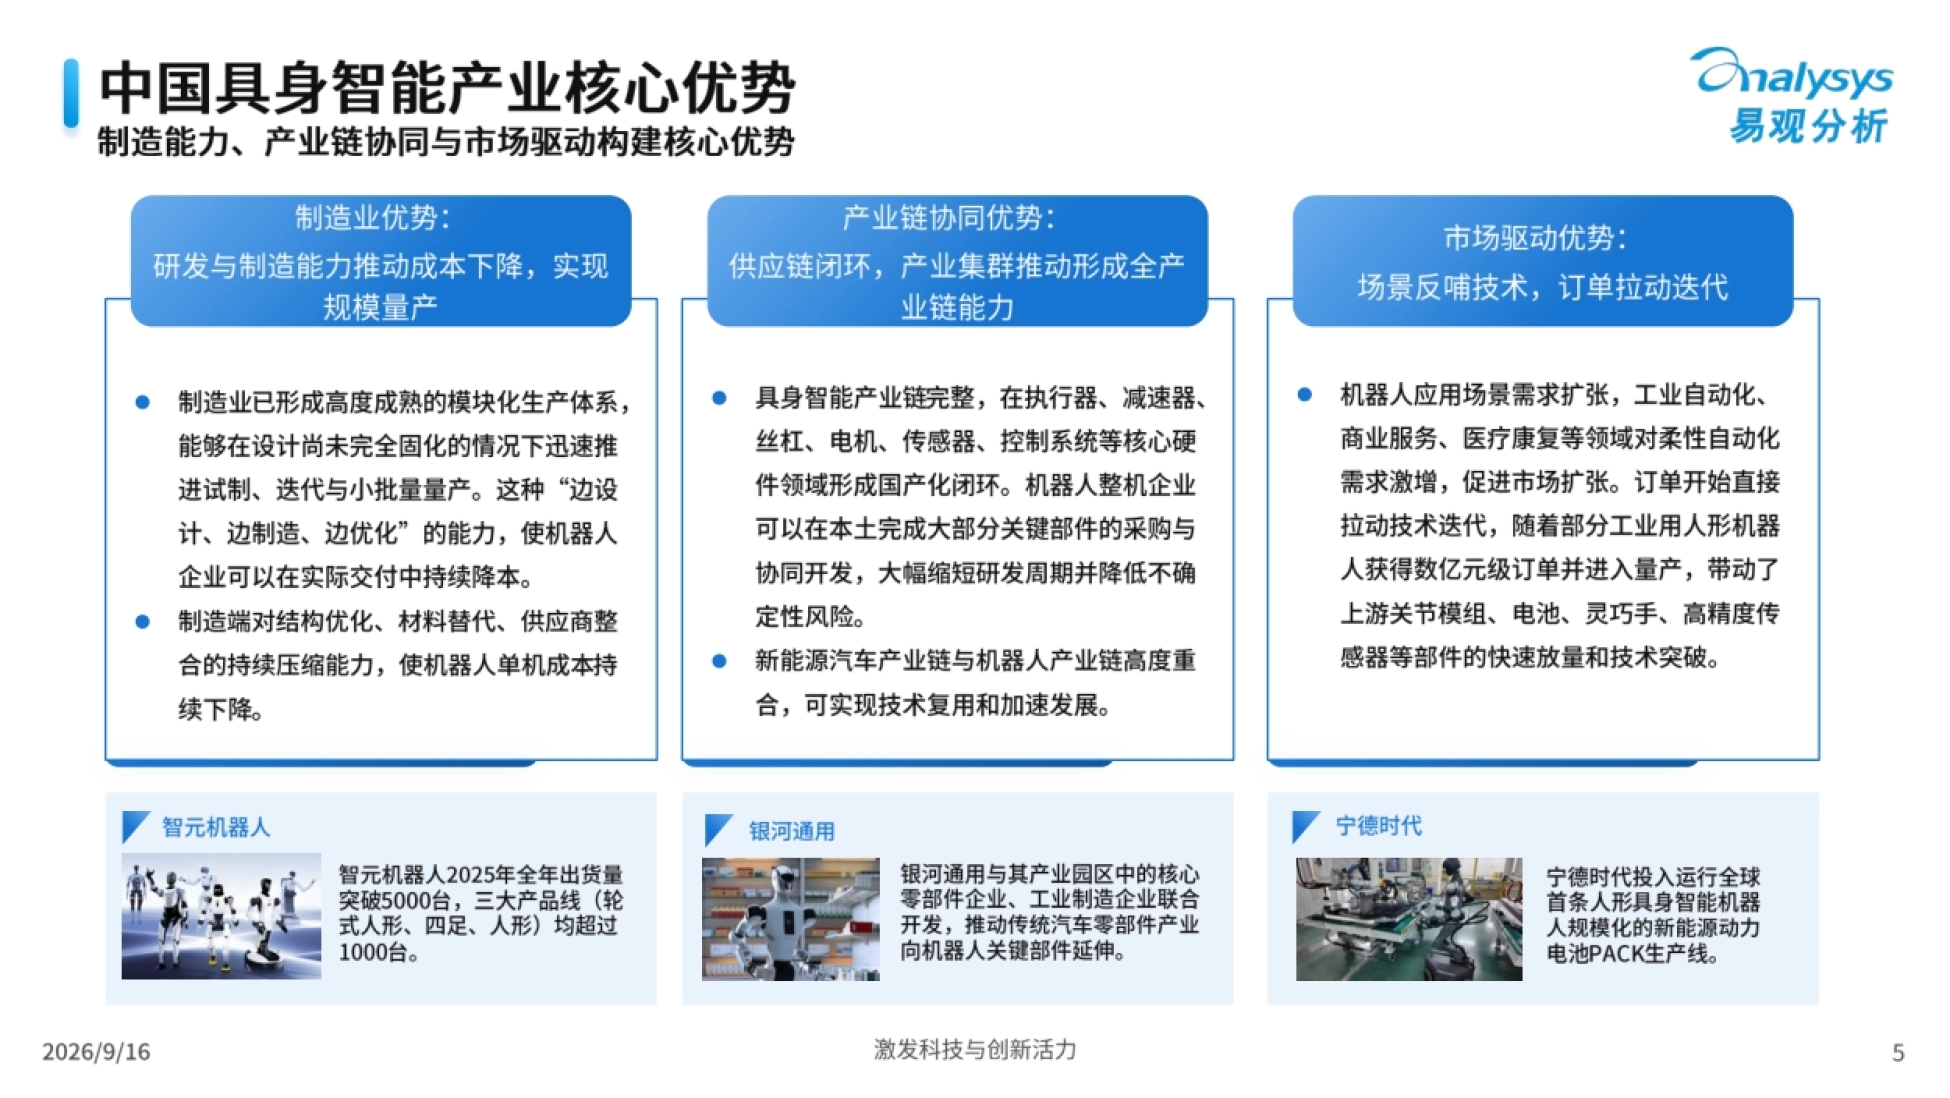
它的三重优势判断也很务实:制造业优势让成本持续下降,产业链协同让执行器、减速器、丝杠、电机、传感器形成国产化闭环,' 市场驱动让订单反哺迭代。
产业竞争的分水岭,从能不能造出来,挪到了能不能跑通场景。
图源:《2026中国具身智能数据产业分析报告》(第2页)
二、具身数据和互联网数据不是一个物种
报告对具身数据的定义很精确:物理世界交互的多模态记录。它有三个核心特征,每一个都跟互联网文本、视频数据不共戴天。
第一是物理交互性。数据必须包含力、触觉、形变、摩擦等真实物理属性,互联网上已有的图文视频一律不通用,' 一段演示视频再清晰,也带不出一牛顿的摩擦力。
第二是多模态强耦合。视觉、本体姿态、触觉力觉、音频、语言指令必须在同一条时间轴上精确对齐,差一帧就报废。第三是时序连续性。数据以状态与动作的序列构成轨迹,是行为克隆与模仿学习的核心载体。
正因如此,具身数据从训练副产品变成了产业核心燃料。报告的说法是,当前产业正从硬件能力驱动转向数据规模与闭环驱动,' 但高质量、可跨本体复用、可评测的物理交互数据依然稀缺,尤其是失败样本与接触细节。
互联网数据教模型看懂世界,具身数据教模型动手改变世界。
图源:《2026中国具身智能数据产业分析报告》(第3页)
三、三重制约:量、质、异构互为因果
报告把数据瓶颈拆成三个维度,并且强调三者互相强化,不是单点问题。量的问题叫总量断档。百万小时级的需求对应的现实是不到 5% 的积累,根因是高质量、大规模、低成本这个不可能三角没被打破。
真机数据质量高但单小时成本 500 到 1000 元;无本体数据便宜但要重定向、缺力觉;仿真数据无限但有迁移偏差;' 互联网视频规模大却没有动作标签。
质的问题叫仿真与真实的鸿沟。斯坦福那份报告给出的 89.4% 对 12% 是最直观的证据。' 报告进一步指出行业数据集过度干净,系统性丢弃失败样本与长尾场景,模型泛化靠运气;标注粒度不统一,脏数据进、脏模型出。
异构的问题最容易被低估。各家关节数、坐标系、控制频率不同,一家的数据没法直接训练另一家的模型,换本体等于重采、重标、重训;' JSON、Parquet、ROS bag 等格式并存,跨平台不可拼接;各训练场的数据尚未连接。
换一台机器人就要重采一遍数据,这才是这个行业最贵的隐形成本。
图源:《2026中国具身智能数据产业分析报告》(第4页)
四、破局四条腿:造、治、用、通
报告给的解法是系统工程,四条腿缺一不可,名字也很短:造数据、做对数据、转飞轮、通数据。
造数据解决量。本体厂商依托量产机器人规模在真实场景持续采集,以真机数据锚定质量基线;仿真厂商构建高保真物理引擎与场景资产库,' 用合成数据覆盖长尾与极端场景。两条路线互补,真机保真,仿真扩边界。
做对数据解决质。数据从采集完成到可训练可用,中间要过标注、清洗、质量评估。要建立统一的标注规范,' 按任务级、片段级、关键帧级、接触级分级,并用自动化评测工具量化可训练性。
转飞轮解决数据与模型的循环。训练场把采集数据转化为模型能力,再把模型部署到本体上验证,执行中产生的新数据回流,' 形成采集、训练、部署、回流的闭环。
通数据解决异构。建立跨本体、跨平台的数据格式标准与接口规范,通过交易平台与合规机制促进高价值数据流通,' 让数据从企业资产变成行业基础设施。
四条腿里最难的不是采数据,是让采来的数据能被别人的机器人用。
图源:《2026中国具身智能数据产业分析报告》(第5页)
五、六种商业模式:最成熟的边际成本最低
报告梳理了六类并行模式:数据集产品销售、定制化数采项目、数采硬件销售或租赁、仿真 SaaS 订阅、数据要素交易、' 全链路服务与训练场运营。成熟度和边际成本几乎是一条反比曲线。
仿真 SaaS 最成熟,边际成本极低,靠合成数据做规模效应,核心壁垒是引擎精度与生态标准,代表企业包括群核、光轮、无问。' 定制化数采项目也成熟,是真机保真的主流做法,但边际成本高,收入难复制,代表是智元、觅蜂、宇树。
数采硬件销售或租赁处在成长期,卖设备加数据回购,边际成本中等,代表是鹿明、帕西尼。' 治理与标注是传统标注的延伸,人力密集,按工时和条数计费,代表是海天瑞声、景联文。
数据交易处在成长期到极早期之间,核心壁垒是确权、合规与稀缺数据集;训练场运营更早,重资产、回报周期长,' 需要物理空间与全链路整合能力。
这份报告的原文件放在运营动脉(www.yydm.cn)上,图表、口径说明和样本量都写得很清楚。
想看原文的完整版,搜标题就能打开,图表和数据附录都是齐的,不用注册。
边际成本越低的模式越成熟,这是数据生意绕不开的经济学。

图源:《2026中国具身智能数据产业分析报告》(第6页)
六、三条采集路线:真机保真、无本体铺量、仿真扩边界
采集是价值链的物理入口。2026 年的格局是三线并行:真机遥操作、便携无本体采集、仿真与数据合成。' 互联网视频蒸馏只用于预训练,不构成物理采集,报告没把它算进来。
真机遥操作质量最高,具备真实摩擦力与碰撞动态,无需跨本体映射,但成本也最高,500 到 1000 元每小时,' 受本体数量、场地与人力限制,规模扩展性弱。它用于复杂精细操作、最终场景验证和模型微调基准。
无本体采集靠可穿戴设备记录人体动作,成本降到真机的三分之一左右,行业参照 200 到 400 元每小时。' 它存在人体到机器人的跨本体重定向鸿沟,但结合众包后产能容易进入百万小时级。
仿真与数据合成遵循合成加真机校准的迁移逻辑,前期引擎与资产投入高,一旦搭建完成边际成本趋零,' 适用于大规模预训练增广和极端、危险场景模拟。
报告引用觅蜂创始人的判断:仿真需要购买数字资产、建模、调用 GPU 渲染,而无本体设备规模化后,' 部分场景下单小时真实数据的成本已经低于仿真。
真实数据变便宜的那一天,仿真会退回它最该待的位置:边界场景。

图源:《2026中国具身智能数据产业分析报告》(第7页)
七、训练场:七十多座已建成,两千五百台在跑
报告统计了一组少见的行业基建数据:70 多座训练场已建成启用,另有 40 多座在建或规划;覆盖 23 个以上省份;' 已部署机器人 2500 台以上;总面积 28 万平方米。
区域分布很不均衡:长三角 36 座,珠三角 12 座,中部 12 座,京津冀 10 座,成渝 6 座,其他地区 24 座。' 省级层面浙江 12 座、江苏 11 座、广东 10 座、北京 8 座、上海 8 座,集群特征明显。
训练场的价值在于把固定成本变成可变成本:中小企业不必自建采集设备与场地,按需租用即可。' 同时它承担闭环飞轮的中转站角色,数据在这里变成模型能力,再回到本体上验证。
报告也点出了当前的阶段判断:训练场整体仍处起步期,重资产、回报周期长,头部国资中心与云厂商正从单点采集走向全链路运营。
训练场不是办公室,它更像这个行业的公用水电,谁接入谁就省一笔固定资产。

图源:《2026中国具身智能数据产业分析报告》(第8页)
八、五家样本:数据生意的五种打法
报告拆了五家典型企业,每家都给出了优势与挑战,这部分比结论更有参考价值。
觅蜂科技 2026 年 2 月从智元拆分独立,创始人判断模型没有强壁垒、数据才是壁垒。它的 MEgo 设备累计下线 2 万台,' 累计产出超 100 万小时数据,覆盖 22 大类场景,无本体路线成本约为真机三分之一。挑战是千万小时产能需要 9 倍放量。
光轮智能 2023 年 1 月成立,走仿真合成加人类第一视角双主阵地,2026 年 3 月完成 10 亿元融资成为全球首个具身数据独角兽,' 5 月估值突破 20 亿美元。它的部分数据集复售倍数超 10 倍,一季度新增订单 5.5 亿元。
无问智科的世界模型加数据工厂路线,公开披露在线强化学习让仿真成功率从 9.7% 提升到 79.8%,迁移真实机器人后任务成功率提升 50%,' 客户复购率超 80%,订单同比增长超 3000%。
群核科技是纯仿真路线,5 亿多个结构化 3D 场景、4.8 亿个带物理参数的 3D 模型,但具身业务收入仍在百万级、占比不足 1%;' 鹿明机器人主攻无本体采集,FastUMI 单条采集从 50 秒降到 10 秒,成本降至传统遥操作的 1/5,数据有效率从 70% 提升到 95% 以上。
五家里没有一家只靠采集活下来,都在往闭环和标品上走。

图源:《2026中国具身智能数据产业分析报告》(第9页)
九、趋势与机会:从卖数据到定义数据
报告给出的三个结构性变迁值得记住:能力层从数据规模转向数据价值,产业层从分散供给走向分化重构,' 终局资产形态从数据商品迈向数据要素。
六个趋势里有三个最硬。一是硬件入口化,卖设备即买数据,但真正的壁垒在软件粘性,数据格式绑定、云端平台依赖、评测基准锁定。' 二是标准化与标品化,竞争单位从小时数转向有效信息密度。
三是买方自建与中立性分化。头部本体厂商与基座模型公司正把数据生产内化,中立第三方在评测、开源社区、公共训练场里找空间。
报告还点出一个反常识的观察:产能军备竞赛之下,结构性过剩已经出现,原始数据贬值与高难数据稀缺并存,' 静态数据集的价值窗口正在收窄,有效信息密度乘以闭环增益才是新标尺。
八个机会里,第三方评测认证被排在第一位,理由很实在:既有评测机构既卖数据又办考场,中立性代价明显,' 谁能做出不卖数据、只办评测的独立第三方,谁就能吃掉这块中立性溢价。
完整 30 页图表与企业拆解见运营动脉(www.yydm.cn),搜报告名即可打开。
 广告
声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。如若本站内容侵犯了原著者的合法权益,可联系本站删除。